2026年这半年,芯片设计圈最热闹的词不是某个制程节点,也不是某款GPU,是"AI设计芯片"。
三个月里发生了几件事。7月,月之暗面用Kimi K3在48小时内跑完一整颗芯片的设计与验证,第二天新思科技和Cadence股价一起跌了8%上下。8月,OpenAI公布了跟博通合作、已经在台积电3nm上回片的第一颗自研推理芯片Jalapeño。10月Cadence发布Maestro模型组合,Synopsys的AgentEngineer开始商业化铺开,华大九天在HUG大会上发布了整套.aix智能体平台。
凑在一起看,结论比任何一个单独的爆炸性新闻都清楚:AI造芯片已经从"能不能"变成"多快、多贵"。工具层是真的,商业层是真的在兑现,国产也同步入场了。但有一件事到今天仍然没发生,从零设计一颗先进工艺的芯片并流片成功,架构和签核这两步仍然是人在做。
三个层面之外,还有一个横向的问题:AI 到底在流程的哪一段真正落地了。
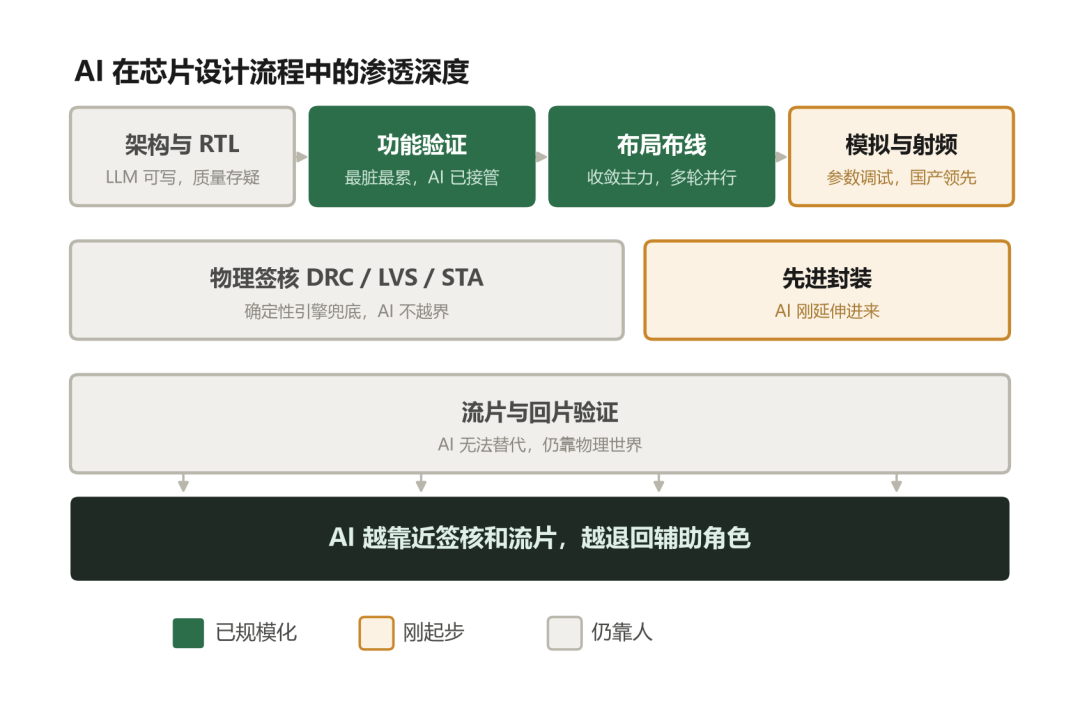
AI在芯片设计流程各环节的渗透深度
这张图的读法是从上往下看。功能验证和布局布线已经是绿颜色级的规模化应用,模拟射频是刚起步,架构决策、物理签核、流片回片三个环节仍然是人的地盘。这个分布不是偶然——越靠近签核,要求越确定、越可追责,概率模型越没法独立签字。
三大厂把AI从副驾推成了代理
今年上半年开始,Synopsys、Cadence、西门子EDA三家几乎同时把AI功能从"建议型"改成"代理型"。
先看动作最大的一家。9月30日,Synopsys宣布与OpenAI联合开发专用芯片设计模型GPT-Synopsys,双方共同研发、共享收入,跑在OpenAI托管的基础设施上。10月,AgentEngineer系列开始商业化推广,超过50个活跃客户,官方目标是年内GA。这套东西做的是长周期自主任务——验证闭环、模拟实现,甚至模拟版图的自主规划。
Cadence走的是另一条路。10月26日发布Maestro模型组合,底下托着AuraStack、ChipStack、InnoStack、ViraStack四个Super Agent,覆盖验证、数字实现、模拟设计、PCB和封装。Cadence给出的数字是:相比通用大模型,结果质量最多提升30%,token效率最多提升5倍。这些模型部分基于英伟达开源的Nemotron,用英伟达的OpenShell做智能体安全。
西门子EDA的Fuse agent核心逻辑是自验证——把大模型的输出拉回来,跟确定性的物理签核引擎对撞一遍,不通过就重来。这条路看起来保守,其实是对的。
有意思的是部署方式的分歧。Synopsys选OpenAI托管,Cadence强调整套可以装进客户自己的机房里。Cadence高级副总裁Paul Cunningham跟路透说得很直白:"提供AI模型的厂商,比提供芯片设计软件的厂商多得多。"芯片版图是客户最核心的资产,让它不出门是有意义的。

三大EDA厂商的AI代理布局与共同底座
值得单独说一句的是底座。三家的智能体都建在英伟达的agentic技术栈上。Nemotron 3 Ultra在开源模型里领跑agentic RTL编程,Vera CPU已经进了EDA验证场,第三方测的结果是Synopsys VCS和Cadence Jasper约1.5倍加速。英伟达还在2025年11月向Synopsys投了20亿美元,Grace Blackwell预计给EDA工作负载带来30倍性能。
模型层归英伟达,应用层归EDA厂商。这个分工在AI芯片和EDA两个行业同时出现,不是巧合。
商业上是真的在兑现
这是判断这件事成色最硬的证据,比任何发布会都可靠。
Synopsys FY26第三季度营收24.77亿美元,同比增长42%,其中Ansys贡献约7.11亿。核心的设计自动化业务增长8.5%,全年指引上调到96.9亿到97.4亿美元,积压订单109亿美元。Cadence 26Q2所有产品线两位数增长,核心EDA增长18%,IP增长超40%,积压订单81亿美元创历史新高,全年营收增速指引上调到19%。西门子FY26第三季度EDA业务增长30%,系统级客户贡献的营收占比从两年前的10%到20%提升到30%以上。
单点数字上,DSO.ai采用者的年合同价值提升约20%。AI工具不是免费附赠,芯片公司愿意为它多付钱。
更有分量的是晶圆厂认证。2026年9月,Synopsys和西门子EDA拿到台积电A14工艺认证,Cadence的数字全流程、签核流程和定制模拟流程拿到A14/A16认证。晶圆厂认证是硬门槛,意味着AI工具产出的结果可信、能进签核流程、能用于真正的先进工艺设计。这一关过不了,前面的所有提效都是空转。
案例:Kimi vs OpenAI
这是今年最需要讲清楚的一件事。
7月Kimi K3展示的48小时自主设计芯片,第二天让新思盘中一度跌超12%、收盘跌约8%,Cadence单日跌7.85%。一个多月后OpenAI公布Jalapeño实测数据,同样叙事,这两家反而涨了。
市场学会分辨"概念验证"和"流片"了。

Kimi K3与OpenAI Jalapeño对比
Kimi K3那颗芯片的官方定性是"early proof of concept"。GitHub上那个nano-kpu仓库第一句就写着"This is a demonstration of Kimi K3, not an official project by Moonshot AI",7月23日上传完代码就再没更新过。技术上:45nm学术开源单元库,146万个标准单元塞进3.98平方毫米,100MHz,片上SRAM不到0.3MB,13个模块,INT4 MAC阵列带片上反量化,仿真吞吐8721 tokens/s。
关键是它没做布局布线,没做物理验证,没流片。仓库里写得很清楚。它证明的是智能体能在受限条件下自己跑完一个从架构到时序收敛的闭环,但跟今天3nm加速器差着两个世代、几个数量级。顺带一提,从K3到Jalapeño,OpenAI还顺手从零写了个类Triton的编译器MiniTriton。
Jalapeño是另一回事。2024年中立项,2025年11月流片,2026年8月25日在Hot Chips公布实测数据,前后不到两年,架构到流片9个月,行业常规是18到36个月。台积电N3P,跟博通联合开发,6栈HBM4共216GiB、带宽15.4TB/s,额定功耗700瓦、实测持续压在550瓦以下。SemiAnalysis的InferenceX基准上,每瓦吞吐是GB300的1.53到1.9倍,DeepSeek R1上延迟从5.99秒压到1.65秒。研发费用大约35到70亿元人民币。工程样品已经在实验室跑OpenAI自己的模型,计划2026年底小规模部署。
但Jalapeño也不是AI独立设计的。OpenAI用自家的Codex、GPT-Astra加速验证和PPA优化,BF16乘法器面积优化了56%——AI参与的是探索实现方案、缩短验证循环,底层物理验证、签核、先进封装,仍然由商业EDA和确定性工具完成。
一句话概括这两个案例的区别:K3想证明"AI可以不用EDA巨头的工具",Jalapeño作为一颗有实际落地的芯片,依然深度绑定商业EDA,证明的是"AI能让芯片设计更强"。
三处要打折的地方
第一,所有加速比都是厂商自测。50倍验证速度、15倍生产力、5倍token效率,都来自厂商自己的流程和自己的口径。Cadence自己的新闻稿都没写清测了哪些设计、基准模型是哪个、QoR怎么打分。到今天为止,还没有独立团队在生产设计上复现过这些数字。芯片流片之后改一次的代价太大,这种信任只能一次次流片换,不会靠发布会换。
第二,专利风险被摆在了台面上。佛罗里达大学的Domenec Forte和剑桥的Simon Moore提出:如果AI生成的版图侵犯了现有专利,可能有上千款芯片在无人察觉时受影响。这个问题在智能体自主性提高之后只会更尖锐,因为一次自动探索产生的版图量级是人工做不到的。
第三,Synopsys在砍晶圆厂制造过程控制软件。4月到5月之间通知了包括三星、SK海力士、铠侠、Qorvo在内的十多家客户进入EOL,只保留维护支持,然后把工程人力和资源全部转向AI驱动的EDA工具。这个动作本身就说明它把AI视为唯一的增长曲线——成了就是对的,不成没有退路。Cadence在8月底CadenceLIVE 2026上提出的是"自我加速的正循环":一边Design for AI帮客户造更强的AI芯片和基础设施,一边AI for Design提高自己的研发生产力。逻辑一样。
AI造芯的现状与边界
工具层已经规模化,并且拿到了晶圆厂认证。商业层在EDA厂商的合同价值里真实体现,国产厂商同步入场,而且在模拟、面板显示这类场景跑得比海外还快——因为这些场景本身验证密集、试错密集,正是AI擅长的。
还没做到的只有一件:从零设计一颗先进工艺的芯片并流片成功。那一步仍然是人在做架构和签核,AI负责把那几周的脏活压缩到几天。
下一个观察点,是这些工具在2026到2027年的量产项目上会不会真正独立跑通一轮完整签核。厂商说自己是L3、L4、L5 autonomy,Cadence的Rob Knoth在Computex上也只敢说"某个领域的有界L5","大部分技术我认为是高级L4"。等真正有客户敢签的字,就知道到哪一级了。