统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
近期的像素空间建模提供了另一条路:JiT 等工作表明,图像生成可以不依赖 VAE、直接在像素上进行。但将这一范式扩展到视频并非易事:视频生成通常依赖 3D VAE,视频理解则通常用图像编码器逐帧处理,两者表示时间维度的方式不同,如何设计理解与生成共用的视频接口仍是一个开放问题。
为此,英伟达与滑铁卢大学提出 PixelUMM,一个直接在像素空间中统一图像与视频理解和生成的无编码器模型。

论文标题:PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation
项目主页:https://nv-tlabs.github.io/PixelUMM
论文:https://arxiv.org/abs/2609.38597
开源代码:https://github.com/nv-tlabs/PixelUMM
开源模型:https://huggingface.co/nvidia/PixelUMM
论文作者:魏聪(Cong Wei)、Xuanchi Ren、Bryan Chu、Weiming Ren、Huan Ling、Jiahui Huang、Laura Leal-Taixé、Sanja Fidler、Wenhu Chen、Zian Wang、Jay Zhangjie Wu
作者单位:NVIDIA、滑铁卢大学
PixelUMM 将图像切分为空间 patch、将视频切分为时空 tubelet,理解和生成都使用这种表示,并且仅通过一层线性投影就把原始像素接入共享的多模态主干网络。主干采用 Mixture-of-Transformers 架构,理解与生成各有一套参数,但共享同一个注意力。模型以自回归方式预测文本,同时把 JiT 式的干净像素预测扩展到视频,用像素空间的 flow matching 生成图像和视频。

实验表明,PixelUMM 在图像与视频的理解和生成任务上均取得了具有竞争力的性能。论文还对解码器设计、时空 patch 大小等关键设计选择进行了系统的实证研究,为未来的像素空间统一多模态模型提供参考。
1. Pixel Space 视频生成效果
以下视频均由开源的 PixelUMM 模型生成:832×464 分辨率,96 帧(4 秒,24 fps)。所有像素都由模型直接输出,不经过任何 VAE 解码器。


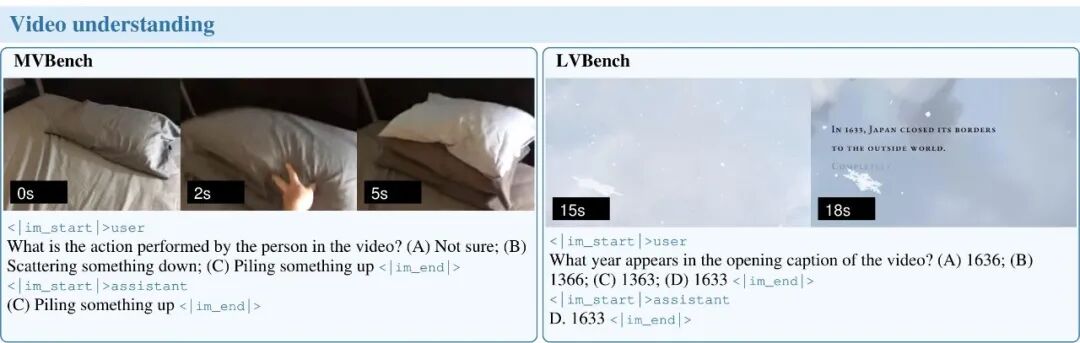
PixelUMM 的图像生成与理解与视频理解:

2. 模型架构
PixelUMM 是一个原生的统一多模态模型,直接在像素空间工作,既不使用预训练视觉编码器,也不使用基于 VAE 的潜空间 tokenizer。它采用 Mixture-of-Transformers(MoT)架构:理解专家负责文本预测和视觉理解,生成专家负责图像和视频生成。

原生像素接口。图像被划分为互不重叠的 p×p patch,视频被划分为 τ×p×p 的 tubelet。也就是说,图像做 2D patchify,视频在时间、高度、宽度上联合做 3D patchify。
PixelUMM 使用 p=16、τ=4:每个图像 patch 展平后是 16×16×3 = 768 个数值,每个视频 tubelet 是 4×16×16×3 = 3072 个数值,并且都只经过一层简单的线性层,就映射到 Transformer 的隐藏维度。
理解与生成各有一套独立的线性层(img_und_linear_proj / img_gen_linear_proj,video_und_linear_proj / video_gen_linear_proj):干净的图像和视频经由理解投影输入,被加噪的生成目标经由生成投影输入。
在输出端,每种模态都使用一个简单的线性头,实现为 RMSNorm 加一层反方向的线性投影,分别输出 16×16×3 的图像 patch 或 4×16×16×3 的视频 tubelet,再通过 unpatchify 还原为像素。输出投影在多模态训练前做零初始化。因此,PixelUMM 没有视觉编码器(VE)、没有 VAE,也没有离散视觉 tokenizer:像素与主干网络之间只有单层线性投影和确定性的 patchify / unpatchify 操作。

无显式时间步条件。PixelUMM 去掉了显式的时间步嵌入和以时间步为条件的 AdaLN。去噪网络只接收加噪像素,没有单独的时间步输入,由模型自行从像素中推断噪声强度。
Mixture-of-Transformers 主干。PixelUMM 以 Qwen3 的 decoder-only Transformer 初始化,在理解专家和生成专家之间做 token 级的硬路由。每个 block 都有各自路由的归一化层、QKV / 输出投影和 FFN,而所有 token 都参与同一个多模态自注意力。文本和干净的视觉 token 走理解路由,加噪的视觉 token 走生成路由。
统一的多模态序列。四类核心任务都被序列化为 ChatML 对话格式,视觉输入和生成目标占据对话中的原始像素 token 区间:理解任务使用干净的视觉输入,生成任务使用加噪的目标。上:图像理解(I2T)与视频理解(V2T);下:文生图(T2I)与文生视频(T2V)。视频理解中的时间戳标示了各视频块的时间位置。

广义因果注意力。文本内部是因果注意力,每个图像或视频块内部是双向注意力,后面的块能看到前面的所有块。生成时,加噪目标能看到 prompt 和整个目标块,前面的上下文看不到目标。与 BAGEL 不同,序列里只有文本 token 和原始像素 token,没有 VAE 和 ViT 特征。
训练目标。文本部分沿用 BAGEL 设计,只对 LLM 回复计算交叉熵损失。像素部分沿用 JiT 设计:模型直接预测干净像素(x-prediction),但损失在速度空间(v-loss)中计算。总损失是文本、图像、视频三项损失的加权和,每个训练阶段使用不同的权重。
3. Empirical Findings
像素空间统一模型的经验发现
论文围绕 8 组对照实验(F1–F8),总结了像素空间统一建模的设计经验。
F1:图像 patch 大小
在相同的序列长度预算下,32×32 patch 每步能处理 4 倍的图像,但 16×16 patch 的图像生成损失始终更低。更强的空间压缩会让图像生成更难学习。

16×16 与 32×32 patch 的图像生成训练损失。

两种 patch 大小在训练 6K、10K、15K 步时的生成结果。
F2:视频 patch 大小
对比 p32/t4、p32/t2、p16/t4、p32/t1 四种 tubelet 配置:时空压缩越强,视频生成损失越高。最终模型采用 p16/t4,与 Wan2.2 等常见视频 VAE 的压缩比例保持一致。

四种 tubelet 配置的视频生成训练损失。

四种配置在相同 prompt 下的生成帧。
F3:Patch 伪影
使用线性输出头时,天空、墙面等平滑区域可能出现轻微的 patch 网格,CFG 越高越明显。论文对比了三种卷积输出头:Wan 式“上采样 + 卷积”的边界最干净,但训练损失更高,画面也更模糊;PixelShuffle 则在训练损失和伪影抑制之间取得了最好的平衡。需要注意的是,开源模型仍使用线性输出头。

线性输出头在平滑区域留下的网格伪影。

三种卷积输出头的结构。

各输出头的训练损失。

空间 patch 边界和时间 tubelet 边界的伪影强度。

同一 prompt 下各输出头的逐帧放大对比。
F4:像素空间与 VAE 空间
两者的梯度范数相近,训练动态相似;像素空间训练偶尔会出现损失尖峰。两种损失在不同空间中度量,数值差距并不说明像素空间学得更快。

像素空间与 VAE 空间的训练损失和梯度范数。
F5:模型规模
8B 模型达到相同损失所需的训练步数,约为 1.7B 模型的 1/3。

1.7B 与 8B 模型的 MSE 和 CE 损失。
F6:计算规模
GPU 从 8 张增加到 128 张后,文本 CE 的收敛步数减少约 9 倍,像素 MSE 的收敛步数只减少约 1.3 倍。

8 卡与 128 卡训练的 MSE 和 CE 损失。
F7:多模态上下文条件
PixelUMM 将干净的图像和视频条件直接送入理解专家,就能实现图生视频和视频编辑,无需像 BAGEL 那样用 ViT 和 VAE 两套编码器分别处理条件。同时,加入这类条件生成任务后,PixelUMM 的理解能力没有出现系统性下降。

条件图像、视频进入理解专家,目标视频由生成专家生成。

PixelUMM 与 BAGEL 的视觉条件方式对比。

多任务微调前后的理解指标。

图生视频示例。

视频编辑示例。
F8:视频理解接口
PixelUMM 支持两种视频输入方式:
dense_mode 按 4 FPS 采样,每 4 帧组成一个 tubelet;
sparse_mode 按 1 FPS 采样,逐帧独立输入。两者每帧的分辨率预算相同(448²)。
对比结果显示,帧率更高的 dense_mode 并没有带来一致的提升:MVBench 仅提高 0.07 分,Video-MME 和 LongVideoBench 分别下降 0.22 和 0.68 分,LVBench 持平。也就是说,4 FPS 的 tubelet 输入与 1 FPS 的逐帧输入表现相当。

两种视频理解接口的对比。
4. Benchmark
论文报告了开源的 PixelUMM 模型(即 Joint Stage 2 训练后的 checkpoint)在图像理解、视频理解、图像生成和视频生成上的结果。PixelUMM 的整体表现与基线相当。需要说明的是,各模型的训练数据不同,这些结果不能说明哪种架构更优,也不能说明哪个模型收敛更快。各表中,深绿和浅绿分别表示最佳和次佳结果。
图像理解。PixelUMM 使用官方的 LMMS-Eval 协议评测。在计数任务上,PixelM 在 CountBench(94.30)和 PixMo-Count(73.03)上取得表中最佳结果。

视频理解。在表中的统一模型里,PixelUMM 在 MVBench(70.53)、Video-MME(57.33)、LongVideoBench(59.61)和 LVBench(40.41)四个基准上均取得最佳结果。PixelUMM 使用 sparse_mode 评测,最多采样 96 帧,Video-MME 不使用字幕;其他模型的分数取自各自的原论文。

图像生成。PixelUMM 在 GenEval 上得分 0.77,用 BAGEL 的长 prompt 改写后提升到 0.83;在 DPG-Bench 上总分为 85.74,与其他统一模型相当。

视频生成。PixelUMM 在 VBench 上的总分为 83.24(Quality Score 84.10,Semantic Score 79.80),与其他统一模型接近;其中 Imaging Quality(67.63)、Temporal Style(25.84)和 Overall Consistency(27.90)三项在统一模型中排名第一。


5. 总结
PixelUMM 用单层线性投影把图像 patch 和视频 tubelet 直接接入共享的多模态 Transformer,不使用 ViT 和 VAE,就统一了图像与视频的理解和生成,并取得与先进基线相当的性能。实验还表明,更弱的时空压缩通常带来更低的生成损失,卷积输出头可以抑制 patch 伪影。
未来可以探索更深度融合理解与生成的 MoE 架构,以及更大的 patch 和更长的 tubelet。
作者介绍
本文第一作者魏聪,滑铁卢大学博士三年级在读,导师为陈文虎教授,本工作完成于其在 NVIDIA 实习期间。个人主页:https://congwei1230.github.io/

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com