新智元报道
新智元报道

OpenAI还有数学发现没公开?
10月29日发布的《Cheeky Pint》访谈里,奥特曼透露:OpenAI在数学研究上的投入,还涵盖了许多尚未公开的发现。

主持人John Collison追问:还有那700个证明之外的成果吗?
奥特曼回答:
有,当然有。
近几个月,OpenAI的数学成果接连引爆热议。
成果公开后,研究者开始拆解公开的资料,理解其中思路,核查推导中的关键步骤。
而在生物学领域,AI提出的方案已经走上实验台。
模型分析数据、提出设计,研究者筛选方案、开展实验,再把实验结果反馈给模型,继续改进设计。
从核对数学推导,到验证生物学设计,人类与AI正在把每一轮的结果,变为下一步探索的起点。

谈到数学研究的投入,主持人给出了数亿美元的量级,奥特曼表示认可。
但他也补充,这笔投入,还包括未公开的其它发现。
至于这些成果该如何公开,奥特曼承认:其中存在两难。

奥特曼主张,重大基础科学发现应当公开。
奥特曼认为,人类理应拥有基础科学知识,重大科学发现应该向世界公布。
但科研人员的职业发展和成就感,很大程度上来自发现本身。
他希望找到一种方式,既让世界受益于知识的分享,也能够长期推动这些领域的研究者继续参与未来的科研。
成果公开之后,还需要帮助研究者读懂思路、核查推导,让这些发现成为后续研究的基础。

在GitHub上,数学研究者发起了独立修订项目oai-math-revised。

数学研究者发起oai-math-revised项目,协作修订OpenAI公开的数学研究手稿。
这个项目直指OpenAI一些数学手稿的两处短板:论述难懂,引用不全。
为此,项目发起者邀请学生、博士后、教授和数学爱好者共同参与,补充文献、理顺论述,识别并尽可能修正错误。
AI交出一篇数学论文,科研共同体还要把它变成别人读得懂、查得清、用得上的知识。
如何支持这些后续工作,也成为成果发布时需要考虑的问题。
OpenAI正在尝试调整成果的发布方式。
10月26日,公司将当天新公布的相关研究手稿定位为「原始研究数据」,并介绍了邀请外部专家牵头、组织团队解释结果等不同做法。

OpenAI将这些手稿定位为「原始研究数据」,并说明相关结果处于不同验证阶段。
其数学仓库也明确说明,相关结果处于不同验证阶段,部分尚未附有可由计算机检查的形式化证明。
手稿公开之后,解释、核查和修订还要继续。
让更多研究者读懂这些结果,确认哪些方法可以沿用,新的研究才能在此基础上展开。

在生物学领域,研究者正在主动把大模型用进自己的工作。
10月30日,Epoch AI发布了一组生物学预印本统计:
2026年9月受检的4922篇bioRxiv预印本中,846篇披露使用过大模型,占17.19%。
大约每六篇,就有一篇。

生物学预印本的大模型使用披露比例持续上升。(图源:Epoch AI)
2025年9月,这个披露比例为6.40%。一年后,它已接近同月专用AI工具的18.94%。
这些披露的环节涉及文献、写作、编程和研究分析等工作:
当月有190篇预印本披露,将大模型用于研究或分析,占全部受检预印本的3.86%。
按照Epoch的分类,这包括实验设计、数据标注和统计分析等;写作、文献综述、代码与计算,则分别列入其他用途类别。
Epoch这些统计数据显示:大模型已经参与科研的多个环节。
具体到一项研究,模型负责哪些工作,研究者又怎样判断、验证和使用它的输出?

最近公开的两项合作,展示了人类与AI如何接力推进研究。
10月21日,OpenAI、PerturbAI和Scripps Research公布了一项合作:
数千个由GPT-Rosalind驱动的智能体,分头分析来自数百万小鼠脑细胞的已有实验数据。
据团队报告,这轮数据分析与解释用了32分钟。
每个智能体围绕一种基因扰动,分析细胞反应、查找相关文献,再提出解释。
这些分析结果最终汇成一份推理图谱,把基因、细胞变化和可能的生物机制连在一起。
研究者可以沿着这份图谱,挑选下一步要检验的线索,继续设计实验。
有了线索,接下来还得让实验给出反馈。
在另一项研究中,生物技术公司Generate Biomedicines正在用AI设计蛋白质、研发药物。
10月27日,团队公布了借助Claude Code改造CAR-T受体的进展,他们想把受体内部传递信号的部分缩短,同时保留功能。
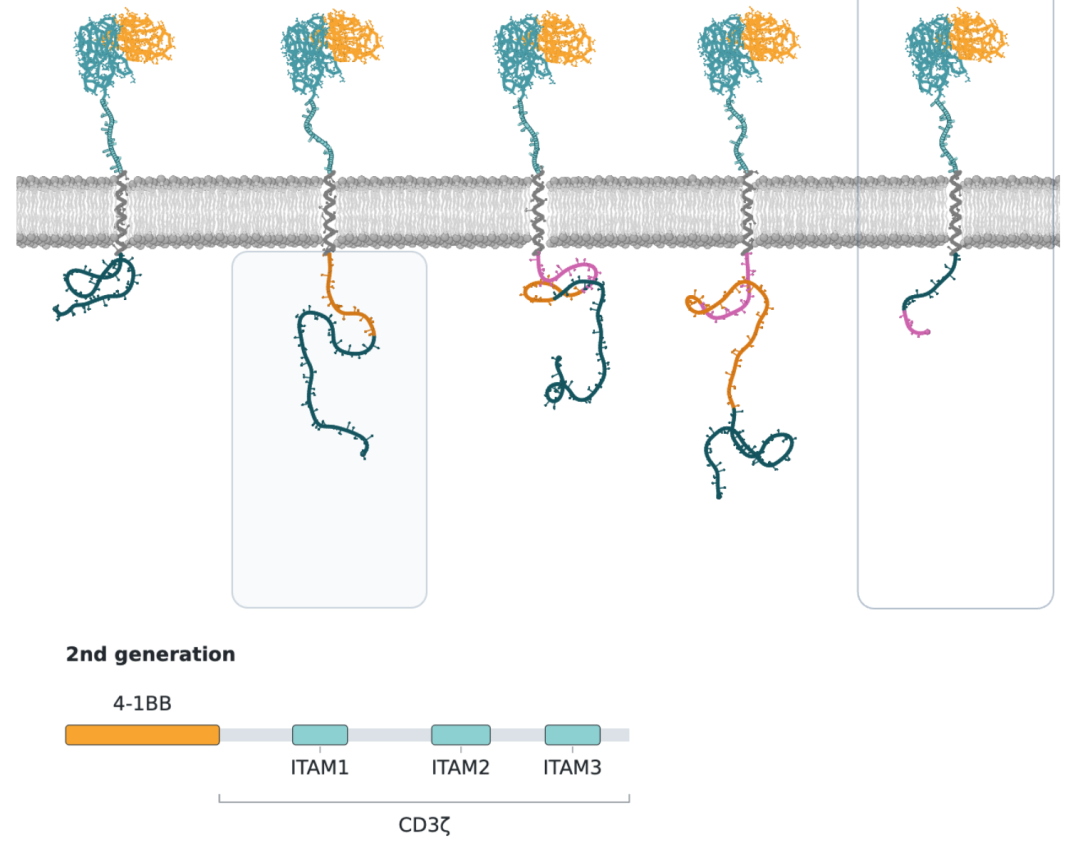
不同CAR受体的结构对比,图中灰色横带代表细胞膜。(图源:Generate Biomedicines)
CAR受体像T细胞的「识别和启动装置」:细胞外的部分识别目标,细胞内的部分传递信号,让T细胞作出反应。
研究者从模型参与设计的方案中,挑出186个做首轮实验。结果出来后,再交给系统,继续修改方案、做实验。
经过三轮设计和筛选,团队得到一个仅由45个氨基酸组成的信号结构,比用作对照的第二代CAR信号结构短约70%。
团队报告在体外实验中,使用相同剂量的mRNA,采用新设计的T细胞表面出现了更多CAR受体,杀伤目标细胞的能力也维持得更久。
这套设计,是在一轮轮实验反馈中逐步改出来的。

从一行行数学推导到一轮轮生物学实验,AI正在进入科研的更多环节。
它寻找线索、提出设计,再根据验证结果调整方案。
如果我们把目光投向人工超级智能(ASI),另一个问题随之浮现:AI做出的科研成果,能不能反过来加速AI自身的研发?
早在2025年,Google DeepMind已披露:AlphaEvolve将Gemini训练中的一项计算内核提速23%,使整体训练时间缩短1%。

AlphaEvolve发现的算法优化,已被用于提升Gemini的训练效率。(图源:Google DeepMind)
由AI提出、经过验证的优化方案,已经用来改进模型训练。
再往前一步,如果系统能够自主研发更强的下一代系统,再由下一代继续推动AI研发,就形成了RSI(递归自我改进)所设想的循环。
这样的循环若能持续,可能成为迈向ASI的一股推动力。
从一次局部优化,到持续推动新的发现,这条路仍有许多可能。
面向ASI的未来,人类与AI或许会以今天难以想象的方式共同探索。
而这一切,也许就从一次次尝试开始:更快地验证一个想法,更严谨地确认一项发现,让下一位研究者更早开启新的探索。
参考资料:
编辑:元宇