点击蓝字 关注我们
因为公众号平台更改了推送规则。记得点下右下角的大拇指“赞”和红心“推荐”。这样每次新文章推送,就会第一时间出现在订阅号列表里。
庖丁解牛,厉害的不是刀快,而是看得懂结构。
别人看到的是一整头牛,庖丁看到的是筋骨、关节和缝隙——所以别人是硬砍,他是顺着纹理下刀。
今天做 AI 知识库,也经常遇到同一头“牛”。
它叫 PDF。
PDF 看着清楚,AI 未必看得懂
人看一份 PDF,很自然:标题是标题,表格是表格,图片说明对应图片。
但机器看到的,可能只是一堆坐标、字体、线条和排版碎片。
结果就是:你以为给 AI 喂了一份技术文档,实际喂进去的是一锅乱炖——
文字顺序乱了,表格变成散装数字,标题层级丢了,页眉页脚混进正文;图片和说明分家,PPT 转出来像碎纸机现场。
这时候,你需要一把“文档处理刀”,先把它拆干净。
这把刀叫 Docling。
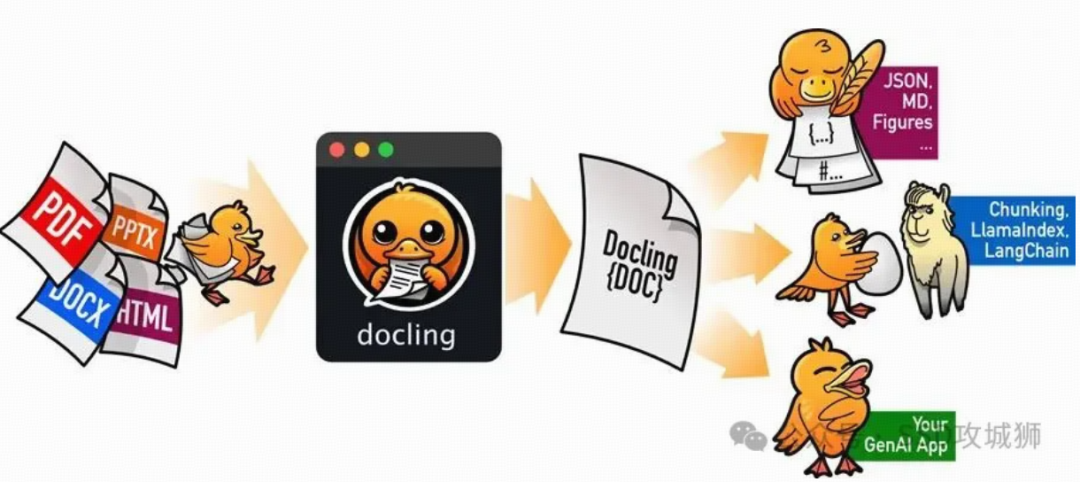
Docling 是一个开源文档转换工具,把 PDF、Word、PPT、Excel、HTML、图片等复杂文档,转成 Markdown 或 JSON,方便接入 AI 知识库、RAG、文档问答。
它不是大模型,也不是知识库系统。它做的是在知识库前面先拆文档。
拆的不是随便提取文字,而是尽量判断:哪里是标题、哪里是表格、阅读顺序怎么走、哪些页眉页脚可以忽略。
这就是它“庖丁解牛”的地方——不是切碎,而是顺着结构拆开。
举个例子。测试报告里有一张表:
温度 | 电压 | Fail Rate
低温 | LV | 2%
高温 | HV | 30%
如果解析出了问题,AI读进去,看到的可能是:“电压 Fail Rate 温度 LV 2% 低温 HV 30% 高温” 就会比较费劲。
用 Docling 先转一遍,表格结构、标题层级、段落顺序就能保留下来,后面的检索、总结、问答效果会稳定很多。
很多知识库不好用,不是模型不行,是第一步文档处理就已经歪了。
怎么用?
安装:pip install docling
命令行直接转:docling input.pdf --to md --output output
Python 调用:
from docling.document_converter import DocumentConverter converter = DocumentConverter() result = converter.convert("input.pdf") print(result.document.export_to_markdown())
体验的话命令行就够了;要批量处理或接入自己的 RAG 流程,用 Python API。
Docling 有用,但不是魔法棒。
如果原始 PDF 是扫描件、图片很糊、表格严重跨页、PPT 全靠视觉排版表达逻辑——转换后还是要人工抽查和清洗。
做 AI 知识库,不要只盯着大模型选型。模型再强,也怕吃进去的是乱的。
Docling 解决的就是这个很现实的问题:先把 PDF、PPT、Word 这些复杂文档,拆成 AI 更容易处理的结构化格式。
高端微信群介绍 | |
创业投资群 | AI、IOT、芯片创始人、投资人、分析师、券商 |
闪存群 | 覆盖5000多位全球华人闪存、存储芯片精英 |
云计算群 | 全闪存、软件定义存储SDS、超融合等公有云和私有云讨论 |
AI芯片群 | 讨论AI芯片和GPU、FPGA、CPU异构计算 |
5G群 | 物联网、5G芯片讨论 |
第三代半导体群 | 氮化镓、碳化硅等化合物半导体讨论 |
存储芯片群 | DRAM、NAND、3D XPoint等各类存储介质和主控讨论 |
汽车电子群 | MCU、电源、传感器等汽车电子讨论 |
光电器件群 | 光通信、激光器、ToF、AR、VCSEL等光电器件讨论 |
渠道群 | 存储和芯片产品报价、行情、渠道、供应链 |

< 长按识别二维码添加好友 >
加入上述群聊

长按并关注
带你走进万物存储、万物智能、万物互联信息革命新时代

微信号:SSDFans