> 本文来自社区投稿
一句话导读:改变 RSI 的基本演化单位,从任务转变为能力,有望从针对具体任务的局部优化,走向跨任务、跨模态的持续演化。
近日,来自深圳的深圳无尽递归智能科技有限公司提出全模态全任务递归自我改进框架 The Trinity,以能力作为基本演化单位,通过 Creator、Explorer 和 Evolver 三个角色的协作,推动环境生成与 Harness 协同进化。
该框架首先将任务分类为 Task Tree,然后根据测试轨迹分析出每个任务所需的能力,依据能力将 Task Tree 转换为 Capability Tree,最后沿着 Capability Tree 进化得到 Harness Tree。经过四轮 RSI,The Trinity 在 28 个训练基准和 18 个未见基准上的平均得分分别提升 34.1 分和 26.2 分,并初步展现了向真实机器人任务迁移的潜力。
这项工作为 Agent 从任务驱动的局部优化走向能力驱动的跨任务、跨模态持续演化,提供了一条新的探索路径。

论文标题:The Trinity: Capability-Driven Recursive Self-Improvement for Multimodal Agents
论文链接:https://arxiv.org/abs/2610.36077
代码链接:https://github.com/InfRec-Cardinal/The-Trinity
项目主页:https://trinity-rsi.github.io/
Hugging Face Daily Paper No.1:https://huggingface.co/papers/2610.36077
1. 多模态智能体递归自我改进的瓶颈与挑战
给智能体一个任务,让它执行、获取反馈、修改策略,再执行一遍。这是当前很多 Recursive Self-Improvement(RSI)工作的基本思路。围绕几个 benchmark 建立这样的反馈循环,分析失败轨迹,调整提示词、工具或执行流程,确实能够带来性能提升。但当我们试图把这套方法扩展到多模态长程交互任务时,问题开始变得复杂。
1. 环境构建:多模态任务不仅种类多,而且很难验证
从 ARC-AGI-3、交互游戏,到 GUI 操作、机器人导航和操作,不同任务有着完全不同的观察形式、状态空间、动作规则和成功条件。如果希望持续扩展训练任务,逐个构建和验证环境的成本就会迅速增加。
2. Harness 构建:人工迭代已经跟不上任务的复杂度
智能体能力越来越受到 Harness 的制约,而人工设计和迭代提示词、工具与执行流程,难以跟上任务复杂性与多样性的增长。
不过,把环境构建和 Harness 修改都交给智能体自动完成,也不意味着我们就找到了真正的递归改进机制。假设系统现在可以自动生成一百个任务,也能针对每个任务自动修改 Harness。它可能确实得到一百套更好的解决方案,但这些改进之间是什么关系?第一个任务学到的东西,能不能成为第二个任务的起点?
进而提出疑问:
经验如何组织? 围绕单个任务积累经验,容易过拟合,难以迁移;把所有经验塞进一个统一 Harness,又可能让不同任务的需求相互干扰。
改进如何演化? 即使每一轮都能产生新的策略,系统又该如何保留已有改进,让它们在后续迭代中被继承、修改,甚至针对不同需求产生分化?
任务数量的增加,不等于改进能够持续积累。这也是我们重新思考 RSI 驱动力的出发点。
2. 两个机制:协同进化与共享能力
我们更愿意把多模态智能的发展理解为一种由人类引导的 Agent 与 World 的协同进化。
World 提供任务与反馈,Agent 通过交互学习如何解决问题。过去,这个循环大部分由人完成:人选择任务、构建环境,再根据失败轨迹修改智能体。
如果希望让这个过程持续进行,至少需要两个机制。
机制 1:Agent–Environment Co-evolution,让环境与智能体相互推动
通过智能体与环境的协同进化,让环境根据智能体的表现生成和调整训练挑战,让智能体利用环境反馈持续优化 Harness。两者相互驱动,减少对人工构建环境和迭代 Harness 的依赖,使规模化的递归改进成为可能。
机制 2:Shared Capability Requirements,不同任务可能需要相同的底层能力
任务在模态、形式和目标上可能截然不同,却可能依赖相同的底层能力。例如,ARC-AGI-3 与 Micromouse 虽然任务形式不同,却都依赖准确的感知与状态追踪。
这意味着,一个任务可能需要多种能力,而同一种能力也可能服务于多个不同任务。 如果能够围绕这些共同需求组织经验,原本分散的任务反馈就有机会成为可共享、可迁移的学习信号。
如果能够从不同任务中找到共同的能力需求,就不必再把每个任务当成完全独立的学习目标。我们可以围绕这些共性积累经验,再根据不同任务的需求进行组合和特化。
这也是 Capability-driven RSI 的核心出发点。
3. The Trinity:从 Task-driven 到 Capability-driven RSI
基于前面的观察,我们提出了 The Trinity,将环境生成与 Harness 演化放进同一个 RSI 框架。
系统中一个模型包含三个角色:Creator 负责构建世界,Explorer 负责探索世界,Evolver 负责分析反馈并指导两者的改进。三个角色使用固定的基础模型,改进主要发生在 Harness 层面。
但这里最重要的变化,并不是简单地把三个角色组合起来,而是将系统的学习单位从 Task 转向 Capability。
1. Task Tree → Capability Tree:重新组织经验
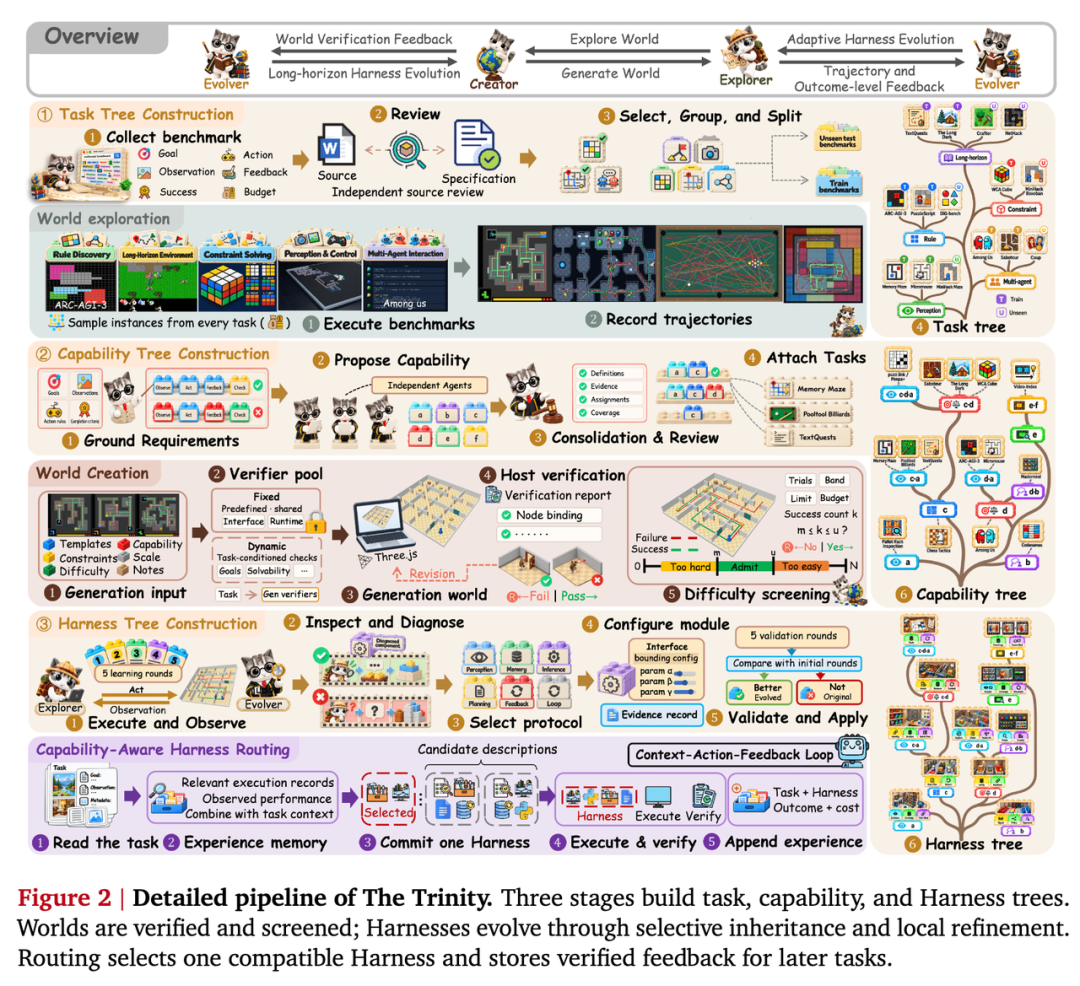
首先,我们收集不同类型的多模态任务,构建 Task Tree,并让初始 Harness 在这些任务上执行,得到可验证的交互轨迹。Evolver 根据任务定义和实际执行轨迹,分析任务需要哪些能力,以及失败发生在哪些决策环节。随后,我们不再按照原有任务类别组织这些经验,而是根据共享的能力需求,重新构建一棵 Capability Tree。同一种能力可以被不同任务共享,而一个任务也可以同时需要多种能力。因此,树上的路径代表的是能力需求的组合,而不是任务类别的从属关系。
这一步的意义在于:原本分散在不同 benchmark 中的经验,现在有了共同的组织依据。
2. Capability-Driven Real2Sim2Real:围绕能力生成训练环境
有了 Capability Tree,环境应该怎么生成?
传统的 Real2Sim2Real 往往需要针对特定真实任务构建对应的模拟环境。但如果我们的目标不是复刻任务,而是学习任务背后的共同能力,环境设计就有了另一种可能。
对于 Capability Tree 上的一个节点,Creator 会提取相关任务共同依赖的决策机制,生成更简洁、可验证的模拟世界。例如,几个任务都需要在行动前验证证据是否充分,那么训练环境就可以围绕这一决策过程设计,而不必完整复制原始任务的所有视觉细节、场景结构和动作规则。Explorer 在这些模拟环境中学习,而原始 benchmark 用于检验学到的能力能否迁移回去。
这里的关键不是让模拟环境越复杂越好,而是尽可能保留需要学习的决策机制,同时减少与它无关的复杂因素,得到更干净的进化信号。
3. Harness Tree:让已有改进成为下一轮改进的起点
Harness 可以拆分为 Perception、Memory、Inference、Planning、Orchestration 和 Loop 等不同协议模块。不同能力的提升,可能需要不同模块的配合。
在 The Trinity 中,Explorer 沿着 Capability Tree 逐节点演化 Harness。每个节点既可以选择性继承父节点已经学到的模块,也可以根据本节点的失败轨迹修改或增加模块。因此,当任务需要更多能力时,系统不必重新从零构建一套 Harness,而是可以在已有配置的基础上继续改进。不同分支也不必强行合并成一个全局最优解。它们可以共享已有模块,同时保留各自针对特定能力需求的修改。
经过多轮迭代,这些模块逐渐形成一棵 Harness Tree。Creator 也会根据环境验证失败持续改进自己的 Harness,并在每轮结束时整合已验证的模块更新,用于下一轮环境构建。
4. Capability-Aware Router:不同任务,选择不同的 Harness
Harness Tree 也带来一个很自然的问题:既然不同分支已经产生了不同的专业化配置,遇到新任务时,应该用哪一个?
我们进一步引入 Capability-Aware Harness Router。Router 根据任务的公开信息、候选 Harness 的能力描述,以及过去经过验证的执行经验,选择更适合当前任务的 Harness。它不需要提前知道任务的真实能力标签,也不需要把所有模块都装进同一个 Harness。
到这里,整个方法的逻辑才完整:任务提供能力需求,Creator 围绕这些需求生成训练环境,Explorer 根据反馈演化模块,Harness Tree 保留已有改进,Router 则负责把合适的配置用到新的任务上。
4. 实验结果
多模态任务:四轮 RSI,未见任务也在持续提升
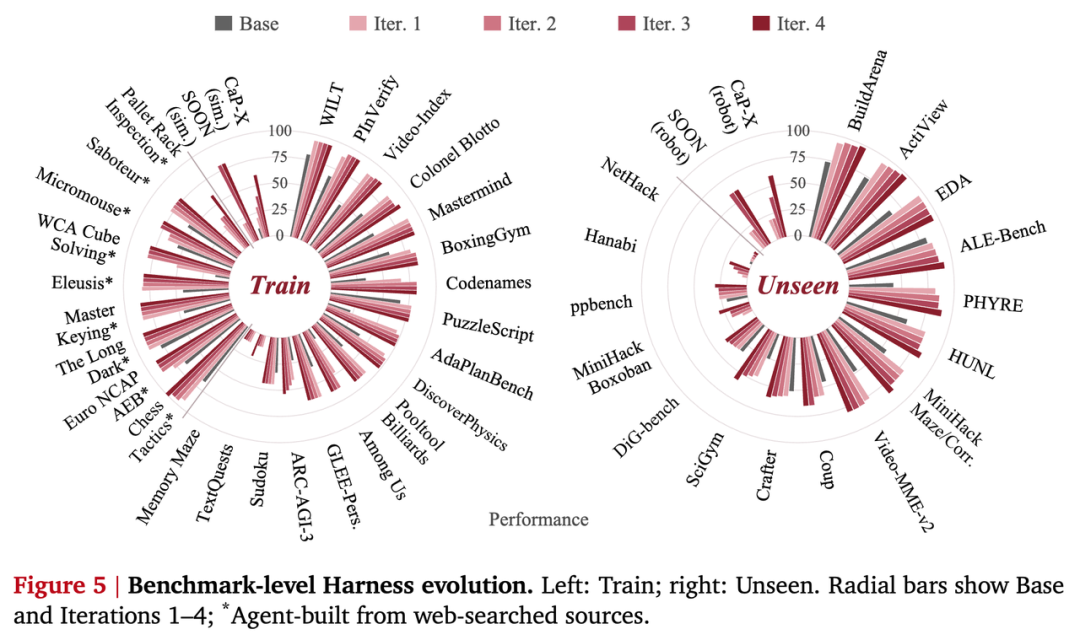
在 ARC-AGI-3、BuildArena、Video-MME v2、PHYRE、SOON、CaP-X 等 28 个跨模态、跨领域训练 Benchmark 上平均提升 34.1 分,在 18 个 Unseen Benchmark 上平均提升 26.2 分。
第一轮带来了最大的提升,但后续三轮仍然有收益,未见任务上的成绩也随迭代提高。当然,不是每个 benchmark 都会持续上涨,部分任务很早达到平台,个别任务还出现了小幅回退。但整体来看,系统能够在固定的能力树上多轮积累改进,并将其迁移到训练之外的任务。
Task vs. Capability:组织方式真的会影响最终学到什么


我们比较了不同的经验组织方式,以及 Capability-Driven Real2Sim2Real 带来的收益。
其中虽然 Sim 首轮构建成本更高,但环境可以在后续迭代中复用,推理成本也更低。这说明,相比单纯围绕任务优化,按能力组织经验,并针对共同能力生成训练环境,能够带来更好的跨任务迁移,证明了 less is more。
Agent as a Router:专业化之后,能不能选对 Harness?
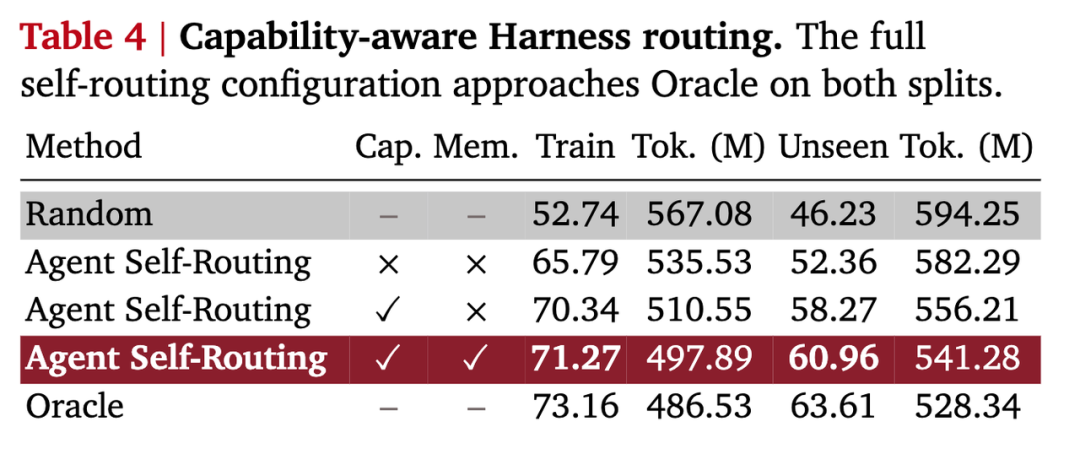
Harness Tree 允许不同分支各自优化,但如果使用时选错配置,这种专业化就失去了意义。因此,我们进一步比较了不同的 Harness 选择方式。这也解释了为什么我们不希望最终只得到一个越来越庞大的统一 Harness:不同任务可以依赖不同的模块组合,而选择本身也可以成为智能体需要学习的一部分。
Capability-Module Relationships:能力划分真的能指导模块设计吗?


我们首先分析了第四轮 RSI 后 29 个 Module 与六类 Capability 的关系,发现不同能力确实对应不同的模块偏好,Capability 不仅能用于组织任务,还能为 Harness 的模块选择与组合提供依据。
Embodied Transfer:在模拟环境里学到的东西,能否用到真实机器人上?
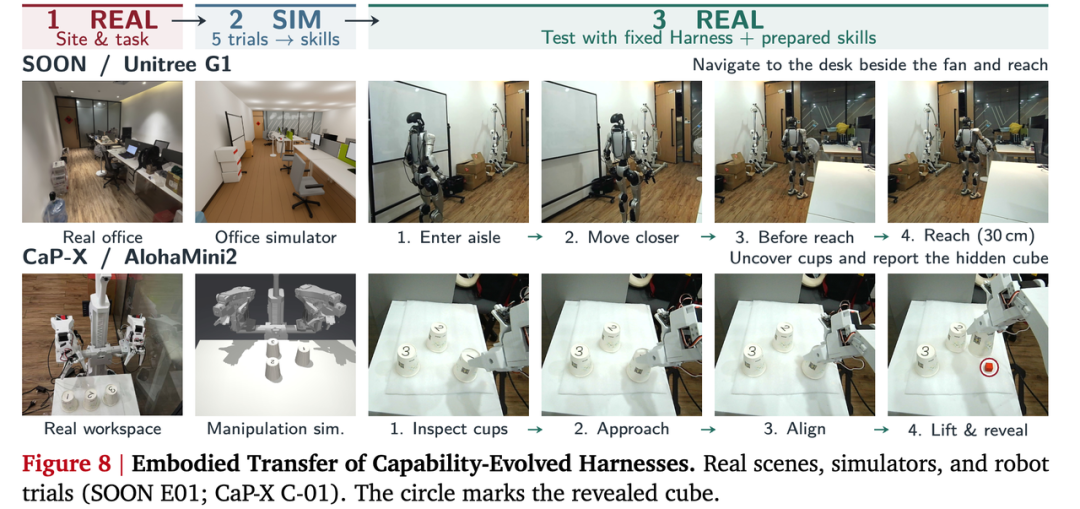
最后,我们把演化后的 Harness 用到了两个真实具身任务中。一个是 SOON:Unitree G1 需要在办公室中找到风扇旁的目标桌子,并走到可以触及的位置。另一个是 CaP-X:AlohaMini2 需要检查倒扣的杯子,判断其中是否藏有方块,并报告它的颜色与位置。
这两个任务都需要智能体在行动过程中持续获取环境信息,并在证据充分后作出决定。我们将能力树对应节点的演化 Harness 用于这两个任务,并通过重建的模拟环境准备任务 Skill,随后在真实机器人上评估。最终,SOON 的真实任务成功率从 0% 提升到 60%,CaP-X 也从 0% 提升到 60%。
5. 结语:什么驱动进化,进化又塑造什么?
回到最开始的问题。如果 RSI 始终由独立任务驱动,系统就容易围绕各自的局部目标改进。增加任务数量,可以积累更多解决方案,却不一定让这些经验形成联系,沉淀为能够复用的能力。
扩大演化范围、改进版本选择和种子任务集、让决策 Agent 也参与演化,都在优化 RSI 的搜索与更新过程。但即使改进器足够强、能够保留全部历史,仍需回答:哪些经验应该共享,哪些修改需要独立保留,又该依据什么组织不同任务的演化方向?
Capability-driven 将共同的能力需求作为改进依据。The Trinity 以此组织环境、经验与 Harness 的演化,形成有结构的训练数据分布:通过共享能力连接不同任务,通过不同分支保留各自的优化方向。这样的组织方式,让局部改进有机会积累为可组合、可迁移的能力,也为缓解过拟合和 reward hacking 提供了可能。
RSI 的关键,可能不只是完成更多任务或持续运行 loop,而是选择什么驱动改进,以及这些改进最终能否沉淀为可共享、可组合、可迁移的能力结构。
论文及作者信息
该工作的项目负责人为西安电子科技大学本科生汤维栋,主要研究方向为多模态大模型、递归自我进化、具身智能;
同济大学本科生王瑞恒、新加坡国立大学硕士生张景轩以及 InfRec 首席执行官王和新为主要贡献者。
通讯作者是新加坡国立大学博士生周鹏飞、香港中文大学博士生张昊天、新加坡国立大学校长青年教授尤洋老师。
作者:Weidong Tang, Ruiheng Wang, Jingxuan Zhang, Hexin Wang, Haoyuan Chen, Zhengfeiyang Zhang, Yixing Ma, Zichen Jiang, Ziyu Guo, Haodong Li, Zhengbo Jiao, Zhiqing Cui, Xinxiang Yin, Shuo Liang, Zhenglin Wan, Hongzhan Lin, Wangbo Zhao, Kaipeng Zhang, Pengfei Zhou, Odin Zhang, Yang You
单位:InfRec, XDU, TJU, NUS, UC Berkeley, CUHK, HKUST, HKU, SII
作者联系:wdtang0705@gmail.com
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群