点击蓝字 关注我们

欢迎各位专家学者在公众号平台报道最新研究工作,荐稿请联系小编Robert(微信ID:BrainX007); 或将稿件发送至lgl010@vip.163.com。
英文标题:Adaptive Spatial–Temporal Aware Graph Learning for EEG-Based Emotion Recognition

成果简介
脑电(EEG)情绪识别有两个绕不开的“卡点”。一是连接怎么画:电极之间的功能耦合并不服从固定的物理距离或解剖分区,用 KNN、先验脑区去“指定”邻接矩阵,等于把假设强加给数据;二是换人就失效:EEG 非平稳、个体差异大,在一个人身上训好的模型,换个人往往大幅掉点。针对以上问题,深圳大学梁臻团队提出 GraphEmotionNet:把 62 个电极看作图的节点,让邻接矩阵在训练中自己“长”出来——边权由节点特征距离与可学习权重向量共同决定,KNN 只做初始化,此后随反向传播不断修正,并用 Frobenius 范数约束稀疏性,避免“全连接”式的伪相关。在此之上,模型叠加时间 / 空间双注意力与时空图卷积:前者回答“看哪几个片段、看哪几个电极”,后者用 Chebyshev 图卷积聚合邻域、再用二维卷积刻画情绪状态的转移;最后以梯度反转的域对抗训练对齐源域与目标域特征,让目标被试的无标签数据也能参与训练。在 SEED 与 SEED-IV 两个公开数据库上,模型被试内三分类准确率达 94.68%、跨被试 86.43%;四分类分别为 71.62% 与 63.07%。在真实临床抑郁数据(29 名患者 / 27 名对照)上,模型不改结构即可完成患者与健康人的二分类,闭眼、睁眼静息条件下平均准确率分别为 62.25% 与 63.64%。
研究亮点
图结构不是“设定”的,而是“学”出来的。邻接矩阵 Amn直接由节点特征与可学习权重生成,训练中持续迭代,并控制稀疏度。消融实验显示,把自适应图换成固定 KNN 图后,两个库、两种协议下精度一致下降——先验图确实“框住”了模型。
空间与时间一起建模,而不是只做“静态图”。时间注意力 Q 捕捉片段间的情绪关联,空间注意力 P衡量电极重要性且与图学习联动更新;空间维用二阶 Chebyshev 图卷积聚合邻域,时间维用二维卷积刻画情绪转移。相比只看空间图卷积的 DGCNN,它在两个库上均取得更优结果。
域对抗迁移专治“个体差异”,且能跨任务复用。梯度反转层叠加域判别器,让特征提取器“对抗地”学出域不变表示;平衡系数 λ 前期强化对齐、后期回归分类。消融显示,去掉判别器后跨被试精度下降 7.90(SEED)与 4.32(SEED-IV)个百分点;尤其在本就更难的四分类设定中,被试内仅掉 0.58 而跨被试掉 4.32,说明这块增益主要兑现在“跨人”场景。同一套结构迁移到临床抑郁识别任务,仍能稳定工作。
图文解析

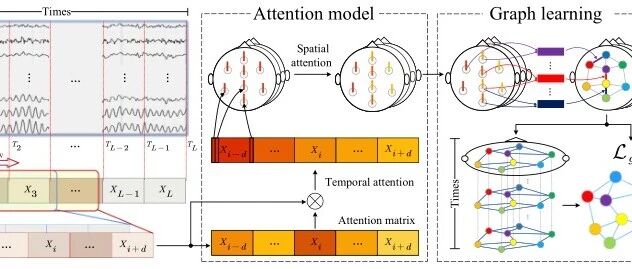
图1. GraphEmotionNet 的总体概览。

图2. 实验中的交叉验证方案。(A) 被试内交叉验证。对于每个被试,前 m 个试次作为源域,剩余的 15-m 个试次作为目标域。(B) 跨被试交叉验证。其中一个被试作为目标域,其余 14 个被试作为源域。

图3. 在被试内交叉验证(内)和跨被试交叉验证(跨)下,超参数 d 对模型性能的影响。

图4. 在被试内交叉验证(内)和跨被试交叉验证(跨)下,超参数 K 对模型性能的影响。
研究结论
本文把“图怎么连”从先验假设交还给数据:以可学习的邻接矩阵为核心,串起时空注意力、时空图卷积与域对抗迁移,形成一条完整的 EEG 情绪识别流水线。实验表明,自适应图能更贴切地刻画电极间的耦合关系,双注意力与时空卷积补上了“情绪如何随时间变化”这一维,域适应则显著缓解了跨被试的性能塌陷。四分类跨被试场景下与传统方法的差距也提醒我们:仅靠特征对齐还不足以完全消除个体差异,标签分布、情绪诱发强度、session 间漂移都可能成为下一步的突破口。超参数分析显示模型对时间上下文系数 d(1–9)与 Chebyshev 阶数 K(1–5)并不敏感,这为实际部署留出了调参余量。对做脑机接口与情感计算的同学而言,这篇工作的价值或许不在某个百分点的领先,而在于提供了一个可迁移的“动态图 + 域适应”骨架——换成 EEG 以外的生理信号,这套思路同样成立。
免责声明:原创仅代表原创编译,水平有限,仅供学术交流,如有侵权,请联系删除,文献解读如有疏漏之处,我们深表歉意。


公众号丨智能传感与脑机接口