与传统软件不同,Agent 由大模型驱动,输出带有概率性;它需要调用搜索、数据库、代码执行等外部工具,交互边界是开放的;它的执行路径会随输入动态变化,同一句指令两次执行,可能走出两条不同的链路。三个特点叠加,让“复现问题—定位原因—验证修复”的传统测试与运维方法开始失效:用例难以穷举,结果难以断言,单点日志也难以还原完整过程。
课程由此展开,介绍 openEuler Witty Agent Insight 面向 Agent 质量保障提供的能力。链路观测把一次任务拆解为可回看的执行步骤,让“它究竟做了什么”有据可查;多维评测从结果正确性、过程合理性等维度给出量化判断,让“它做得好不好”可以比较;智能诊断基于执行证据缩小问题范围,回答“问题出在哪一步”;Skill 优化把诊断结论落到具体的技能与提示改进上,让“下次怎么做得更好”有章可循。
四个环节首尾相接,构成“观测—评测—诊断—优化”的闭环。课程强调,Agent 的可靠性不取决于某一次回答是否漂亮,而取决于问题能否被稳定发现、被准确定位、被有效验证。
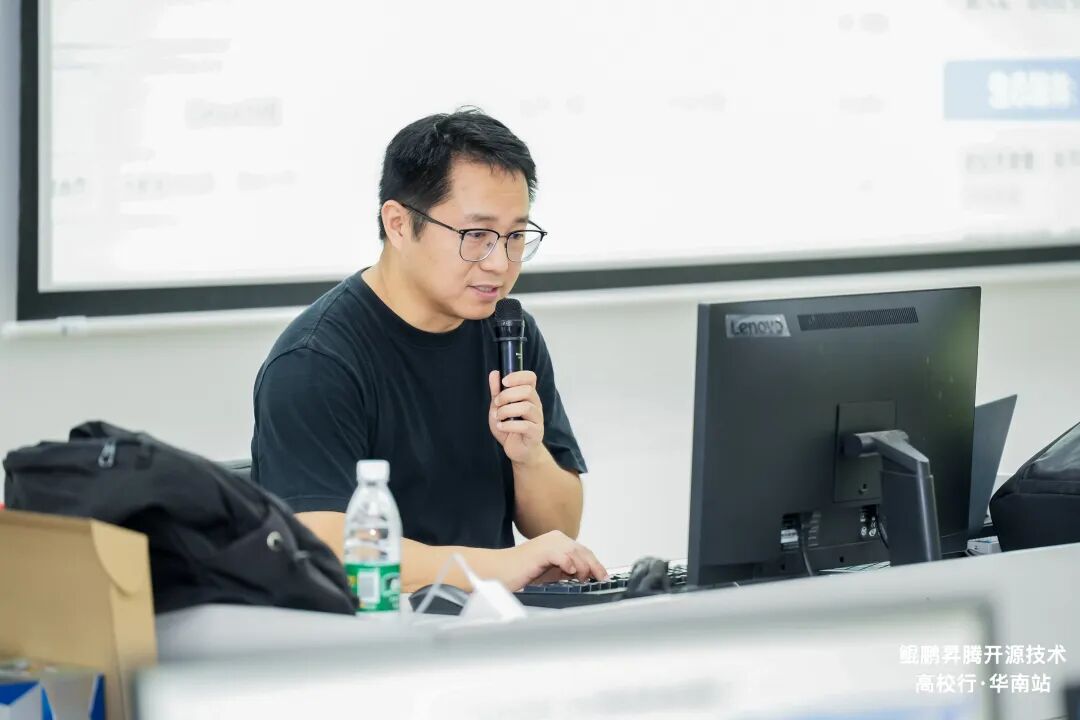

在实操环节,同学们拿到的是真实的 Agent 执行记录,任务按三步推进:先按评测维度为执行结果打分,筛出异常样本;再沿着执行链路逐层回看,定位失败发生在哪一步、由哪一次工具调用或哪一段推理引起;完成根因分析后,对优化过的 Agent 重新评测,用前后对比的数据确认改进是否真正生效。
实验过程中,抽象的“可观测性”变成了具体的操作:一条条执行记录、一组组评测分数、一次次复测结果,共同构成一条可以追溯的证据链。同学们也由此理解,Agent 调优不是反复改写提示词的试错,而是建立在证据之上的工程方法。
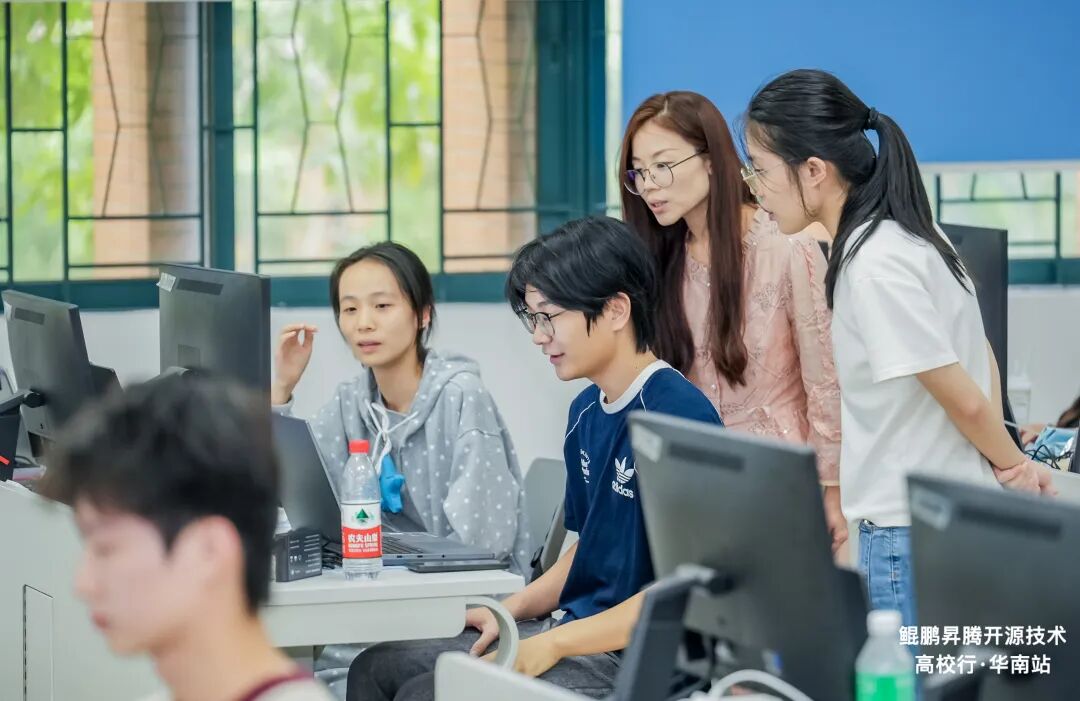

从课堂讲解到动手实践,openEuler 社区把 Agent 可靠性这一前沿课题带进了高校课堂。开源社区的价值正在于此:真实的问题、真实的代码、真实的反馈,让学习不止于概念。面向 Agent 规模化的下一阶段,openEuler 社区将持续开放 Witty Agent Insight 的相关能力与实践案例,期待更多高校开发者在真实的代码与场景中参与共建,一起把 Agent 做得更可靠。
-END-
供稿 | 肖雨菡
编辑 | 丘云
校审 | 郑振宇、刘彦飞

openEuler发布面向Agentic Infra的操作系统,全球协同共建AI生态
关注我们,了解更多
▼