FlagOS 是 FlagOpen 开源社区推出的大模型开源软件栈,包含 FlagScale 分布式训推框架、FlagGems 通用算子库、FlagCX 通信库、FlagTree 统一编译器等组件,目标是让 AI 应用在多种芯片上"一次开发、处处运行"。面向昇腾算力,FlagOS 通过推理适配插件把 FlagGems 算子库接入 vLLM、SGLang 等主流推理框架,并由 FlagRelease 平台自动产出、发布"芯片 + 开源模型"组合的开箱即用容器镜像。
OpenAtom openEuler(简称:"openEuler"或"开源欧拉")是面向数字基础设施的开源操作系统,在内核调度、驱动适配等层面对昇腾等 AI 算力提供支持,FlagOS 这类软件栈可以直接部署其上。
本文以 FlagRelease 发布的 MiniCPM5-2B 昇腾推理镜像为对象——镜像内置 SGLang 0.5.11、FlagGems 5.3.0 与 FlagOS 的 SGLang 适配插件,在 openEuler 24.03 与昇腾 910B4 组成的环境里完成了部署、冒烟验证与全档位压测,覆盖 8 组输入输出长度组合、最高 128 路并发、单卡与双卡张量并行(TP)两种形态。
本次实践的软硬件环境如下:
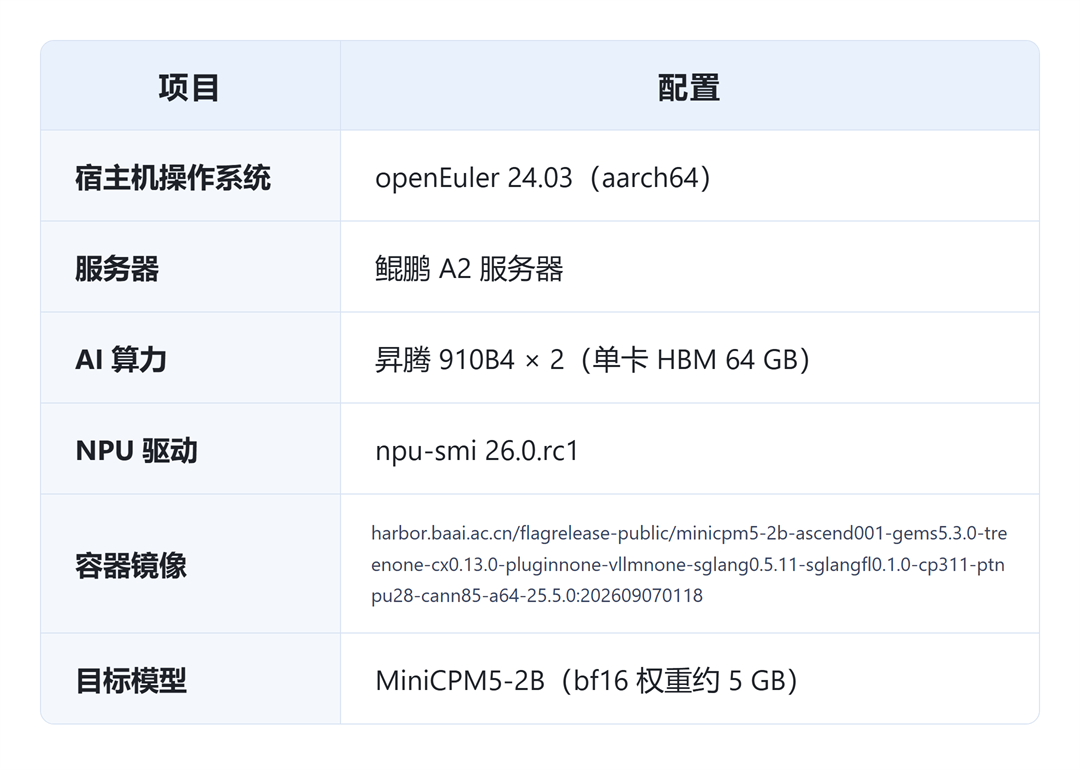
推理软件栈整体来自 FlagOS 定制容器镜像,版本如下:

与逐个 pip 安装的方式不同,定制镜像把整条推理栈固化在一起,镜像名本身就编码了组件组合(gems5.3.0 / sglang0.5.11 / sglangfl0.1.0 / cann85 等;treenone、vllmnone 表示本镜像不含 FlagTree 与 vLLM),环境一致性、依赖冲突等问题基本被消除。
模型权重提前下载到本地(本文路径为 /models/FlagRelease/MiniCPM5-2B),在宿主机执行:
pip install modelscopemodelscope download --model FlagRelease/MiniCPM5-2B-BF16-ascend-FlagOS \--local_dir /models/FlagRelease/MiniCPM5-2B
该权重是 FlagRelease 基于 OpenBMB/MiniCPM5-2B 发布的昇腾适配 BF16 版本(Apache 2.0 开源)。MiniCPM5-2B 采用标准 Llama 架构、支持思维链混合推理,SGLang 原生支持,无需额外适配,适合作为验证软件栈的演示模型。

▲npu-smi info 输出(宿主机 910B4 × 2)
▐ 拉取镜像并启动容器
镜像托管在智源研究院的 harbor 仓库,国内网络直连即可(宿主机执行):
docker pull harbor.baai.ac.cn/flagrelease-public/minicpm5-2b-ascend001-gems5.3.0-treenone-cx0.13.0-pluginnone-vllmnone-sglang0.5.11-sglangfl0.1.0-cp311-ptnpu28-cann85-a64-25.5.0:202609070118启动容器时按官方说明挂载 NPU 设备与宿主机驱动目录,设备号按实际卡数调整(本文 2 卡,挂 davinci0/1;官方示例为 16 卡 A3 服务器):
docker run -dit \--name flagos \--privileged \--init \--network=host --ipc=host --shm-size=512g \--device=/dev/davinci0 --device=/dev/davinci1 \--device=/dev/davinci_manager \--device=/dev/hisi_hdc \--volume /usr/local/sbin:/usr/local/sbin \--volume /usr/local/Ascend/driver:/usr/local/Ascend/driver \--volume /usr/local/Ascend/firmware:/usr/local/Ascend/firmware \--volume /etc/ascend_install.info:/etc/ascend_install.info \--volume /var/queue_schedule:/var/queue_schedule \--volume /models:/models \--volume /etc/localtime:/etc/localtime:ro \--entrypoint=bash \harbor.baai.ac.cn/flagrelease-public/minicpm5-2b-ascend001-gems5.3.0-treenone-cx0.13.0-pluginnone-vllmnone-sglang0.5.11-sglangfl0.1.0-cp311-ptnpu28-cann85-a64-25.5.0:202609070118docker exec -it flagos /bin/bash
进入容器后,先做宿主机级性能调优并加载 CANN 环境(容器内执行,--privileged 已放开相关权限):
echo performance | tee /sys/devices/system/cpu/cpu*/cpufreq/scaling_governorsysctl -w vm.swappiness=0sysctl -w kernel.numa_balancing=0sysctl -w kernel.sched_migration_cost_ns=50000source /usr/local/Ascend/ascend-toolkit/set_env.shsource /usr/local/Ascend/nnal/atb/set_env.sh
随后设置 FlagOS 与 NPU 相关环境变量,并拉起 SGLang 服务:
export SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1export SGLANG_FL_PREFER=vendorexport SGLANG_FL_PER_OP="silu_and_mul=flagos"export ASCEND_RT_VISIBLE_DEVICES=0export STREAMS_PER_DEVICE=32export SGLANG_ENABLE_OVERLAP_PLAN_STREAM=1export SGLANG_NPU_USE_MULTI_STREAM=1export SGLANG_FLAGGEMS_RECORD=1 SGLANG_FLAGGEMS_LOG_PATH=/tmp/gems_aten.txtexport SGLANG_FL_FLAGOS_BLACKLIST=argmax,index_put_,_index_put_impl_,index_select,max,sum,fill_scalar_,index,floor_dividepython -m sglang.launch_server \--model-path /models/FlagRelease/MiniCPM5-2B \--served-model-name MiniCPM52 \--dtype bfloat16 \--host 0.0.0.0 --port 31000 \--trust-remote-code \--device npu \--cuda-graph-max-bs 128 \--disable-radix-cache
几个关键环境变量的作用:SGLANG_FL_PREFER=vendor 与 SGLANG_FL_PER_OP="silu_and_mul=flagos" 把 silu_and_mul 算子路由到 FlagOS(FlagGems)实现,SGLANG_FL_FLAGOS_BLACKLIST 列出继续走原生实现的算子,SGLANG_FLAGGEMS_RECORD 开启 FlagGems 算子命中日志;SGLANG_ENABLE_OVERLAP_PLAN_STREAM、SGLANG_NPU_USE_MULTI_STREAM 与 STREAMS_PER_DEVICE 控制 NPU 多流与 overlap 调度;ASCEND_RT_VISIBLE_DEVICES 负责选卡。--cuda-graph-max-bs 128 让 NPU Graph 覆盖到 128 并发,避免高并发回退 eager 模式出现吞吐断崖。
服务就绪后,用 OpenAI 兼容接口发一次对话请求做冒烟验证:

▲服务冒烟请求返回结果示例
压测客户端基于 aiohttp 实现流式请求:随机 input_ids 精确控制输入长度,ignore_eos 精确控制输出长度,temperature=0;每个配置先做真实形状预热(含 prefill+decode 交叠请求)以消除一次性 JIT 编译的干扰;每请求独立记录 TTFT、逐 token 时间戳与端到端耗时,统计 mean/p50/p95/p99。
指标定义:TTFT 为首 token 延迟;TPOT 为每输出 token 平均间隔;E2E 为单请求端到端耗时;输出吞吐(Out TPS)为输出 token 速率;总吞吐(Total TPS)为输入+输出 token 速率。
压测期间服务配置为 --device npu --cuda-graph-max-bs 128 --disable-radix-cache --trust-remote-code --dtype bfloat16;TP=1 单卡 KV 容量 max_total_num_tokens=1,066,112,TP=2 为 2,243,968。
下文带 * 的配置表示并发 ×(输入+输出)的 KV 需求超过 KV 总容量,请求排队,TTFT/TPOT 尾部含排队时间,不代表单波真实延迟。
▐ 4.1 单请求基线(TP=1)
单并发下 TPOT 稳定在 9 ms 上下(单流 100 tok/s 量级),与输入长度基本解耦——decode 阶段算力充足,主要开销在长 KV 的 attention。TTFT 随输入长度增长:512 输入 75.7 ms,16k 输入约 0.98 s(prefill 按 chunked_prefill_size=8192 分两段执行)。16k/1k 与 16k/2k 的 TTFT 几乎相同,也印证了 TTFT 由 prefill 主导、与输出长度关系不大。

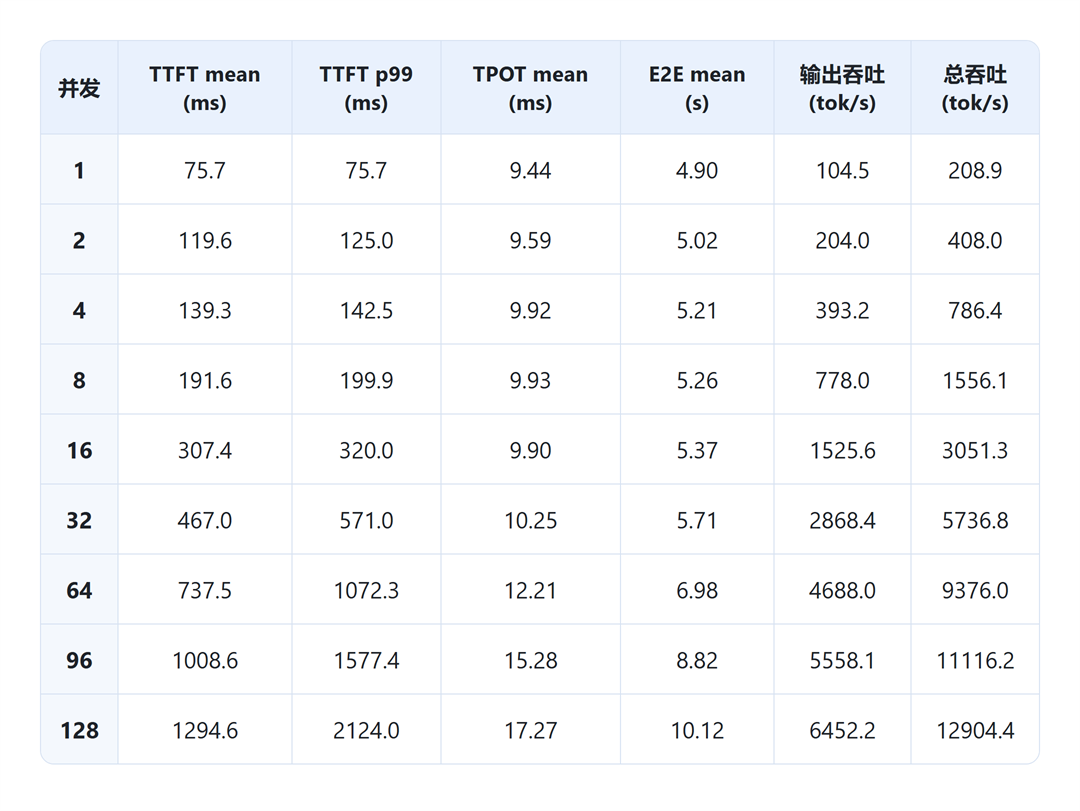
▐ 4.2 并发扩展能力(TP=1,512/512 )
并发从 1 拉到 128,输出吞吐一路爬到 6452.2 tok/s(含 prefill 的总吞吐 12904.4 tok/s),128 并发仍未触顶。TPOT 从 9.44 ms 平滑缓涨到 17.27 ms。TTFT mean 从 75.7 ms 涨到 1294.6 ms,在线交互场景有富余。KV 方面,128 并发 × 1024 tokens 共约 13.1 万 tokens,仅占单卡 106.6 万容量的 12% 左右,远未触顶。
▐ 4.3 不同输入输出长度下的吞吐对比(TP=1,输出 tok/s)
序列越长吞吐越低,与 KV 占用和注意力计算量的增长直接相关。8k/16k 输入的高并发点位(带 *)KV 需求超过单卡容量,请求排队,吞吐进入平台期,此时增加卡数(TP=2)或控制并发才是正解。

▐ 4.4 双卡 TP=2:长上下文的容量解法
2B 参数量的模型单卡即可吃满算力:相同配置下 TP=1 的 TPOT 整体低于 TP=2(典型低 20%~40%),短序列吞吐也全面占优——TP=2 在 512/512、128 并发下输出吞吐 4167.4 tok/s,约为 TP=1 同档的 65%。TP=2 的真正价值在 KV 容量翻倍,带来的排队缓解。
16k/2k 场景下两种并行方式的对比最能说明问题。TP=1 从 64 并发起 KV 总需求超过单卡容量(128 并发约 236 万 tokens,远超 106.6 万),请求排队,吞吐被压在 640~680 tok/s;TP=2 凭翻倍容量在 96 并发内基本无排队,吞吐最高 918.2 tok/s,较 TP=1 同档提升约 35%,TTFT p99 也从约 202 s 收窄到约 112 s。128 并发时 TP=2 同样轻微越界(约 236 万 > 224.4 万),尾延迟有所回升。

FlagOS 官方昇腾镜像(内置 SGLang 0.5.11、FlagGems 5.3.0、sglang-fl 0.1.0)在 openEuler 24.03 + 昇腾 910B4 环境下完成部署、冒烟与全档位压测,全流程跑通;推理栈由镜像整体固化,部署门槛显著低于手动组装。
压测数据可用于容量规划参考:单并发 TPOT 约 9 ms、单流 100 tok/s 量级,16k 输入 TTFT 约 1 s;512/512 场景 128 并发单卡输出吞吐 6452.2 tok/s、总吞吐 12904.4 tok/s,TTFT p99 约 2.1 s,且尚未触顶;NPU Graph 全覆盖下 TPOT 随并发平滑增长,无明显断崖。
技术选型参考:2B 量级模型单卡(TP=1)即可饱和,TP=2 仅在 16k 长上下文高并发等超大 KV 场景,靠容量换排队延迟与吞吐触发排队。


本专项聚焦 openEuler 系统 AI 北向软件生态适配与性能优化,围绕大、中、小模型全场景推理、训练需求,完成 SGLang、Ollama、vLLM、PaddleOCR 等主流 AI 框架及工具链的适配兼容与性能调优,覆盖大模型推理加速、轻量化模型部署、向量语义编码、语义重排、多场景 OCR 识别等核心AI能力。专项打通系统层与 AI 应用框架的适配壁垒,解决 openEuler 环境下 AI 模型框架部署兼容差、运行低效、适配碎片化等问题,搭建标准化、高性能、全适配的北向 AI 软件栈,充分释放系统异构算力,为开发者提供开箱即用的大模型开发、微调与部署环境,完善从底层算力到上层 AI 应用的全链路生态支撑。
-END-
供稿 | 欧阳庆
编辑 | 丘云
校审 | 赵家麒、郑振宇、刘彦飞

邀请函 | Agentic Infra 操作系统大会 & openEuler Summit 2026
关注我们,了解更多
▼