作为国内集成电路设计领域的年度风向标,ICCAD-Expo 2026近日在北京开幕,大会汇聚了来自芯片设计、EDA工具、半导体IP、制造封测以及终端系统应用等产业链上下游的领先企业。与之前普遍关注云端数据中心超大集群算力、大模型训练参数量不同,本届大会传递出一个清晰的信号:当生成式AI从云端中心加速下沉,人工智能从被动的对话式交互走向具备持续推理与自主执行能力的智能体(Agentic AI),芯片设计行业正在重新审视底层的算力支撑逻辑。
在开幕高峰论坛上,安谋科技CEO陈锋受邀发表主旨演讲,重点剖析了在Agentic AI时代算力价值的转向与产业新机遇。同期展会上,安谋科技展位上集中展示了面向边缘AI的重磅新品、全场景IP产品矩阵以及具身智能(Physical AI)生态合作的前沿成果。
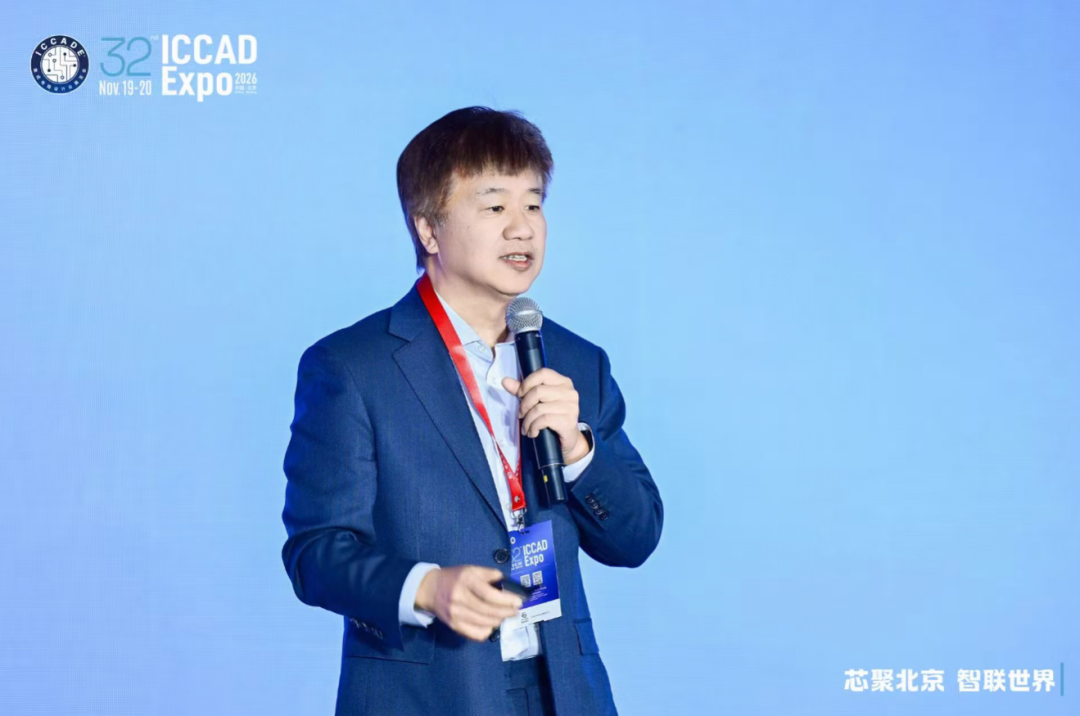
安谋科技CEO陈锋在ICCAD2026发表主旨演讲
告别单一 Token 标尺
过去几年间,以生成式大模型为代表的技术浪潮极大刺激了算力扩张,云端大吞吐、高并发的Token生成速度一度成为衡量算力价值的核心标尺。然而,伴随大模型应用由概念验证走向大规模产业落地,单纯在云端堆砌算力集群,并不能解决端侧的AI应用落地难题。
正如陈锋在主旨演讲中所指出的行业共识:“伴随AI应用规模化落地,AI产业的发展不再只是追求算力规模与Token产出的增长,更加注重计算能效、算力成本与AI的实际应用价值。”
这一判断精准契合了AI向Agentic AI演进的内在需求。在对话式AI阶段,人机交互以单轮或短程提示词交互为主,模型作为辅助工具在后台完成文本生成;而在Agentic AI阶段,智能体具备自主规划、环境感知、多步推理、外部工具调用与连续执行能力。在处理复杂的实际任务时,系统不再是一次性输出结果,而是经历观察、思考、规划、行动与纠偏的持续推理与自主执行流程。
这种工作机制使得算力消耗呈现快速增长。如果将持续的多步任务全部交由云端处理,不仅面临不可控的网络传输延迟和高昂的数据通信开销,还将带来持续膨胀的API调用成本与潜在的隐私安全顾虑。对于自动驾驶、具身机器人、智慧工业等严苛环境而言,外部环境要求高实时性的本地确定性响应,任何网络波动都可能带来严重后果。因此,算力向边缘端侧下沉已成必然趋势。而在功耗、散热与成本约束下,计算芯片无法无节制地增加面积与功耗,单纯以Token吞吐量衡量算力显然不再适用。边缘场景更看重单位功耗下的有效计算产出、任务实时响应延迟以及实际落地的部署成本。

ICCAD2026 安谋科技展台内景
CPU回归与架构协同
应用场景的延伸正在推动底层计算平台的深刻变革。面对日趋复杂的智能体工作负载,单一处理器架构已难以满足兼顾通用控制与密集加速的多样化需求。
陈锋在主题演讲中重点强调,在当前的AI负载环境下,计算架构正在发生结构性分化。GPU主要提供大规模并行张量计算能力,而CPU除了承担常规通用计算之外,更关键的是要负责整个系统的任务编排、资源调度以及异构单元之间的协同管理。随着智能体在感知、决策与工具调用之间频繁切换,数据流在不同算力核心间的流转日趋频繁,CPU作为系统枢纽的重要性正在加速回归。
与此同时,CPU、GPU与专用加速器协同的异构计算已全面成为行业主流。这一转变直接推动芯片层面的竞争焦点,从过去比拼单一计算核心的纸面峰值算力,转向考量整套计算系统的综合能效表现。单纯在板级堆叠多颗独立芯片,接口延时与互连功耗往往会抵消加速优势;唯有在芯片架构与子系统层面实现高效的异构协同,才能在有限的功耗预算内达成最佳算力输出。
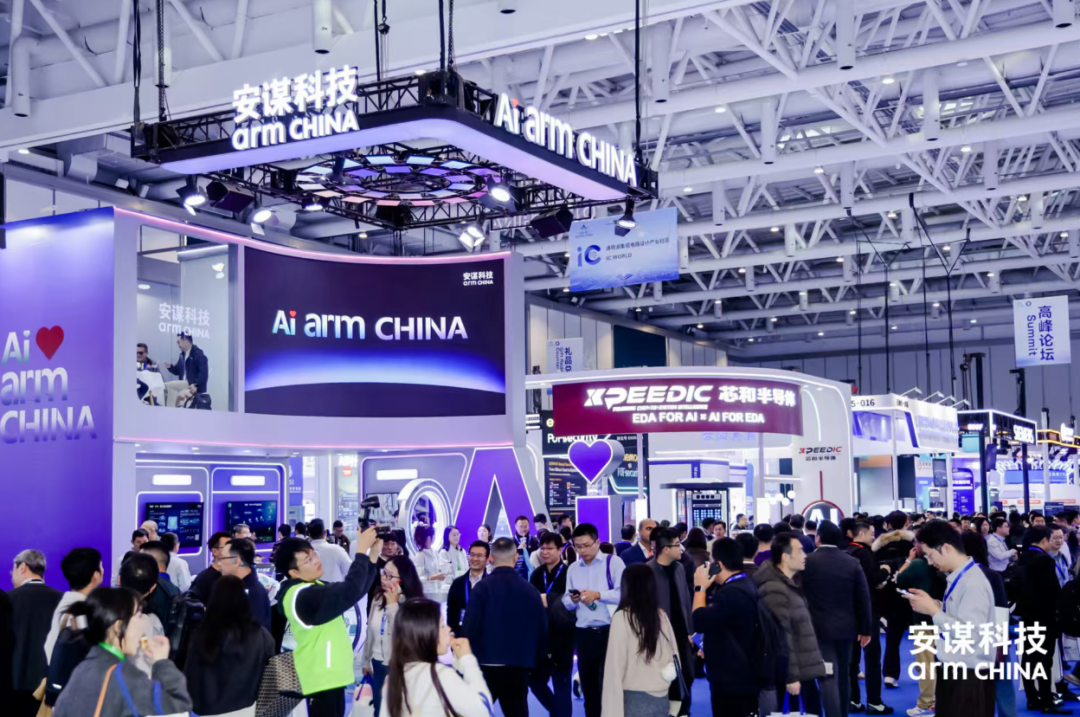
ICCAD2026 安谋科技展位全景
在异构计算的演进脉络中,成熟的Arm计算平台构筑了深厚的技术底座。其核心优势体现在两大维度:一是业界领先的每瓦计算性能,能够以优异的能效比满足智能时代对算力密度与低功耗的要求;二是由全球超过3000万开发者构筑的庞大软件生态,为算法的高效迁移、部署与规模化商用提供了成熟有力的生态支撑。立足本土产业实际,安谋科技将Arm前沿技术与本土自研创新紧密结合,打造了覆盖芯片IP、计算子系统及定制化设计服务的完整产品矩阵,致力于赋能Cloud AI、Physical AI以及Edge AI的全场景技术落地。
边缘端侧的算力突破
在全场景布局中,边缘端侧(Edge AI)由于受到面积与功耗的极度限制,对异构设计的工程实现提出了极高挑战。在本届ICCAD同期,安谋科技公布了面向嵌入式智能领域的关键技术成果,为低功耗边缘异构提供了清晰的实施路径。

Arm Cortex-M42 于ICCAD2026闪耀登场
针对微控制器(MCU)聚焦的低功耗智能端点设备,安谋科技与Arm合作开发推出了Arm Cortex-M42 CPU IP,在中国市场命名为“星辰”STAR-MC3。该内核专为对成本和硅片面积敏感的场景打造,基于经典的AHB总线紧凑设计,使得芯片设计厂商能够在沿用成熟MCU系统架构的同时,无需引入复杂的内存子系统即可完成平滑升级。
在微架构方面,Cortex-M42基于Armv8.1-M架构,引入了Helium矢量处理技术与Arm自定义指令(ACI)。相较于前代Cortex-M33,其向量计算能力提升至3倍,向量能效提升至2倍,并在8位定点计算场景中展现出优异的加速表现。在主流TSMC 22ULL工艺与150MHz主频配置下,相比Cortex-M52,Cortex-M42在维持相近标量与向量性能的前提下,实现了硅片面积缩减10%、运行功耗降低15%的高面效比表现。通过ACI接口,芯片开发者还能针对特定算法添加专属扩展指令,在严苛的成本边界内达成了通用处理与专用加速的平衡。

基于Cortex-M42与Ethos-U55的星辰100e AIoT原型平台
为了帮助下游客户快速验证异构架构的实际效能,安谋科技同步推出了新一代轻量级AIoT原型平台“星辰100e”。该平台采用Arm Cortex-M42 CPU与Arm Ethos-U55 NPU 的异构组合,专门应对重计算神经网络对算力的极高要求。
在FPGA平台的实测验证中,“星辰100e”展现出异构子系统的强大能效优势。面对边缘端侧常见的AI任务,相比单独使用Cortex-M42处理器,搭配Ethos-U55 NPU后,关键字检测推理性能提升高达95倍;目标识别推理性能提升超过132倍;而在自动语音识别(ASR)场景下,性能提升更是超过340倍。这一实测数据充分证明,将CPU矢量扩展与专用NPU加速深度协同,能够在极低功耗与有限面积下大幅拓展端侧智能设备的运算边界。
除了MCU层面的轻量级创新,在面向更复杂的边缘AI SoC计算场景中,安谋科技自研的“周易”X3系列NPU展现出软硬协同的高效计算架构。随着云边端推理应用的大规模爆发,大模型在端侧运行对内存带宽带来了巨大压力。周易X3系列NPU原生支持FP4低精度计算,在大幅压缩模型存储空间与内存访问带宽的同时,维持了浮点数的高动态表达范围。在大会上,陈锋正式宣布,基于“周易”X3架构打造的国内首颗支持FP4的端侧SoC即将步入规模化量产阶段。此外,采用统一、分层架构的升级版“周易”X3-pro也即将推出,进一步筑牢端侧多模态智能体的算力底座。
推动智能走向物理世界
从超低功耗微控制器内核的技术演化,到原生FP4在端侧SoC的产业量产,安谋科技通过“AI Arm China”战略展示了系统化的全场景落地实践。当算力不再单纯以Token数量为尺度,智能体技术才能真正打破物理环境与功耗成本的束缚,稳步走进更广阔的现实产业之中。正如陈锋在主旨演讲中所言:“AI的终极意义,不止于突破技术极限,更在于让智能走进现实,为人类创造真正的价值。”