文章转载于动察Beating
文|Sleepy
工业史上有一种规律,越是到了换代的时候,越能看清一个技术到底生长在哪儿。
十八世纪六七十年代的英国,水力纺纱机刚被造出来,工厂主们往北走,去奔宁山脉两侧的德比郡、兰开夏郡找河谷。那时候瓦特的蒸汽机还没进纺织厂,带动纺锤靠的还是水轮。再过几十年,蒸汽机铺开了,工厂又陆续从山谷搬到了煤田和城市边上。
每一次技术换代,先是一套算法、一张图纸或一台机器的发明,紧接着就是一场找电、找水、找土地的地理意义上的大搬家。
风平浪静时,全球供应链像一张铺平的网,算力隔着太平洋也能调取,人们很容易产生一种错觉,以为软件与智能没有重量,也不挑水土。可一旦遇到封锁与围堵,云端就会落回地面,显出它作为重工业的本来面目,它需要电,怕热,挑线路,更取决于那一排排机柜里的芯片到底是谁的。
1964年10月16日,罗布泊,中国第一颗原子弹爆炸成功,代号「596」。五年前的1959年6月20日,苏共中央致信中共中央,决定暂缓提供协议里商定好的原子弹教学模型和图纸资料。

1964年罗布泊中国第一颗原子弹爆炸的蘑菇云|图源:人民画报
几乎在同一个秋天,三线建设的选址方针定了下来,靠山、分散、隐蔽,具体执行时又多出两个字,进洞。此后十几年,数以百万计的工人、干部、知识分子和解放军官兵离开东部与东北的城市,把机床、高炉和实验室搬进西南与西北的大山,高峰时投入的人力有400多万。
半个多世纪过去,世界最前沿的工业换成了大模型。
训练大模型的人,每天都有一个规定动作,存 checkpoint 。几千上万张加速卡连着跑几个月,中间哪怕一张卡掉线,训练就会中断;每隔一段时间把模型的全部权重、优化器状态和随机数种子存下来,出了问题才能从最近的那一个节点接着跑。
这个词在英文里还有一个本义,边境检查站。
2026年11月,在经历了一轮横跨赤道的找卡长征之后,中国大模型行业迎来了属于自己的那座检查站。
60块硬盘
故事要从四只飞往吉隆坡的行李箱说起。
2025年3月初,四名中国工程师从北京飞往马来西亚。他们每人拖着一只行李箱,箱子里整整齐齐码着15块硬盘,一共装着80TB的数据。
他们的目的地是马来西亚当地的一座数据中心,雇主在那里租下了约300台搭载英伟达先进芯片的服务器。
为了这一趟飞行,国内的同事提前八周多就开始打磨数据集、反复调试训练程序。因为数据一旦装进箱子出了境,到了异国他乡的机房里,就很难再像在国内那样推倒重来。至于为什么不走网络传过去,理由是走网络传输「可能要几个月」,还不如肉身快。
按计划,他们最后要带回国的东西小得多,只有几百GB,是训练好的模型参数。
这是中国大模型第一次算力迁徙最原始的切面,卡进不来,数据就坐飞机出去。
把工程师逼上飞机的,是几年里步步收紧的芯片禁令。
2022年10月7日,美国第一次禁止向中国出售英伟达 A100 和 H100 ;英伟达很快专门为中国市场改出降低互联带宽的 A800 和 H800 。仅仅一年后的2023年10月17日,降速版也被关在了门外。

2022年与2023年美国先进计算芯片出口管制规则|图源:政府官网
那年国内市场一卡难求。A100 从年初的4万元左右一路跳涨到接近25万元;10月新规落地后的一周里,H800 的报价几乎翻倍,一台8卡整机在渠道商嘴里喊到了245万元。
与此同时,国内算力基建经历了一轮早产。2023年到2024年间,各地先后宣布了500多个智算中心项目,到2024年底至少150个已经投运。
一边是实验室拿着现金买不到卡,一边是各地机房空置,原因在于大模型训练的物理门槛,前沿模型需要的是上万张同代际高端卡通过高速网络拼成一个大集群,而散落在各地机房里的,大多是零散、老旧、连不成片的推理卡或上一代显卡。
好在当时的美国出口管制留了一道缝,只管买卖,不管租用。
总部在中国的公司不能把芯片买进国门,却可以去租海外云厂商和非中国业主的机房。行业里很快摸索出一套分工,最吃算力、最讲究集群通信带宽的预训练放在海外机房,模型训好后,把权重带回国内,用国内的算力池承接日常的用户推理。
路跑通了,手提行李箱的土办法很快被现代云基建取代。
再往后,工程师连国都不用出了。训练集群留在东南亚或北欧的机房里,算法团队坐在北京海淀、杭州余杭或上海徐汇的工位上远程登录,在终端里敲下一行行启动命令。
柔佛的油棕林
地球上有一条看不见的空中走廊,叫「东亚—澳大利西亚迁飞区」。
它从俄罗斯远东和阿拉斯加出发,穿过东亚和东南亚,一直延伸到澳大利亚和新西兰,途经22个国家,每年有超过5000万只水鸟沿着它南来北往。马来西亚柔佛州西南海岸的红树林湿地,是这条路上的歇脚处之一,其中的丹戎比艾正是亚洲大陆的最南端。
过去五年,这条迁飞路线上多了一种硅基候鸟。
柔佛与新加坡只隔着一道狭窄的柔佛海峡。这里的红土地换过好几茬作物,1940年代,从新加坡渡海而来的华人宗族砍开热带丛林,种下胡椒和甘蜜;英国殖民者来了,把作物改成橡胶;到了20世纪下半叶,漫山遍野换成了油棕树。
如今,推土机推倒了成片的油棕林,种下了柔佛的第四代经济作物,数据中心。
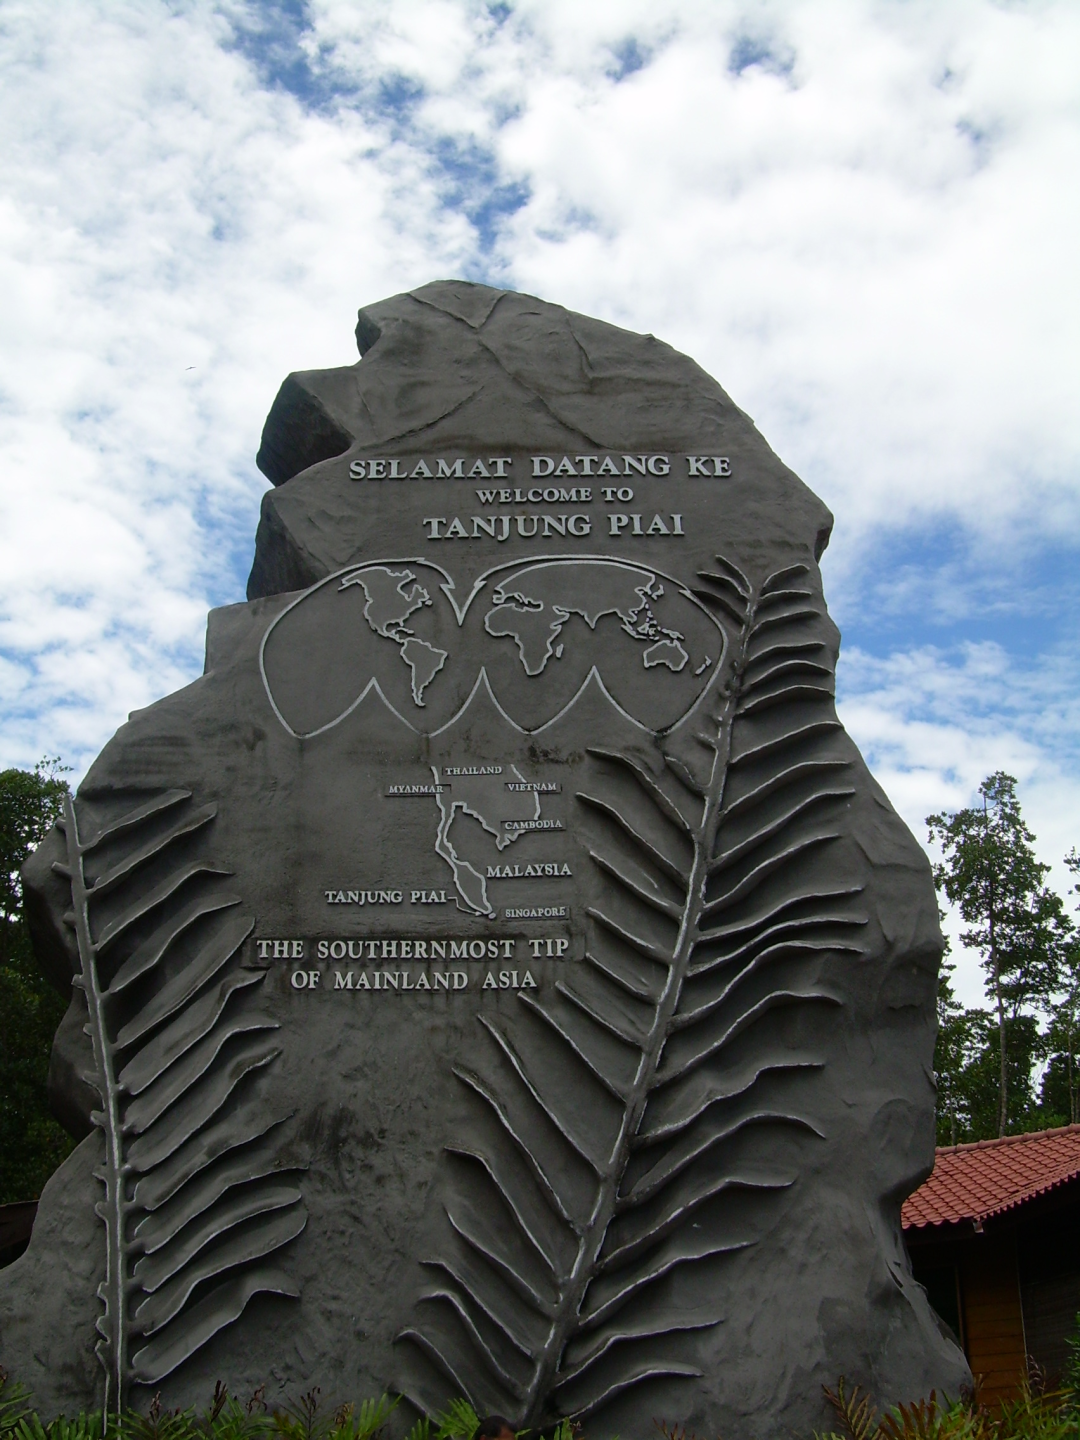
柔佛丹戎比艾亚洲大陆最南端地标碑|图源:D.W. Fisher-Freberg
2021年,整个柔佛州在线运行的 IT 负载只有区区10MW 。到了2025年底,这个数字跨过了900MW 。
把人吸引过来的,是海峡两岸悬殊的要素价格。
新加坡地少、电贵,曾在2019年到2022年间暂停批建新数据中心。而在海峡对面的柔佛士年纳科技园,每平方英尺地价只要5.12新元,新加坡大成一带则要6000新元左右;柔佛的电价,也只有新加坡的一半上下。
更让海外同行吃惊的是中国基建团队的交付速度。中资背景的运营商在柔佛拿地、平整、拉电、装冷却,九到十二个月就能亮灯交机房。DayOne 和曾与秦淮数据合并、如今归属美国资本的 Bridge Data Centres 两家,合计拿下了柔佛在线 IT 容量的至少58%。而在柔佛的中资运营商名单里,最大的客户是字节跳动。
连接柔佛新山与新加坡兀兰的那座跨海长堤关卡,每天有几十万人查验证件通关,是世界上最繁忙的陆路口岸之一,也是这一带最有名的物理 checkpoint ;而在海峡两岸的机房里,另一种 checkpoint 正被一份份存进硬盘。
2025年11月,《金融时报》报道,阿里巴巴和字节跳动都在东南亚的数据中心训练最新模型,签的是非中国业主的租约。一位新加坡数据中心运营商当时对媒体解释:「训练最前沿的模型需要最好的芯片,而且一切都合法合规。」
美国智库 IFP 做过估算,到2026年底,中国企业通过海外远程访问能够调动的算力,折合下来约为100万张 H100 等效算力,其中约75%分布在东南亚。2021年以来,马来西亚批准的数据中心投资累计达 950 亿美元。
飞得最远的一支队伍,一直飞到了北极圈边缘。从2025年5月起,字节跳动的一家海外子公司在挪威北部的峡湾小镇格洛姆菲尤尔租下了2304张英伟达 B200 芯片,那里靠水电供能,常年低温,字节这一笔订单就占了那家欧洲 neocloud 当年约四分之三的收入。
但所有人心里都清楚,借来的屋檐躲不过长久的雨。
候鸟南飞,从来不是为了在南方定居。
两家公司的2025
同样是面对算力围堵,2025年到2026年间,中国最具代表性的两家大模型公司,Kimi 和 DeepSeek ,分别走了两条路。
在南下找卡这条路上,月之暗面是最用力的一家。用一位知情人士的话说,他们在全球搜寻算力的姿态「非常 aggressive」。
2025年7月,月之暗面发布1万亿参数的 K2 ,用自研的 MuonClip 优化器在15.5万亿 token 上走完预训练。一年后的2026年7月16日,K3 正式发布,总参数量推高到2.8万亿,是全球首个开放权重的3T级模型。
美国 AI 学者 Nathan Lambert 在评测 K3 时专门提到,这个模型是「在一个 GPU 受限的环境里」做出来的。他和 Kimi 的研究员聊天时,半开玩笑地提起在 OpenAI ,一个普通研究员手头可能有「几千台 H100 等效机器」,对方「都震惊了」。
拿着远少于硅谷同行的卡,中国团队交出了让大洋彼岸无法忽视的答卷。硅谷风投机构 Menlo Ventures 在2026年11月发布的企业级报告显示,美国企业花在开源大模型上的钱,89%流向了中国模型,其中 Kimi 一家就拿走了61%的份额。

Menlo Ventures 2026企业AI报告|图源:Menlo Ventures
模型太强,最直接的烦恼就是卡不够用了。
K3 发布仅仅三天后,7月19日,Kimi 官方贴出一则《关于算力紧缺与会员暂停开放的说明》,说过去48小时,用户请求量已大幅超出预估,逼近现有集群的承载极限。新会员通道不得不临时关闭,等新一批算力到位后再分批放号。
为了替推理集群减压,月之暗面把能想到的办法都用上了,他们在和几家美国云厂商合作托管 K3 的收入分成,利用开源权重的优势,让海外云厂商用自己的 GPU 替 Kimi 接住海外企业客户。
但下一代旗舰模型的预训练,没法靠分流解决。据 The Information 7月底报道,规划中的 K4 规模将比 K3 大得多。月之暗面把目光投向了印尼,签下了一笔总价约1.5亿美元的租约,预订了一座印尼数据中心里的英伟达 Blackwell Ultra B300 集群,计划最早在2027年启用。据报道,这批卡正是为 K4 准备的。
当月之暗面在东南亚四处找卡时,杭州的 DeepSeek 选择了另一条路。
2024年7月,梁文锋在接受《暗涌》采访时说过一句话:「我们面临的问题从来不是钱,而是高端芯片被禁运。」
那年底,DeepSeek 发布 V3 ,在2048张 H800 上完成了训练,折算下来最终一次训练的成本仅约557.6万美元。技术报告说,整个训练过程「没有遇到任何不可恢复的 loss spike ,也没有做任何回滚」。
2025年1月20日,DeepSeek R1 发布,凭借强化学习带来的推理能力震动全球。但在 R1 之后,当同行纷纷出海租卡时,DeepSeek 却没有把主力训练搬出过国门。《金融时报》在2025年11月的报道中透露,DeepSeek 坚持在国内训练,华为的工程师常驻在它的杭州总部。
留在原地的代价,是实打实的阵痛与等待。
2025年,华为派了一支工程师团队进入 DeepSeek 办公室,协助它在国产昇腾芯片上训练下一代推理模型 R2 。据《金融时报》报道,训练撞上了稳定性、软件和芯片间通信慢等问题,R2 的发布一推再推,多模态生成模型的训练排期也相应后移。
外界当时只看到 DeepSeek 慢了下来,却很少有人读懂它在水下做的铺垫。
2025年8月,DeepSeek 发布过渡版本 V3.1 ,在发布说明里写道,该模型采用的 UE8M0 FP8 精度格式,是专门为「即将发布的下一代国产芯片」设计的。
2026年4月24日,打磨良久的 DeepSeek V4 终于上线。公司在发布公告里说受限于高端算力,V4-Pro 的服务吞吐有限,等下半年昇腾950超节点批量上市后,价格将会下调。
在2026年秋天的那个节点回看,一个四处找卡、把模型送进了全球开发者的工具链,一个留在国内死磕底层架构、替国产大集群趟雷。两条路共同构成了中国 AI 在过渡期里的双翼。
直到华盛顿决定把海外那扇门彻底焊死。
下午4点15分
门是在2026年11月的前两周里,一扇接一扇关上的。
先是口头吹风。11月3日,《金融时报》披露,英伟达的销售团队开始口头通知全球云服务合作伙伴,在新签的合同里,至少51%的产能必须卖给非中国客户。这条要求没有落在纸面上,却让东南亚的机房老板们面面相觑,在美国以外,上哪儿去找那么多非中国客户?
第二天,11月4日,甲骨文退掉了与腾讯在东南亚的一笔超级租约。那是一份为期五年、总价约70亿美元、涉及约10万张芯片的大单,告吹的原因是美国官员表示反对。
11月12日,执掌英伟达33年的黄仁勋因风波辞去 CEO 职务。这位曾公开说中国 AI 「只落后美国几纳秒」、直言美国出口管制「在很大程度上适得其反」的华人企业家,在这个敏感的深秋离开了牌桌。
11月16日,周一,美东时间下午4点15分,美国商务部工业与安全局将一份临时最终规则递进了联邦公报系统,标题叫《Addressing Remote Access to Advanced Semiconductors》(应对先进半导体的远程访问)。11月19日正式公布,当天生效。

远程访问先进半导体新规|图源:政府官网
巧合的是,同一天,美国总统特朗普正在深圳出席 APEC 领导人非正式会议,会后称赞他与中方领导人之间拥有「outstanding personal relationship」(出色的私人关系)。
新规的核心条款只有一条,全世界任何一座数据中心,只要给总部设在中国的公司(含其海外子公司)提供超过1200万 TPP 的算力,向这座数据中心运送先进芯片就必须事先拿到美国商务部的许可证。
1200万 TPP 折算下来,大约相当于750张 H100 芯片,体量大约是四五个机柜。
而训练一个万亿参数级别的前沿大模型,起步就是几千张乃至几万张卡。四五个机柜,连塞牙缝都不够。
对于目前已经在服务中国客户的海外存量数据中心,新规给出了90天的缓冲期去申请许可证,否则「将面临未来的出口限制」。从11月19日生效日起算,90天大限正好落在2027年2月17日前后。
新规里有一句推定条款,如果一座境外数据中心拒绝提供、或者提供不了客户尽职调查信息,这一行为本身就会被视为「Red Flag」,可以「推定」出口方「知情」。
换句话说,说不清机房里跑的是谁的代码,就默认你有问题。
印尼、马来西亚、新加坡、泰国、巴西五个国家被单独点名,往这五国运送先进 AI 芯片一律需要许可审批;如果买家是美国总部的公司,出口方按月提交报告即可豁免。
物理断供紧随其后。11月17日,英伟达财报电话会上,接替黄仁勋出任临时 CEO 的 Colette Kress 确认:「我们已不再向中国发运获得许可的 Hopper 数据中心产品。」另据《金融时报》报道,台积电和三星也暂停了对部分中国客户的出货,等待许可。
中国商务部对此表示强烈不满,宣布将采取反制措施;外交部发言人郭嘉昆直言,这是「典型的经济胁迫和长臂管辖」。
50%的押金
贸易规则落地的同一周,金融杠杆也开始收紧东南亚机房的钱袋子。
很多人以为东南亚遍地开花的 neocloud 背后站着挥金如土的财团,实际上,这是一门高度依赖债务的重资产生意。据彭博社统计,2023年以来,亚太地区数据中心公司累计拿到的贷款约490亿美元;一份半导体行业的研究简报测算,neocloud 项目七到八成的资金来自债务,常见的做法是,机房业主拿着大客户签下的长期租约,向银行贷款买英伟达的卡,再用收上来的租金还本付息。
在这个链条里,押金比例就是地缘政治风险的温度计。
在海外算力市场上,一个普通客户去租用英伟达 B300 服务器集群,行业通行的押金比例在15%左右。
而月之暗面在印尼签下那笔1.5亿美元的 B300 租约时,为了锁住这批2027年才能交付的卡,同意先付50%的押金。
到了11月初,据 CNBC 报道,月之暗面在欧洲洽谈租用8000张以上 Blackwell 芯片时,甚至有人提出,它必须比非中国客户多付30%到50%的预付款。
11月19日的新规,直接让这笔溢价失去了交易对手。
据 The Information 报道,新规出台后,月之暗面退掉了印尼那笔1.5亿美元的合同,并暂停了其他新交易的谈判。为 K4 准备的那批海外芯片,就此作罢。
比退租更麻烦的是银行的抽贷。
11月17日,彭博社曝出,新加坡云服务商 Aolani Cloud 一笔4.8亿美元的贷款被冻结。这笔钱原本要用来采购英伟达 GPU ,装进马来西亚一座为字节跳动服务的数据中心。据此前报道,两家在马来西亚合作的 B200 约有3.6万张。这笔贷款的牵头行是新加坡星展银行,新规风声一出,五家贷款方开始讨论退出。
而另一家云服务商 GMI Cloud 此前为了在泰国建设服务腾讯的算力设施,借了3亿美元,贷款条款清单里白纸黑字写着一旦腾讯被列入美国限制名单,贷款方有权要求提前还款。
东南亚各国政府在合规高压下纷纷后撤。马来西亚投资、贸易及工业部长 Johari Abdul Ghani 对 CNBC 表态:「想留在牌桌上,就得守美国的规矩。」泰国商务部副部长公开表示,未获美方批准的新建项目「可能无法完工」。新加坡数码发展及新闻部与贸工部发表联合声明,「不容许公司借与新加坡的关联来规避或违反他国法律」。
资本市场的反应很快,11月17日当天,马来西亚股市两只数据中心概念股盘中暴跌近20%,公用事业巨头 YTL Power 大跌近10%。
而在同一天的香港市场,中芯国际大涨7%。
其实,早在华盛顿关上大门之前,北京就已经开始主动引导产业往回走了。
2025年9月,网信办要求字节、阿里等公司停止采购和测试英伟达针对中国市场特供的 RTX Pro 6000D ;11月,国资数据中心项目被要求只用国产芯片;甘肃、贵州、内蒙古等西部算力枢纽省份,对采用国产芯片的数据中心给予最高减半的电费补贴。到了2026年1月,美方有条件放行 H200 之后,国内海关告诉报关代理,H200「不准入」。
一边是华盛顿给海外机房上锁,一边是国内坚定关上特供芯片的后门。持续了三年的外训内推,在太平洋两岸的双向切割下,走到了头。
卡被用户吃掉了
把视线转回国内。要理解2026年底这场大迁徙的紧迫感,得先看清国内实验室正在经历的另一种甜蜜而痛苦的煎熬。用户增长得太快,把研发用的卡都吃掉了。
2026年3月4日凌晨0点11分,阿里 Qwen 技术负责人林俊旸在 X 上发了简短的一行英文:「me stepping down. bye my beloved qwen.」
林俊旸的离开,官方口径是权责调整分歧,算力只是背景。但两个月前他在一场行业对话里倒出的苦水,道出了许多一线技术负责人的共同焦虑,他说光是应付日常的交付,就已经吃掉了团队绝大部分算力,真正留给前沿探索的卡捉襟见肘。
字节跳动内部同样在经历这种拉扯。
到了2026年8月,据《晚点 LatePost》报道,字节内部曾认真讨论过训练一个5万亿参数以上的超级模型,盘点完家底后发现,现有的算力储备「难再支撑多线并行的研发」,Seed 团队随后启动内部架构收敛。
为什么连字节和阿里这样最不差钱的巨头,都会觉得卡不够用?
因为2026年是中国 AI 应用真正走进国民日常生活的一年。春节过后,字节旗下豆包的日活用户一举突破2亿大关。高日活带来的是高昂的推理成本和运维压力,以至于向来擅长买量投流的字节,据 36 氪报道,今年豆包的投流预算很低,再继续拉新,推理的卡就更紧张了。
在大模型行业,预训练和日常推理抢的是同一池子算力。用户用得越起劲,留给下一代模型训练的卡就越少。
这种「幸福的烦恼」,在创业公司身上体现得更加惊心动魄。
2026年2月16日,智谱 AI 的旗舰模型 GLM-5 发布后,涌入的并发请求冲破了既定规划上限。尽管智谱此前已经几次扩容国产芯片集群,也限售了 Coding Plan 套餐,线上服务依然出现了排队和卡顿。智谱不得不公开征集芯片厂商、算力伙伴和推理服务商。
不自建机房、靠向云厂商采购的 MiniMax ,也在急剧追加预算。2026年8月26日,MiniMax 与阿里云签署补充协议,将2026年至2028年三年的年度采购上限,从原定的1.15亿、1.25亿、1.35亿美元,一口气上调至3亿、4亿和5亿美元。创始人闫俊杰在一档海外播客里坦言:「对于我们而言,尤其是对于一家中国 AI 公司来说,算力始终是一种约束。」
到了9月,连一向以工程效率著称的 DeepSeek 也开始引导用户分流。它将原本调用 V4-Pro 的请求转给新发布的 V4.1-Flash 。11月16日,「DeepSeek使用额度已达上限」冲上微博热搜,不少重度用户连续对话不到两个小时就碰到了上限。
看懂了这层供需关系,就能理解为什么2026年下半年国内的空气里总有一种微妙的蓄力感。
这几个月里,各家的小版本和 Flash 模型密集迭代,唯独超大参数的旗舰纷纷放慢了脚步。智谱在8月31日官宣了 GLM-6 ,没有给出具体上线日期;MiniMax 约3万亿参数的 Pro 版本,据报道原计划三季度亮相,至今未见;DeepSeek 发了 V4.1-Flash ,还没有 V4.1-Pro 。
与此同时,两年前那种不计成本的 API 价格战彻底熄火,据统计,2026年二季度,国内大模型 API 的平均输入价格比2025年一季度高出约48%,输出价格高出约80%;DeepSeek 高峰时段的输出价格,涨到了原来的4.5倍。
朱啸虎曾断言:「今年,可能是基础大模型的最后一年。」
但在我们看来,这个结论恰恰把因果倒置了。
旗舰模型放慢发布节奏、API 价格回归理性,从来不是因为基础模型摸到了天花板,而是因为中国大模型走出实验室、真正进入了数以亿计的真实场景和全球开发者的工具链。
研究机构 Epoch AI 统计,2022年至2026年年中,全球新增的 AI 算力里,中国拿到的份额只有大约十分之一;但全球最大开源社区 Hugging Face 的统计显示,2025年2月至2026年2月间,全平台四成以上的模型下载量来自中国团队研发的模型。
用全球十分之一的增量算力,撑起了全球四成以上的开源模型下载和国内数亿人的日常调用。
不仅如此,算力的刚性约束,反而逼出了中国工程师在架构优化与系统工程上的硬功夫。财新引述的一位业内专家判断,经过 harness 深度调优的小模型,能用大约4%的成本,拿到大模型接近90%的能力。
正如 SemiAnalysis 的 Dylan Patel 在11月新规落地前几天所评价的那样:「论能力,月之暗面大概和美国实验室一样好,他们只是在算力和部署上有很大缺口。」
现在,这群最懂得如何省着用卡的工程师,要集体搬回国产芯片的地基上了。
精度对齐
从英伟达的 CUDA 生态搬回国产算力底座,不是发一纸行政命令就能完成的搬家,它首先是一场极其硬核、细致到每一个比特的底层工程攻坚。
在芯片和框架工程师嘴里,回家之后的第一道鬼门关,叫「精度对齐」。
理想状态下,同一个模型架构、喂进去同一批训练数据,放在英伟达的 GPU 上跑和放在华为昇腾的 NPU 上跑,画出来的两条 loss 下降曲线,应该像两页描红纸一样严丝合缝地叠在一起。
但在真实的工程世界里,只要底层硬件的数值精度或者通信算子的归约顺序有一丁点差异,两条曲线就会差很多。
科大讯飞是最早把这套苦功夫啃下来的中国公司之一。
在2026年4月的投资者关系活动记录表里,讯飞把两代硬件的客观差距摆了出来,当时主力使用的昇腾910B 单卡显存是64G ,而英伟达 H200 是141G ;显存带宽一边是1.6TB/s ,另一边是4.8TB/s 。开箱状态下,讯飞在910B 集群上的训练效率,只有同规模英伟达 A800 集群的30%左右。
讯飞跟华为深度合作,一个算子一个算子地重写、调优。2025年里,他们硬是把长思维链强化学习的训练效率从30%拉升到了84%,昇腾原生 MoE 模型的全链条训练效率提到了93%。即便如此,客观的适配周期依然存在,讯飞在记录中写道,当国际上冒出一种新的主流算法时,在N卡上直接就可以做,在国产卡上却需要额外解决算子库效率优化等一系列问题,通常要多花3到6个月的适配周期。
2026年10月,科大讯飞董事长刘庆峰说:「我们并不希望讯飞是唯一一个在国产算力上做训练的。」
刘庆峰没有等太久。当年选择留在原地的 DeepSeek ,在这个秋天把这条路往前铺了一大段。
回过头看,DeepSeek 在2025年经历的那次 R2 迁移挫折,非但不是一次溃败,反而成了整个中国大模型行业最宝贵的一次投石问路。
2026年4月 DeepSeek V4 发布当天,昇腾芯片就在第一时间实现了推理支持,其专家并行的核心 kernel 在英伟达和昇腾两套硬件上都完成了验证。到了7月,一支由华为牵头、深圳河套学院等机构参与的攻关团队对外披露,他们在约1000张昇腾910C 组成的集群上,完整跑通了 DeepSeek V4-Pro 1.6万亿参数模型的全参数后训练,连续运行约一个月,迭代1500多步,全程「无跳步无NaN」,模型算力利用率稳定在34.9%,每一步耗时27秒。
9月30日,国庆节前一天,DeepSeek 正式宣布开源一整套面向昇腾平台的底层核心组件,从 TileLang 编译工具、计算库到分布式通信库,与英伟达版本一一对应。
为了迁就国产芯片的内存访问特性,DeepSeek 甚至主动修改了自己招牌的 FlashMLA 注意力实现里的 KV cache 内存布局,把数值和缩放因子打包存在一起,只为了让昇腾芯片少搬几趟内存。
在过去的硅谷范式里,永远是模型公司顺着英伟达定义好的硬件架构写代码;而在2026年的杭州,顶尖模型实验室开始为了国产芯片的特性,主动重构自己的底层算子。
不仅如此,华为与 DeepSeek 还在联合共建基于昇腾950的128卡超节点。
SemiAnalysis 的实验室在今年点亮并实测了一张华为昇腾950PR 测试芯片。功耗203.3瓦,核心温度56摄氏度,板载128GB HBM 高带宽内存只用了5GB 出头;满载运行时功耗约600瓦,在最考验硬实力的计算密集型矩阵乘法上,它的实测利用率能跑到理论上限的41.5%,作为对比,英伟达经典的 H100 是46.8%。
除了 DeepSeek ,整支中国大模型舰队都在完成底层代码的换血。月之暗面的 Kimi K3 从监督微调阶段起就引入了量化感知训练;智谱的 GLM-5 在发布第一天,就同步完成了对华为昇腾、寒武纪、海光、昆仑芯等七家国产芯片的适配;在各大实验室的代码库里,纯 CUDA 算子越来越少,TileLang 这类跨平台的写法越来越多。
太平洋两岸的两棵科技树,正在从最底层的精度格式和内存布局上,长出各自独立的根系。
乌兰察布的冬天
2022年2月17日,国家发改委等四部门联合印发文件,在京津冀、长三角、粤港澳大湾区、成渝、内蒙古、贵州、甘肃、宁夏8个地区启动建设国家算力枢纽节点,并规划了10个国家数据中心集群,「东数西算」工程从那一天全面启动。
历史有时会有惊人的巧合。差不多整整五年后的同一天,2027年2月17日前后,恰好是美国新规给海外存量数据中心画下的90天大限。
五年前,当文件里写下和林格尔、庆阳、贵安、中卫这些西部与北方地名时,很多人以为那只是一项常规的能源调配工程,东部的土地和能源越来越紧,而西部和塞北有吹不完的风、晒不完的太阳。
五年后,当海外的机房大门关上,人们抬头才发现,承接中国 AI 北归的基地,已经在北方的草原、黄土塬和西南的山洞里提前铺开了。
在甘肃庆阳,昔日的黄土塬上立起了一座座智算中心,阿里千问、智谱和 Kimi 的训练与推理任务在这里昼夜吞吐。
在贵州贵安,腾讯把核心数据中心直接建进了山洞里,厚重的岩体一年四季恒温15摄氏度;华为云新增的昇腾卡有八成以上运往了贵安,这里也有华为最大规模的 CloudMatrix384 昇腾超节点部署。半个多世纪前,贵州的崇山峻岭里藏着轰鸣的三线工厂;半个多世纪后,同一片大山里,装进了一排排闪烁着指示灯的国产算力。
在内蒙古和林格尔,今年10月14日,全球首个昇腾950DT 万卡池正式宣布,当时正在系统联调,单栋机楼就能装下3万卡的集群。
而在这场向北的大迁徙中,最繁忙的驿站,叫乌兰察布。
乌兰察布在蒙古语里意为「红色的山口」。它距离北京约350公里,坐高铁不到两个小时就能到。这里海拔高,年平均气温只有4.3摄氏度,一年里很长一段时间,可以直接用室外的冷空气给机房降温。
城南起伏的草原上,数据中心一座挨着一座。远景科技集团在这里建设的「星河」园区总规划达800MW ,首期120MW 在一年内就完成了交付,建造成本只有美国同类项目的五分之一。
乌兰察布过去出名的一种作物是土豆。远景创始人张雷说,他想让大模型的 token 变得「像土豆一样便宜」。

2007年夏季辉腾锡勒草原风电场|图源:Steven Buss
11月下旬的乌兰察布,夜间气温常常下降到零下十度。塞北的风掠过城南的草原,推着上百米高的风机缓缓旋转,电流顺着输电线路汇入恒温恒湿的机房,点亮一排排刚刚上架的机柜。
南方柔佛海峡湿热的雨季还在继续。
按照节令,候鸟要等到来年开春才会北归;这一次,算力走在了它们前面。