从模糊目标中找到正确的方向,并在这种场景下自我进化。Self-Developing Agents 用三项基准研究这个过程。
人学习一项新工作时,往往没有现成的题库和评分标准。比如,想成为更好的物理学家,需要根据个人当前水平,决定该补哪些数学知识、学习什么新的物理理论,或掌握哪种实验方法。让 AI 像这样学习,是字节跳动 Seed、TokenWave 等机构研究者在 Self-Developing Agents 项目 Blog 中提出的研究方向。团队希望 Agent 能在工作中逐步胜任一个角色,并将反复处理实际问题的经验积累成可复用能力。
这也是递归式自我改进(Recursive Self-Improvement,RSI)需要真正补上的一部分。当前常见的一些设定,其实并不是真正的 RSI——「半环 RSI」:假设有一个可靠的 Golden Verifier,持续判断结果、指引改进方向。Agent 可以沿着反馈优化,但学习目标和判断依据已经由外部准备好了。而更完整的闭环还要处理前面的判断和后面的积累。迭代过程中,宽泛目标需要变成具体行动(train or harness 修改),不完整的反馈需要变成可用经验,经过验证的改动需要进入模型、记忆或执行系统,以继续迭代后续工作。ASPIRE、S³Gym 和 HarnessDev 分别研究其中的三个问题:Agent 应该如何从模糊目标中学习,能否从经验中学习,以及 Harness 改进能否保留下来。
ASPIRE:从模糊目标中找到该学的东西
论文:https://arxiv.org/abs/2608.31111
项目与 Blog:https://self-developing-agents.github.io/
「提高某套数学测试的分数」已经给出了明确的优化对象。相比之下,「提高数学推理能力」则留下了更多的决策点和空间:先补哪一类短板,找什么数据,用什么方法训练,又怎样检查训练有没有用。
ASPIRE 从后一种目标出发。Agent 只能看到自然语言描述的能力方向,学习材料、更新方法和验证方式都要自己选择。研究者用覆盖多类能力的专家原创题检查这些选择的效果,题目、答案和逐题反馈不向 Agent 开放。它包含 6 个能力目标、520 道专家编写的隐藏评测题,以及一个支持权重和 Harness 更新的最小交互环境。它还提供 48 对「模糊目标/明确任务」匹配运行及可审计轨迹。

图 1:明确任务中,优化对象由人给定;模糊目标中,Agent 还要决定学什么、如何验证。外部评测检查它选择的方向是否改善了目标能力。来源:ASPIRE,原论文图 1。
S³Gym:判断自己的行为,再从中学习
论文:https://arxiv.org/abs/2608.31100
项目与 Blog:https://self-developing-agents.github.io/
没有老师逐步打分时,Agent 要从自己的尝试中判断哪些行动有效。S³Gym 将自我测试、自我判断和自我改进放在七个文字游戏中研究。探索时,Agent 能观察环境变化,但看不到程序验证器给出的真实步骤奖励和最终分;之后再用更严格的条件和另一组随机种子检验它的表现。测试记录不会回流为学习材料。

图 2:S³Gym 用人类学习的过程说明三个研究环节:主动尝试、判断与总结,再通过上下文、记忆或训练改善后续行为。左侧为概念类比,不是人类对照实验。来源:S³Gym,原论文图 1。
Agent 「知道自己做得好不好」的能力很弱:一个重要发现是,自我判断的准确程度没有稳定对应到后续收益。Agent 能判断当前行动做得怎么样,却未必能据此调整下一次行动。论文将判断质量与后续表现分别测量,发现两者的关联很弱;这不说明自我判断没有用,而是说明它还没有被可靠地转化为学习收益。
经验也没有一种通用的保存方式。在所测模型和游戏中,原始历史与摘要记忆各有优势,同一种方法换个环境就可能失效。轨迹分析给出的解释是:有些经验可以概括成可重复使用的策略,有些则依赖精确的状态和操作细节。摘要保留了前一类信息,却可能遗漏后一类信息。更新模型参数能让部分经验进入模型,但也可能损害原有能力。同一条训练轨迹中,模型在信任博弈上取得了收益,在植物大战僵尸中却持续退步,其他一些游戏没有改善。研究观察到了这种差异,尚未确定退步的唯一原因。
因此,S³Gym 把经验的价值放到后续行动中检验。复盘是否准确、经验以什么形式保存、下一次是否做得更好,需要分别检查,不能用一份看起来合理的总结代替学习效果。
HarnessDev:把改进留在系统中
论文:https://arxiv.org/abs/2609.01437
项目与 Blog:https://self-developing-agents.github.io/
HarnessDev 让模型创建并持续修改自己的执行系统,观察这些改动能否在后续任务中继续发挥作用。创建阶段覆盖代码、机器学习实验、写作和搜索研究,演化实验则追踪系统修改后的表现。这里需要区分模型本身的能力与执行系统带来的效果。研究将开发系统的模型和执行任务的模型分开,并在执行模型固定、权重不变的条件下观察改动。除了任务表现,研究还追踪新机制是否实际参与运行,例如写入代码的记忆和状态保存是否真的被调用。
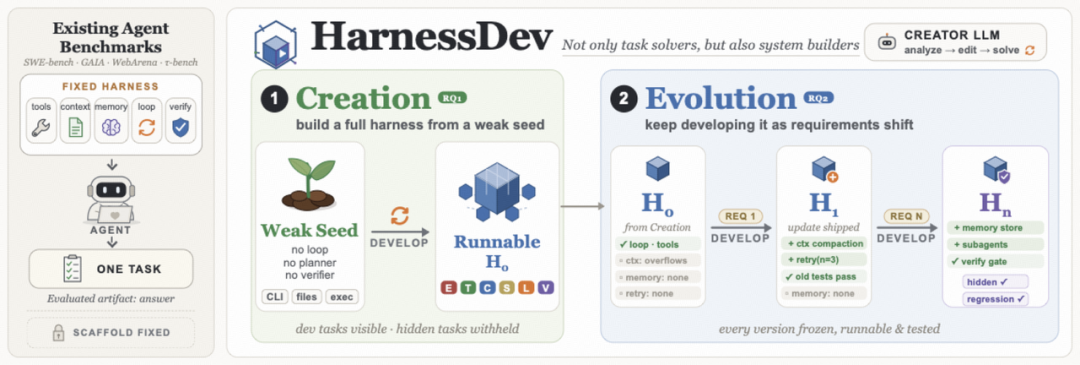
图 3:HarnessDev 的两个阶段。Creation 从基础程序创建可用系统,Evolution 根据运行反馈继续修改系统;各正式版本冻结后再评测。图中的需求变化为设计示意,本文所述演化实验使用固定反馈任务集。
让 Agent「持续自我修改」,往往会 overfit 自己的反馈。开发时得到的正向反馈,并不总能延续到未见任务: 在固定 Gemini 执行的 Qwen、DeepSeek 两条轨迹中,选定版本在可见反馈上都有改善,隐藏任务表现却都下降了。这些隐藏分数在开发结束后才计算,未返回给创建者,因此揭示了开发反馈没有反映出来的问题。系统修改还可能破坏原有功能。论文中的消息清理、上下文压缩改动曾打乱合法的工具消息序列,部分修改随后被回滚。对当前任务有帮助的调整,是否适合长期留在系统里,需要额外检查。
HarnessDev 由此强调对持久改动的验证:新机制要在运行中生效,改进要能迁移到未参与开发的任务,必要时还能恢复到先前版本。目前这些演化观察主要来自代码任务,隐藏评测覆盖 SWE-Pro,各配置为单条轨迹,尚不足以判断长期收益是否稳定。
哪些改动值得留下来
Self-Developing Agents 从目标形成、经验吸收和系统演化三个层面,系统讨论了 Agent 如何从「被动执行任务」进一步走向「持续自我改进」。ASPIRE、S³Gym 和 HarnessDev 的实验共同表明,当前 Agent 已经具备一定的自我训练、自我总结和自我修改能力,但真正的瓶颈并不在于「能不能改」,而在于能否准确判断「该改什么、什么经验值得吸收,以及改完之后是否真的变得更好」。
现阶段最突出的问题是代理目标与真实目标之间的错配,以及对局部反馈和可见指标的过拟合。未来,Self-Developing Agent 的核心可能不再只是更强的模型或更复杂的 Harness,而是建立更可靠的目标形成、验证和保留机制,使 Agent 能够在长期运行中持续筛选有效经验,并将真正可泛化的改进沉淀为稳定能力。
作者介绍
本文的第一作者为新加坡科学与设计大学大学博士生吴宇皓,师从张雯轩教授,研究方向为Long-context LLM,曾在 ICLR、NeurIPS、ACL、EMNLP 等国际会议上发表多篇论文。

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com