
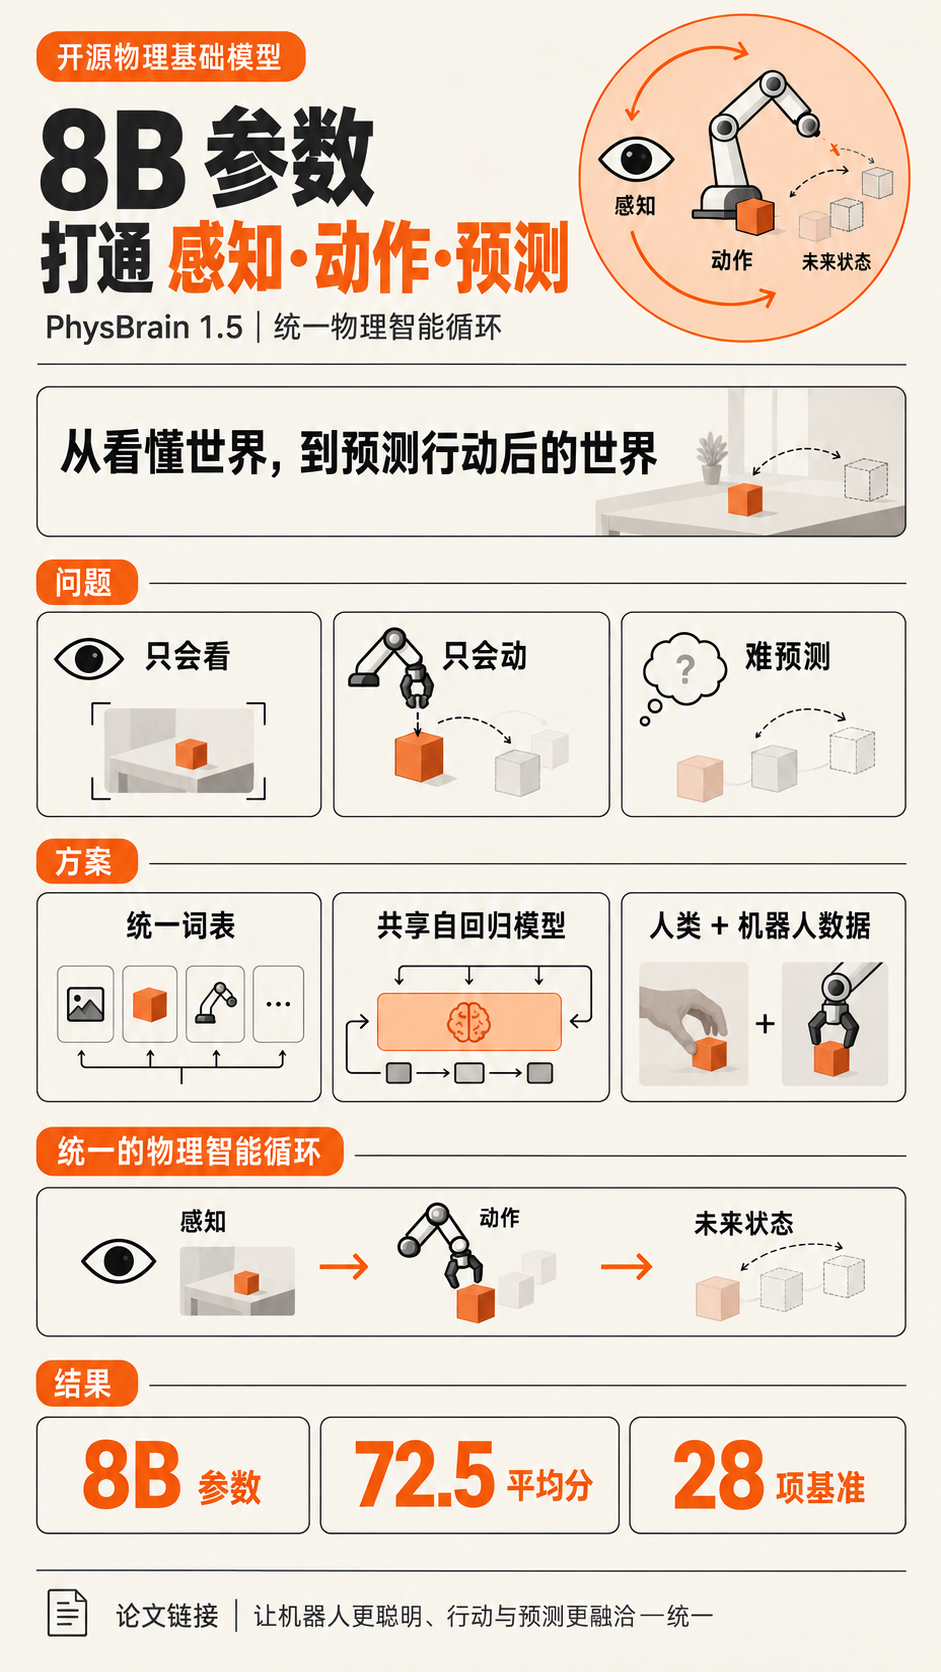
在日常的机器人操作场景中,无论是机械臂组装电子元件、人形机器人整理家居,还是服务机器人为用户递取物品,都需要同时完成三项核心任务:先准确感知周围环境的空间结构与语义信息,再结合任务目标生成合理的动作序列,最后还要预判动作执行后环境的变化。此前的相关模型往往只能覆盖其中一到两项能力,或是通过多模块拼接的方式实现全流程,模块间的适配成本高,也难以做到信息的充分联动。

论文标题:PhysBrain 1.5: From Vision-Language Models to Physical Foundation Models
论文链接:https://arxiv.org/pdf/2609.14973.pdf
项目主页:https://deepcybo-physai.github.io/PhysBrain-1.5
HuggingFace地址:https://huggingface.co/collections/DeepCybo/physbrain-15
评估套件地址:https://github.com/DeepCybo-PhysAI/PhysBrainEvalKit
研究背景
物理智能的核心是智能体与环境的交互循环:智能体观测周边环境,解读空间关系与任务目标,预判动作执行的结果后向环境施加动作,变化后的环境又会提供新的观测信息,支撑后续的理解与行为决策。一个成熟的物理基础模型,需要为这个循环的每个环节提供可复用的能力支撑。
此前相关研究沿着两个方向推进:
通用视觉语言模型具备较强的视觉理解、语义知识储备和指令遵循能力,但缺乏空间推理、动作生成等面向物理交互的能力; 专用机器人模型虽然可以完成特定的动作生成或规划任务,但语义理解能力薄弱,泛化性有限。
近年出现的具身基础模型开始尝试整合多类能力,但很少能将环境理解、动作生成、未来状态预测三类核心任务纳入同一个统一的学习框架,实现信息的充分联动和联合优化。
针对这一现状,DeepCybo团队推出了PhysBrain 1.5,这是一款统一的物理基础模型,能够同时支持物理环境理解、动作生成和未来状态预测三类核心能力,在小参数规模下实现了与头部闭源模型相当的性能表现。
核心设计思路
PhysBrain 1.5基于Qwen3-VL Instruct 8B版本构建,核心设计思路是将语言回答、末端执行器运动、稠密视觉目标全部编码为离散序列,通过统一的自回归接口完成三类任务的联合学习。三类输出共享大语言模型的backbone、词元嵌入和输出头,团队在原有语言词表的基础上,额外扩展了专门的动作词元和视觉词元,形成统一的多模态词表。

具身理解能力的实现没有新增独立的感知头,而是保留了基础视觉语言模型的通用图像、视频理解接口,通过具身相关的监督数据增强相关能力,根据任务的不同,同一个自回归解码器可以输出自然语言回答或者结构化的空间目标,语义识别、空间定位、时序推理能力都通过统一的接口输出,可以为动作生成和未来状态预测提供场景层面的信息支撑。
动作生成方面,团队将人类和机器人的动作都统一表示为末端执行器的短轨迹,每个轨迹包含未来16步的动作,用相对位置和6D旋转表示空间位姿,再通过ActionPiece分词器将连续的轨迹编码为离散的动作词元。针对不同数据源动作坐标系、控制频率不一致的问题,团队没有强行将所有动作转换到统一的全局坐标系,而是保留各数据源的原生坐标系,将当前观测之前的16步动作作为局部运动上下文输入模型,让模型自动推断当前本体的动作规则,实现动作轨迹的自然延续,大幅降低了跨数据源的处理成本。
未来状态预测方面,模型将未来的物理状态表示为空间对齐的RGB图像、深度图和机器人掩码组合,三个模态的输入都通过共享的VQ-VAE编码为离散视觉词元,再按照空间位置交错排列为序列,保证三个模态的空间对应关系。推理阶段生成的视觉词元序列可以解码为对应的三类输出,完整呈现未来的场景外观、空间结构和机器人位姿。
三类任务使用同一个掩码下一词元预测目标进行优化,不同任务通过掩码选择需要监督的目标词元,实现共享参数的联合更新,三类任务的监督信号可以形成互补,感知类任务提供语义和空间上下文,动作类任务引入运动先验,未来预测类任务强化物理变化规律的学习。
两阶段数据构建方案
PhysBrain 1.5的训练分为物理感知预训练和具身监督微调两个阶段,两个阶段都同时覆盖感知、动作、未来预测三类任务的监督数据。
物理感知预训练阶段的所有具身监督数据都来自人类交互视频,团队整合了公开的Ego4D、EgoExo4D、Xperience-10M等数据集,以及自研的PhysBrain-Human、PhysBrain-Ego360数据集,覆盖第一视角、第三视角、全景视角下的日常活动、工具使用、人机交互等场景,总时长约3万小时。团队将长视频按任务边界分割为独立的任务片段,从中构建三类训练数据:2430万条物理感知数据,包含结构化标注、描述、问答对;3120万条人类动作数据,包含从视频中恢复的手腕末端执行器轨迹;2680万条未来状态数据,包含交互前后的场景RGB、深度图和人体掩码。此外预训练阶段还加入了1490万条通用语言和视觉语言指令数据,保证模型保留通用多模态能力。
具身监督微调阶段混合了高质量人类交互数据、真实机器人轨迹和仿真交互数据,覆盖单臂、双臂、仿真等多种平台的操作任务。其中包含661万条具身理解数据,覆盖空间感知、多视图理解、推理规划、空间定位等能力;540万条动作数据,总时长约3114小时;120万条未来状态数据,对应机器人场景下的交互后状态。此外微调阶段也加入了100万条通用多模态指令数据,避免模型在适配具身任务的过程中丢失通用能力。
评估结果与性能表现
团队从四个维度对PhysBrain 1.5进行了全面评估,分别是具身理解能力、通用多模态能力、动作轨迹生成能力和未来状态预测能力。
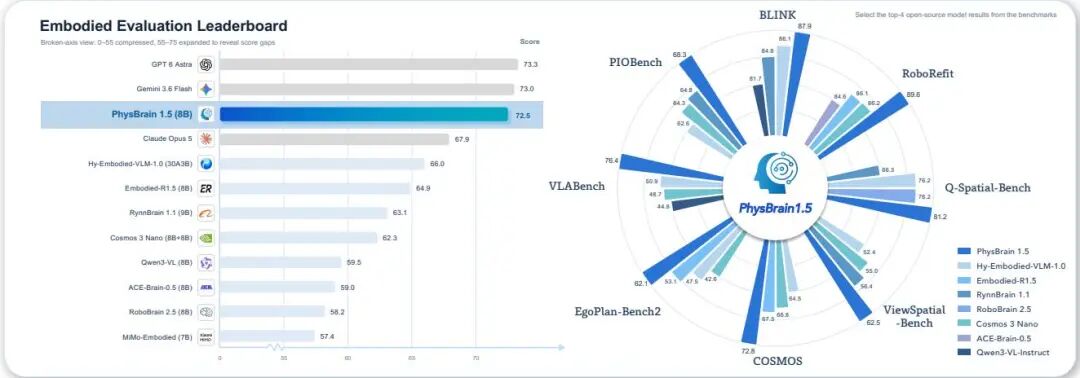
具身理解能力评估覆盖了28个主流基准,分为视觉空间感知、空间与多视图理解、具身认知与规划、空间定位与可供性、视觉轨迹推理五个类别。结果显示,PhysBrain 1.5的平均得分为72.5,是目前开源模型中的最高水平,比此前最强的开源基线高出6.5分,在14个基准上拿到开源第一,24个基准进入开源前两名。值得注意的是,8B参数的PhysBrain 1.5整体性能已经非常接近头部闭源模型,仅比Gemini 3.6 Flash低0.5分,比GPT-6 Astra低0.8分,比Claude Opus 5高出4.6分,具备很强的竞争力。

通用多模态能力评估覆盖了12个主流的图文、视频理解基准,结果显示PhysBrain 1.5的整体表现与底座模型Qwen3-VL Instruct 8B相当,在图表理解、细粒度识别等任务上还有小幅提升,说明具身训练没有损失模型的通用能力,反而强化了部分推理相关的能力。
超越理解的物理交互能力
除了理解类任务之外,PhysBrain 1.5还具备动作轨迹生成和未来视觉预测的能力,覆盖了物理交互循环的全环节。
动作生成方面,给定当前RGB观测、任务指令和前序16步的真值动作序列,模型可以自回归生成接下来16步的动作词元,解码后即可得到末端执行器的轨迹。在训练分布内的场景中,模型预测的轨迹和真值轨迹的方向、形状高度吻合;在训练未覆盖的分布外场景中,模型也能预测出符合任务逻辑的大致运动趋势,不需要针对特定机器人做额外的微调。


未来状态预测方面,给定当前RGB观测和任务指令,模型可以预测1秒后的场景状态,输出空间对齐的RGB图像、深度图和机器人掩码。预测结果可以保留原场景的整体布局,同时呈现符合任务逻辑的场景变化,三个模态的输出空间一致性较高,能够完整呈现未来的场景外观、 workspace几何结构和机器人位姿。

总结与展望
PhysBrain 1.5验证了将具身理解、动作生成、未来状态预测纳入统一自回归框架的可行性,通过从大规模人类交互视频中学习物理先验,再结合多来源的机器人数据微调,可以在小参数规模下实现与头部闭源模型相当的具身能力,同时保留通用多模态能力。这一研究也证明了从人类交互经验中学习,是发展物理智能的有效路径。
后续团队将继续扩大训练数据的规模,扩展模态覆盖范围,加入更多真实交互的经验,进一步提升模型的物理智能水平,支撑更复杂的机器人交互场景落地。
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群



