点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
一、2026年立体匹配的格局:四条技术路线的竞逐
立体匹配正在经历一场静默的范式转换。2026年的顶会舞台上,四条技术路线同时推进,每条路线的背后都代表着对“如何从一对图像中恢复密集深度”这个经典问题的不同回答。
第一条路线是基础模型的规模化。 FoundationStereo、DEFOM-Stereo、MonSter++等工作将视觉基座模型引入立体匹配,用大规模预训练特征替代传统编码器,显著提升了零样本泛化能力。MonSter++更是在PAMI 2026上提出了统一立体匹配、多视图立体和实时立体的几何基础模型框架,通过置信度引导的自适应选择来修正单目深度的尺度模糊,实现了粗粒度物体级单目先验到细粒度像素级几何的迭代互增强。
第二条路线是迭代范式的重新设计。 PromptStereo在CVPR 2026上提出了一个尖锐的观察:迭代精炼阶段的零样本泛化能力被严重低估了。传统GRU式架构的表征容量有限,无法充分利用单目深度先验,导致迭代精炼在跨域场景中表现不佳。PromptStereo用Prompt Recurrent Unit(PRU)替换GRU,将单目深度基础模型的DPT解码器直接作为迭代精炼模块,通过结构Prompt和运动Prompt注入单目结构线索和立体运动线索,在保持单目深度先验的同时丰富了立体尺度的绝对信息。
第三条路线是架构的极致简化。 WAFT-Stereo在ECCV 2026上提出了一个颠覆性的观点:代价体积可能不是必需的。该方法仅用warping操作替代代价体积构建,在ETH3D上把零样本误差降低了81%,同时比竞争方法快1.8-6.7倍,在ETH3D、KITTI和Middlebury三个公开基准上排名第一。
第四条路线是效率的工程化。 Fast-FoundationStereo在CVPR 2026上直面了基础立体模型实时部署的难题。它通过知识蒸馏压缩混合backbone、块级NAS自动搜索代价滤波设计、结构化剪枝消除迭代精炼模块的冗余,并辅以140万真实立体图像对的自动伪标注流程,在保持接近原始零样本精度的同时实现了10倍以上的加速,首次在实时帧率下实现了强零样本泛化。
四条路线各有取舍。 规模化路线追求精度上限,迭代重设计路线追求泛化能力,简化路线追求速度与简洁,工程化路线追求部署可行性。但有一个维度被系统性地忽视了:达到收敛所需的迭代次数本身。

LinStereo正是在这个维度上找到了突破口。悉尼大学澳大利亚机器人中心的Yiran Wang、Oliver Turner和Viorela Ila在ECCV 2026论文中提出用位置感知线性注意力模块替代卷积迭代,让每轮迭代都能聚合全图上下文,并辅以多尺度代价体积和单目深度初始化提升几何收敛。更关键的是,LinStereo在冻结视觉基座模型编码器、仅用SceneFlow合成数据训练下游stereo模块的条件下,其零样本泛化能力就将Middlebury遮挡区域误差压低了37%,在多项标准评估数据上以ViT-B的体量战胜了更大参数量的模型,甚至在水下等跨域场景也展现了明显的优势。

二、三个信息通路的系统性浪费
论文开篇即指出,现有VFM-based迭代立体匹配方法在三个维度上存在信息利用不足:
其一,多尺度特征被压成单层相关。 backbone输出了多层不同分辨率的特征(例如1/4、1/8、1/16),但建cost volume时通常只取其中一层,其余层的信息在后续迭代中完全不可访问。这相当于把一台高分辨率相机拍的照片压缩成了一张缩略图再用。
其二,几何先验在初始化阶段被闲置。 DA3本身的深度预测分支已经给出了相当可靠的单目深度,但现有方法依然从零视差起步,头几轮迭代白白浪费在恢复场景大致布局上。
其三,上下文只沿局部传播。 ConvGRU每轮迭代的感受野有限,可靠匹配从纹理丰富区域扩散到弱纹理或遮挡区域需要大量迭代。在光度线索退化严重的水下场景中,这种局部传播甚至可能完全失效。
这三个断层在水下场景中被急剧放大——波长相关的衰减、体积散射、折射畸变严重破坏了立体视图之间的光度一致性。LinStereo的目标就是用一个统一解码器同时修复这三个通路。
三、PALA:全局注意力,但只要线性复杂度
3.1 从局部递归到全局聚合
PALA的核心动机可以用一句话概括:让每个像素在每次迭代中都能看到整张特征图。
ConvGRU式的更新算子每轮只在一个局部窗口内聚合上下文。这意味着在纹理丰富区域获得的可靠视差估计,需要经过多次迭代才能“扩散”到远处的弱纹理区域。在遮挡区域和光度退化区域,这种局部扩散可能永远无法到达。
PALA用线性注意力实现全局聚合。关键的技术处理是kernel化:对query和key施加非负kernel函数 (通常为ELU+1),利用矩阵乘法的结合律,将softmax注意力的 复杂度降为 ,其中 是注意力头的维度。这比像素数 小两个数量级,因此整体复杂度对 是线性的。
实测数据:在480×640分辨率、单张NVIDIA RTX 4500 GPU(24GB)上,PALA一次迭代耗时 3.50 ± 0.05 ms,RAFT-Stereo的ConvGRU耗时 3.63 ± 0.06 ms,IGEV的ConvGRU耗时 3.43 ± 0.03 ms。PALA的迭代成本与ConvGRU基本持平,但聚合范围从局部窗口扩展到了整张特征图。
3.2 位置感知:非对称RoPE的巧妙设计
线性注意力有一个已知的副作用:kernel化之后,注意力输出对所有query位置是“位置无关”的——因为 被预计算并共享给了所有query,空间关系被全局summary抹平了。在立体匹配中这个问题尤其严重:相邻像素通常共享相似深度,视差不连续处往往与物体边界对齐,一个“位置盲”的注意力机制无法区分这些情况。
PALA的解法是引入2D旋转位置编码(RoPE)。但这里有一个巧妙的设计:RoPE只加在注意力公式的分子上,分母不加。公式如下:
其中 ,,而分母中的 和 (key的均值)保持原始形式。论文将这种处理称为非对称RoPE——分子端编码相对空间关系,分母端保持位置无关的归一化稳定性。
消融实验验证了这一设计:KITTI 2015上,对称RoPE的EPE为1.05,非对称RoPE为1.01;TartanAir-UW上差距更大,RMSE从2.18降至2.08,降幅接近5%。
3.3 门控更新:在可靠与不可靠之间做取舍
立体匹配中correlation evidence是非均匀的:纹理丰富区域给出强而明确的匹配,遮挡或弱纹理区域产生噪声信号。PALA引入了一个门控机制来控制信息流入:
这个门控允许每个位置在匹配置信度高时积极吸收新证据,在不可靠时保留累积估计。可靠视差通过全局注意力逐步传播到不确定区域。

四、HSCV与DPI:让全局注意力真正发挥作用
PALA的全局聚合能力需要两个组件来“喂”它正确的信息。论文反复强调:这不是三个独立模块的简单堆叠,而是一个PALA中心的统一解码器,HSCV和DPI是让PALA有效运作的必要条件。
4.1 HSCV:多尺度语义匹配
现有方法在固定分辨率(通常是1/4)上构建单一correlation volume,匹配被限制在一个狭窄的语义带宽内。HSCV的做法是:在每个VFM尺度上分别构建correlation volume,且保持所有尺度同时可查询。
对于每个下采样因子 ,首先通过instance-normalized residual blocks和1×1卷积将特征投影到统一通道维度,然后沿极线计算1D correlation:
每个尺度的correlation volume进一步组织为4级视差金字塔,沿视差维度重复下采样,在保持空间分辨率的同时提供逐级扩大的搜索范围。
这形成了一个双层匹配层次:跨语义尺度和尺度内的视差金字塔。PALA的每一轮迭代都可以根据自己的操作分辨率重新查询任意尺度的correlation信号,而不是像coarse-to-fine cascade那样一次性消费粗尺度信息后丢弃。

4.2 DPI:从单目深度获得度量校准的起点
DA3的深度融合分支输出的是仿射不变的单目深度。虽然metric monocular模型(如Depth Pro、Metric3D v2)可以直接输出度量深度,但它们的绝对尺度是一个统计先验,在out-of-distribution场景(如水下)中会显著漂移。仿射不变模型则避免了这种承诺,保留了跨域更稳健的相对结构。
DPI的做法是利用标定立体对本身提供的几何对应关系来恢复度量尺度。具体来说,在立体对上提取SIFT关键点并沿极线匹配,得到稀疏参考 ,然后通过最小二乘求解尺度-偏移对齐:
得到初始视差图 。当内点匹配数低于20时,回退到零视差初始化。
论文特别指出, 只是一个粗热启动——VFM深度不严格遵循全局仿射模型,手工匹配也引入定位噪声。PALA的迭代精炼才是恢复精细视差的关键。DPI的价值在于让迭代从一个几何上合理的状态起步,而不是从零视差开始浪费早期迭代。
五、线性注意力的视觉应用脉络
PALA的设计不是孤立的创新。2026年,线性注意力正在成为视觉基础模型的主流选择,一系列工作正在系统性地解决线性注意力在视觉任务中的核心难题——如何在保持效率的同时恢复空间结构。
小鹏集团发布的TuringViT提出了Turing Linear Attention(TLA),打造了“线性注意力主导 + 高质量数据治理 + 原生动态分辨率”的完整技术体系。TuringViT-18L包含3组Turing Block(共15层TLA+3层MHA),在1536×1536分辨率下的推理吞吐量达到Seed1.5-ViT的3.04倍,相比SigLIP2-ViT-L提升2.16倍。更值得注意的是,TuringViT仅用0.85B图文对(约为SigLIP2-L训练数据规模的10%)就在ImageNet-1K上达到了可比性能。
PALA与TuringViT的思路高度一致:线性注意力不是简单地替换softmax注意力,而是需要针对具体任务重新设计位置感知机制。TLA通过原生动态分辨率来保持空间结构,PALA通过非对称2D RoPE在注意力计算中编码相对空间关系。两者从不同角度回答了同一个问题——线性注意力如何在视觉任务中不丢失空间结构。
LINA(2026)则从生成任务的角度验证了线性注意力的可行性,完全基于线性注意力实现了1024×1024高保真图像生成,相比softmax注意力实现了61%的计算节省。这些工作共同构成了线性注意力在视觉领域系统性推广的技术脉络,PALA是这一脉络在立体匹配任务上的最新延伸。
六、实验验证:ViT-B体量战胜更大参数量的模型
6.1 标准基准:遮挡区域误差降低37%
LinStereo在五个标准立体基准上进行了评估:KITTI 2015、KITTI 2012、Middlebury(H)、ETH3D、Booster(Q)。所有评估均在无额外训练数据的条件下进行(仅使用SceneFlow训练)。
在Middlebury(H)的遮挡区域,LinStereo的EPE相比基线降低了 **37%**。这个结果直接验证了PALA的全局上下文传播能力:从匹配良好的可见区域获得的可靠视差估计被传播到了缺乏直接光度证据的遮挡像素,而局部窗口更新算子很难做到这一点。
Booster(Q)是最具挑战性的基准,包含透明和镜面表面,违反了光度一致性假设。即使在这个场景下,LinStereo也保持了稳定性,与最佳方法的Bad-2差距仅为0.02(9.93 vs 9.91),处于统计波动范围内。

6.2 水下泛化:零样本超越使用额外数据的方法
水下场景是LinStereo最核心的验证场景。仅用SceneFlow合成数据训练(无任何水下数据),LinStereo在TartanAir-UW上取得了最佳结果,AbsRel比FoundationStereo低 **28%**,RMSE比FoundationStereo低 **31%**。在SQUID真实水下数据集上,AbsRel比IGEV++低 **26%**。
值得注意的是,这些对比方法中许多使用了额外的训练数据(包括真实世界和领域特定数据),而LinStereo完全依赖SceneFlow的合成监督。论文将这一结果归因于PALA的全局传播能力:可靠估计从匹配良好的区域被传播到了最退化的区域。
定量数据:在TartanAir-UW上,LinStereo(T=8)的AbsRel为 0.036,SqRel为 0.194,RMSE为 2.079;在SQUID上,AbsRel为 0.045,RMSE为 0.896。这些数字在无额外数据的方法中全面领先,甚至优于使用额外数据的方法。

TartanAir-UW定性比较1/2 ——展示岩石海底地形、水下悬崖与植被、珊瑚礁与鱼类场景。基线方法在背向散射影响的远距离区域高估深度并丢失小前景物体,LinStereo保持准确的深度尺度过渡并解析单个物体深度(红框标注)。

TartanAir-UW定性比较2/2 ——展示严重散射和低能见度条件下的场景。基线方法产生深度塌陷、块状伪影或过度平滑的预测,抹去地形和植被结构。LinStereo仍然恢复连贯的深度梯度,并在极端退化条件下检测到小前景物体(红框标注)。

SQUID定性比较 ——展示浅沙海底、近场珊瑚和岩石构造、人造设备场景。在强颜色衰减下,基线方法表现出深度尺度不一致、细结构过度平滑、物体边界周围深度渗色。LinStereo保持稳定深度并恢复精细结构细节(红框标注)。
6.3 效率:T=2就能超越全迭代的效率型基线
论文专门对比了LinStereo在仅2次迭代(T=2)时的水下性能。在TartanAir-UW上,LinStereo(T=2)的AbsRel为 0.09,RMSE为 3.84,优于所有在完整迭代次数下运行的效率型基线。在SQUID上差距更加显著:所有效率型基线的AbsRel ≥ 0.71,而LinStereo(T=2)的AbsRel为 0.05,RMSE为 1.03。
这证明了PALA的全局聚合能力使得收敛所需的迭代次数大幅减少。论文总结为:不是在简化架构,而是在减少达到收敛所需的精炼迭代次数。
6.4 真实世界实验室水箱:近距高精度验证
论文还构建了一个受控实验室水箱数据集,使用AprilTag标定和CAD模型渲染生成亚毫米级精度的近距(<2m)深度真值。LinStereo在这个数据集上同样取得了最佳性能,AbsRel为 0.0423,RMSE为 0.0672,大幅优于RAFT-Stereo(AbsRel 0.0603)和IGEV++(AbsRel 0.0470)。
目标设计包含精密CAD模型预制结构件和直径约3mm的细绳,后者对立体匹配是极端测试。定性结果显示,基线方法在细绳上要么产生严重噪声和碎片化,要么完全丢失;LinStereo恢复了连续的绳索深度。
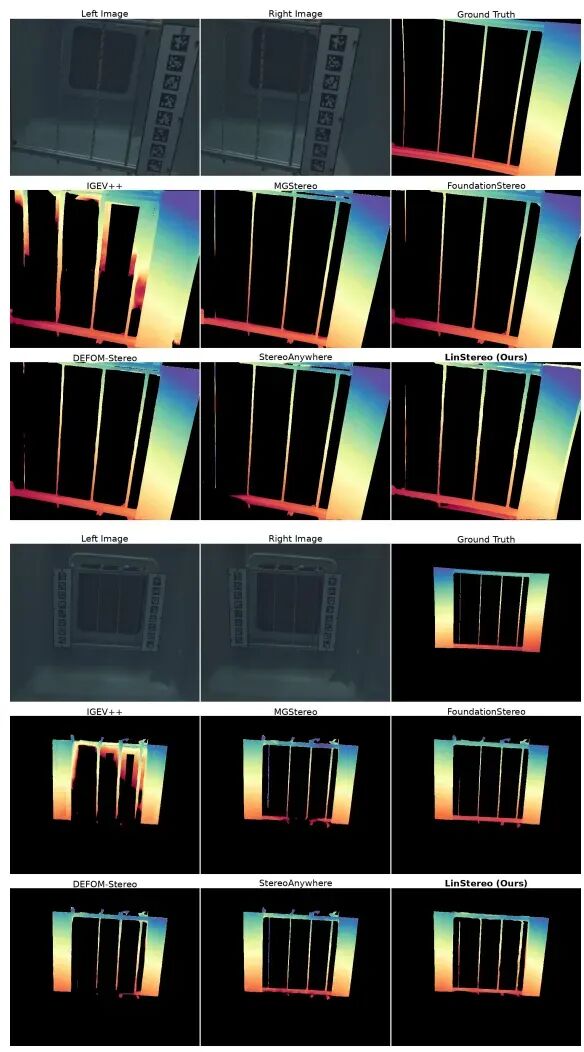
实验室水箱定性结果 ——展示细绳(~3mm直径)和金属框架结构的深度恢复。基线方法在细绳上产生严重噪声和碎片化或完全丢失绳索,LinStereo恢复连续绳索深度;对于金属框架结构,基线方法未能完全识别框架几何导致深度预测缺失或不完整,LinStereo恢复完整框架结构。
七、水下视觉感知的系统级延伸
LinStereo在深度估计精度上做到了水下场景的领先,而水下SLAM的系统级挑战则需要更完整的框架来回答。2026年的两项工作展示了LinStereo作为水下感知前端的上下游关系。
SurfSLAM提出了一个sim-to-real的水下立体视差估计训练框架,使用模拟数据训练+自监督微调来解决域迁移问题,并构建了包含24,000+立体图像对的沉船调查数据集。SurfSLAM将立体深度估计与IMU、气压计和DVL(多普勒速度计)融合,用于实时定位与建图。LinStereo提供高质量的水下深度估计前端,SurfSLAM将这些深度估计接入完整的水下SLAM系统。两者分别解决水下视觉感知的“精度”和“系统”两个层面。
FLSea数据集则提供了前视水下立体视觉数据集,包含4个立体数据集和12个视觉惯性数据集,带有通过Agisoft Metashape摄影测量软件生成的真值深度图和位姿。FLSea的独特之处在于前视相机配置——大多数水下数据集采用下视配置,而前视配置更接近水下机器人的实际作业场景。数据集覆盖了地中海和红海的多种水下能见度和光照条件,包括自然和人造结构以及动态相机运动。这与LinStereo的实验室水箱实验形成互补:LinStereo用近距高精度水箱验证亚毫米级精度,FLSea则提供了真实海洋环境中的多样化测试场景。
八、消融实验:每个设计选择都有据可依
8.1 PALA设计消融
在KITTI 2015和TartanAir-UW上逐步构建PALA模块:
| (D) C + 自适应门控(完整PALA) | 1.01 | 4.54 | 0.042 | 2.08 |
从(A)到(B)的全局空间编码(即非对称RoPE)带来了最大的单项提升,确认了恢复位置结构是对vanilla线性注意力最关键的增强。局部空间编码和自适应门控提供互补的细化。
8.2 组件消融
论文测试了HSCV、DPI、PALA三个组件的所有组合。每个组件单独都改善基线,PALA贡献最大单项增益。完整组合产生超加性提升——PALA的全局推理从HSCV提供的更丰富的per-scale correlation中获益,而DPI的热启动让收敛在更少迭代内完成。
在成对组合中,HSCV + PALA取得了第二好的性能(EPE 1.10),表明全局注意力从多尺度匹配信号中获益最多。将层次化设计替换为单一池化多尺度特征(HSCV pooled)导致精度下降,确认了尺度对齐的correlation比池化特征更好地利用了VFM表示。
8.3 HSCV超参数
相关性金字塔深度 从2增加到4带来单调增益但边际递减。更新尺度数 的影响更大:从3降到1,EPE上升12%,水下指标恶化更显著(AbsRel +20%,RMSE +13%)。
8.4 PALA块设计
每尺度堆叠多个PALA块()增加参数但不改善精度——外层迭代循环(T次pass)已经提供了足够的表示深度,每尺度单块最优。注意力头数呈现倒U型:4个头最佳(128/4 = 32维/头),太少限制空间模式多样性,太多降低每个头的维度到无用阈值以下。隐藏维度与HSCV投影宽度匹配()时最有效。
九、面向工程实践的部署考量
9.1 计算效率
LinStereo在480×640分辨率下达到 12.5 FPS(RTX 4500 GPU,24GB),参数量 127.07M(含冻结的DA3 backbone),GFLOPs为 770.48。与实时方法对比:
| LinStereo | 127.07 | 770.48 | 80.0 | 12.5 |
需要特别说明的是,LinStereo的参数量包含了冻结的DA3 backbone,而其他方法的参数量不包含预训练backbone。backbone本身占了大部分推理成本——论文在结论中明确指出,将backbone蒸馏到轻量级架构可以降低延迟同时保持跨域特征质量,这是未来工程部署的重要方向。
在实时立体匹配的工程生态中,CIRNet提出了紧凑迭代精炼网络用于实时立体匹配,PSKNet针对边缘设备设计了轻量级slice网络,EFSNet通过混合2D-3D代价体积聚合实现了轻量级实时匹配。这些工作共同构成了立体匹配“实时化”的工程图谱。LinStereo的T=2配置与这些方法的对比形成了一个完整的效率-精度权衡分析:LinStereo不是在参数量上取胜,而是在“达到同等精度所需的迭代次数”上取胜,这是效率优化的一个全新维度。
9.2 训练配置
LinStereo仅在SceneFlow上训练,使用AdamW优化器,初始学习率 ,StepLR调度器,训练100,000步,约一周(8×40GB GPU)。第二阶段冻结几何估计模块,训练运动估计模块,再训练100,000步,约五天。
损失函数为指数加权多迭代监督:
其中 给后期迭代更高权重, 是边缘感知平滑项, 是多尺度梯度一致性项。
十、SeaStereo-Dataset:为水下立体匹配补齐数据缺口
论文同时贡献了一个新的合成水下立体数据集——SeaStereo-Dataset。数据集包含 40,320 对立体图像,覆盖 Jerlov I到3C七种水质类型,从清澈开阔水域到高度浑浊的近岸水域均有覆盖。

水质条件由Jerlov类型I、IA、IB、II、IC、III和3C建模,通过不同的光吸收和散射特性区分。高浑浊水质被限制在浅水深度以保持图像可见性,而清澈水质则在浅水和深水范围中采样以引入光照条件的变化。

SeaStereo-Dataset示 ——展示三种不同水质和海底深度下的左相机渲染结果。从左到右展示从清澈开阔水域到中等浑浊再到高度浑浊的水下能见度变化。

SeaStereo-Dataset额外样本 ——每行展示三组立体RGB图像(左、右)及其对应的视差标注,覆盖不同Jerlov水质类型、海底深度和相机模型。
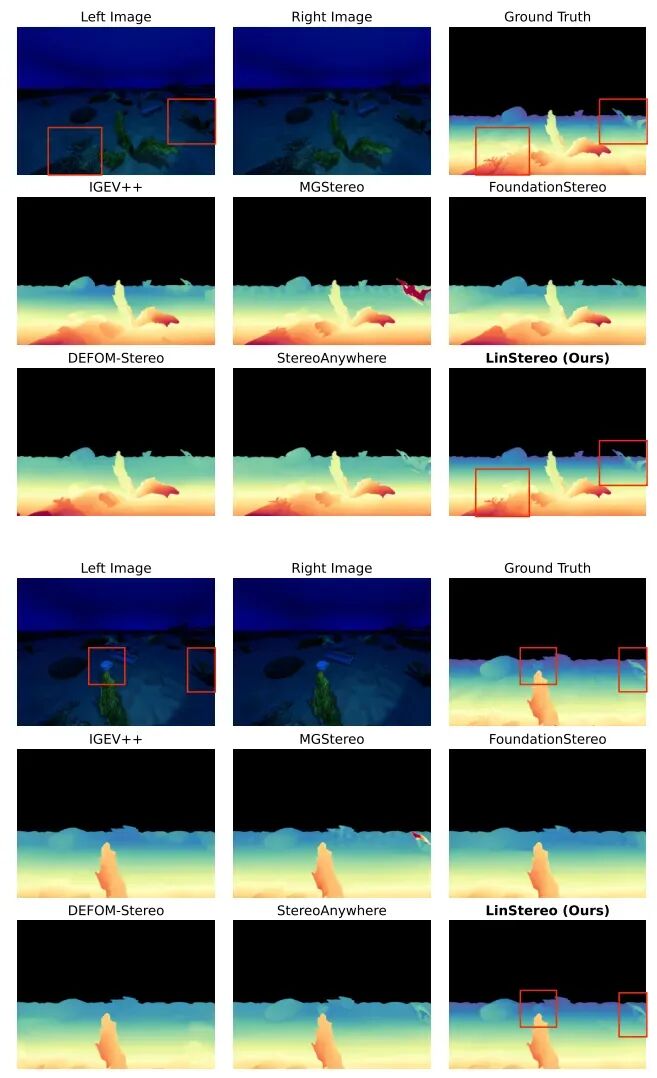
SeaStereo-Dataset定性比较1/2 ——基线方法随着浑浊度增加将小前景物体合并到海底或产生伪影。LinStereo清晰分离前景物体并在所有能见度条件下保持一致深度(红框标注)。

SeaStereo-Dataset定性比较2/2 ——继续展示不同浑浊度下前景-背景分离能力。基线方法在浑浊度增加时产生伪影、不稳定深度或过度平滑预测导致前景-背景分层丢失。LinStereo干净分离物体深度与背景并在所有水质类型下保持一致的深度结构(红框标注)。
十一、局限性与未来方向
论文诚实地列出了两个主要限制:
其一,backbone占主导推理成本。 LinStereo建立在冻结的DA3 backbone上,backbone占推理成本的大部分,在资源受限平台上以完整迭代次数部署可能受限。将backbone蒸馏到轻量级架构是未来的工程化方向。
其二,DPI依赖SIFT特征。 当前DPI模块使用手工SIFT特征进行尺度-偏移对齐。将这一组件替换为轻量级学习型稀疏匹配器可能提供更鲁棒的初始化,并改善跨域适应性。
本文仅做学术分享,如有侵权,请联系删文。
。


添加微信:cv3d001,备注:姓名+方向+单位,邀请入群。