在医疗临床数据分析、金融风控建模、工业生产指标预测等诸多领域,结构化表格数据都是核心的信息载体。
过往处理这类数据的主流方法,无论是梯度提升树类模型还是AutoML流水线,大多需要针对单个数据集单独完成训练、调参和模型选择流程,跨任务之间的知识难以复用,落地成本高、迭代周期长。
随着大语言模型和多模态大模型的快速发展,业界也开始探索面向结构化数据的通用基础模型,希望能通过预训练沉淀通用数据理解能力,无需额外微调即可适配下游各类表格任务。

论文标题:LimiX-2: A Contextual Mechanism Network Towards General Structured-Data Intelligence
论文链接:https://arxiv.org/pdf/2609.17488.pdf
开源仓库地址:https://github.com/limix-ldm/LimiX/
Hugging Face 主页:https://huggingface.co/stableai-org/
ModelScope 主页:https://modelscope.cn/organization/stable-ai/
研究背景
当前通用人工智能的探索主要围绕三个方向展开:面向文本、图像等模态的大语言模型与多模态模型,面向物理世界交互的具身智能体与世界模型,以及面向结构化数据的通用建模能力。前两个方向已经取得了显著进展,而结构化数据的通用学习与推理能力发展相对滞后。
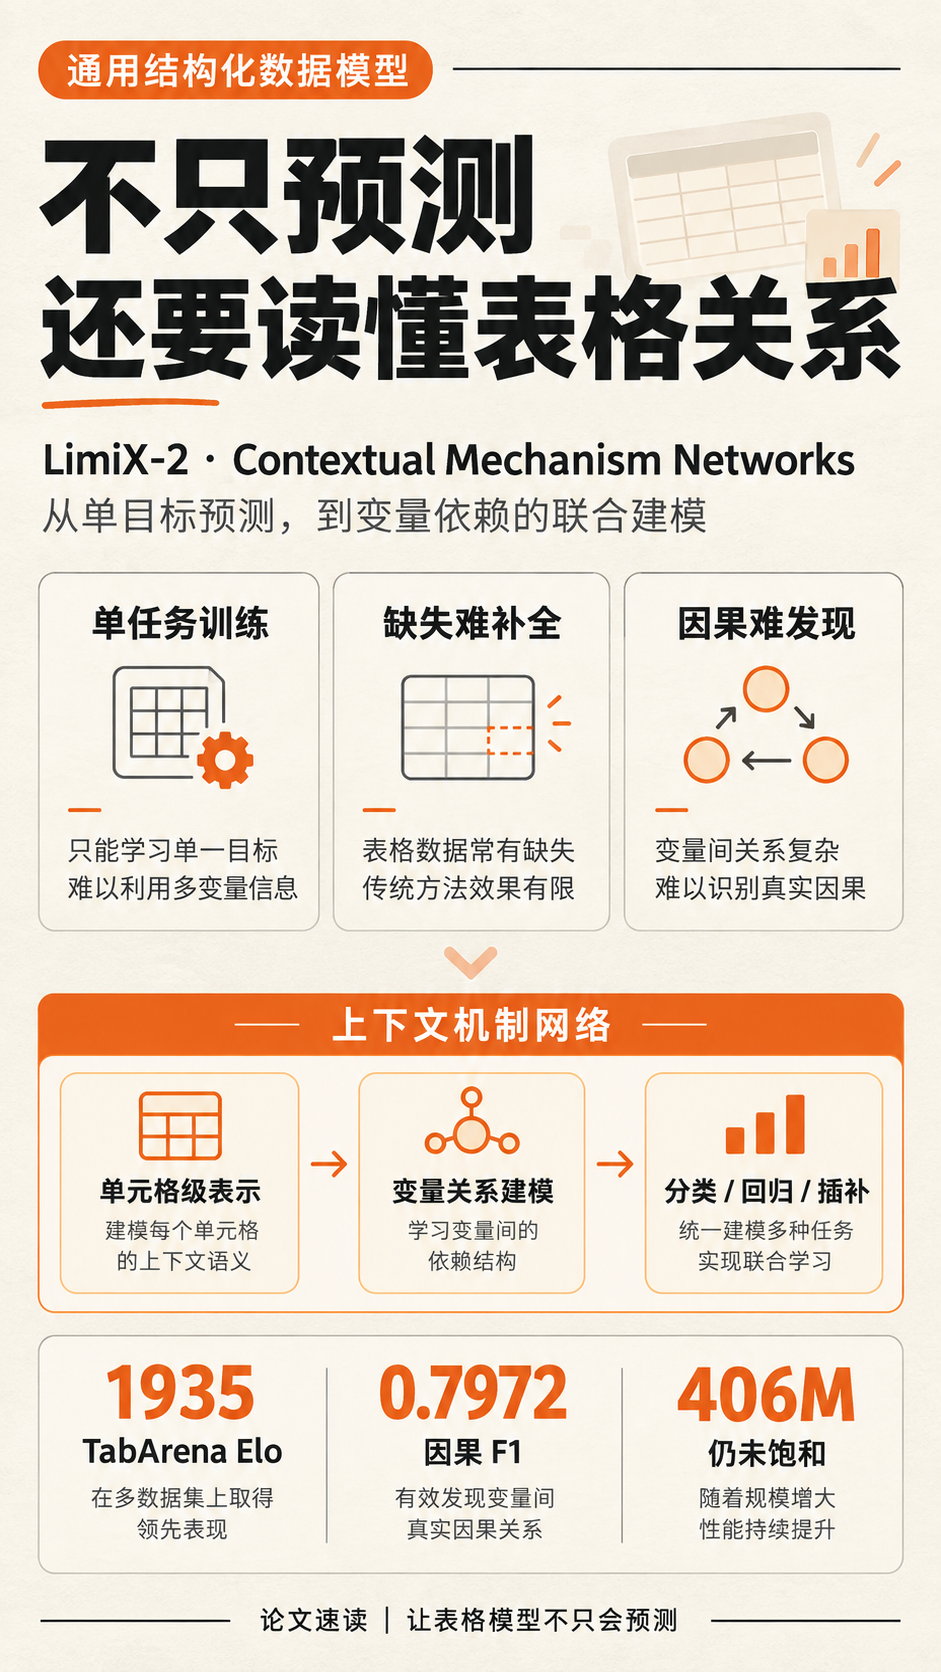
此前的表格基础模型大多基于Prior-Data Fitted Networks(PFN)范式,通过在合成任务上预训练实现上下文学习能力,但其训练目标仅聚焦于单目标预测p(y|x, D_context),没有显式建模所有变量之间的联合分布,这也限制了模型在多元数据推理任务上的表现。
为了突破这一局限,来自LimiX和清华大学的研究团队提出了上下文机制网络(Contextual Mechanism Networks, CMNs)新范式,并基于该范式开发了LimiX系列的最新模型LimiX-2。
核心架构设计
CMNs范式的核心变化是将建模目标从“以预测目标为中心”转向“以变量间依赖关系为中心”,不再只学习给定特征预测目标的条件分布,而是建模给定上下文时所有变量的联合分布p(x,y|D_context),监督预测也因此成为广义条件推理的一个特例,为多任务能力提供了统一基础。
LimiX-2延续了上代模型的单元格级表征设计,不会将整行特征压缩为单个向量,而是为每个单元格单独生成表征,更好地保留表格数据的细粒度结构,支持跨变量的条件推理。在此基础上,团队对模型各个模块进行了升级优化。
在数据嵌入阶段,LimiX-2将特征嵌入维度提升至256,缺失单元格统一使用共享的可学习嵌入表示,目标变量根据任务类型分别编码,分类目标通过正交初始化的嵌入表映射,回归目标通过专属MLP映射,同时还会额外加入任务类型嵌入。
为了区分边际分布相似的不同列,LimiX-2采用低秩判别特征编码为每列生成专属的身份标识,将其映射到嵌入空间后和特征表征相加,同时低秩设计也避免模型记忆列位置的捷径,迫使模型真正学习列本身的特征。
模型主干采用24层堆叠的双轴Transformer块,首先通过样本轴注意力在每个特征位置和目标位置跨样本传播信息,查询行仅能关注上下文行,保证预测不受同批次其他查询样本的影响;随后采用非对称特征轴注意力,特征表征可以关注目标和其他特征,而目标表征仅能关注特征,实现信息的单向流动;激活函数采用独立的SwiGLU,特征和目标表征分别走独立的计算路径,更好地区分二者的角色。
不同任务的预测头会接入不同深度的模型输出:掩码特征重构需要保留数据的局部细节,因此接入浅层输出;分类和回归任务依赖更高层的抽象语义,因此接入最后一层的输出。其中回归任务没有采用传统的MSE损失,而是将目标范围划分为5000个有序分桶,预测每个分桶的概率后加权得到最终回归值,提升了预测的稳定性。

预训练与数据生成
LimiX-2采用上下文条件掩码建模(CCMM)作为预训练目标,将目标预测和掩码特征重构结合,把监督信号扩展到所有变量和不同的条件集合,而非仅局限于目标列。每个预训练轮次会将表格划分为上下文集和查询集,对查询行的部分特征列进行掩码,让模型基于观测特征和上下文信息预测掩码内容,同时也完成目标变量的预测。为了覆盖更多样的条件预测场景,团队组合了三种掩码模式,分别针对单个单元格、查询行的指定列、连续单元格块进行掩码,覆盖从孤立值恢复到目标列预测、缺失组重构的不同任务场景。
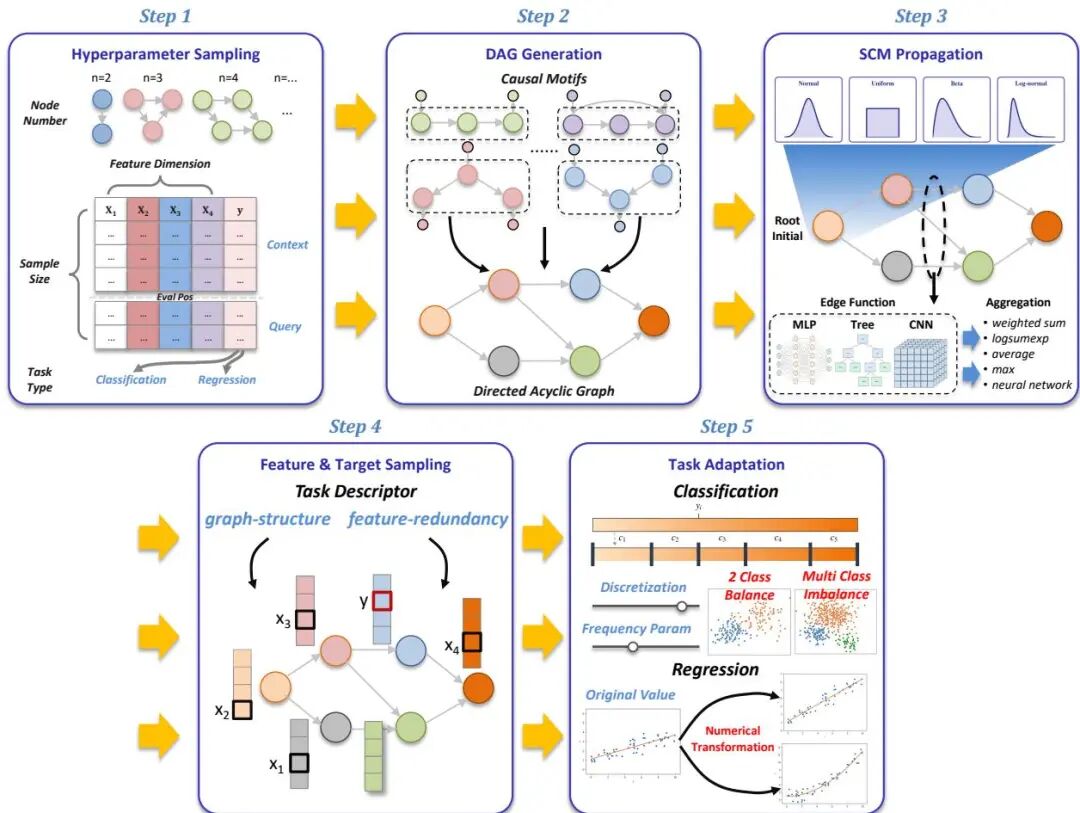
预训练使用的所有数据均为基于结构因果模型(SCM)生成的合成数据,生成流程包含五个阶段:首先采样数据集的全局超参数,包括样本量、特征维度、任务类型等,然后生成包含多种因果基序的有向无环图(DAG)刻画变量间的依赖关系,再通过不同的函数机制传播得到所有变量的取值,随后筛选部分变量作为特征和目标生成数据集,最后对特征和目标做随机变换适配不同任务。这套生成流程覆盖了更多样的图结构、函数机制和观测过程,大幅提升了预训练任务的多样性。
实验效果验证
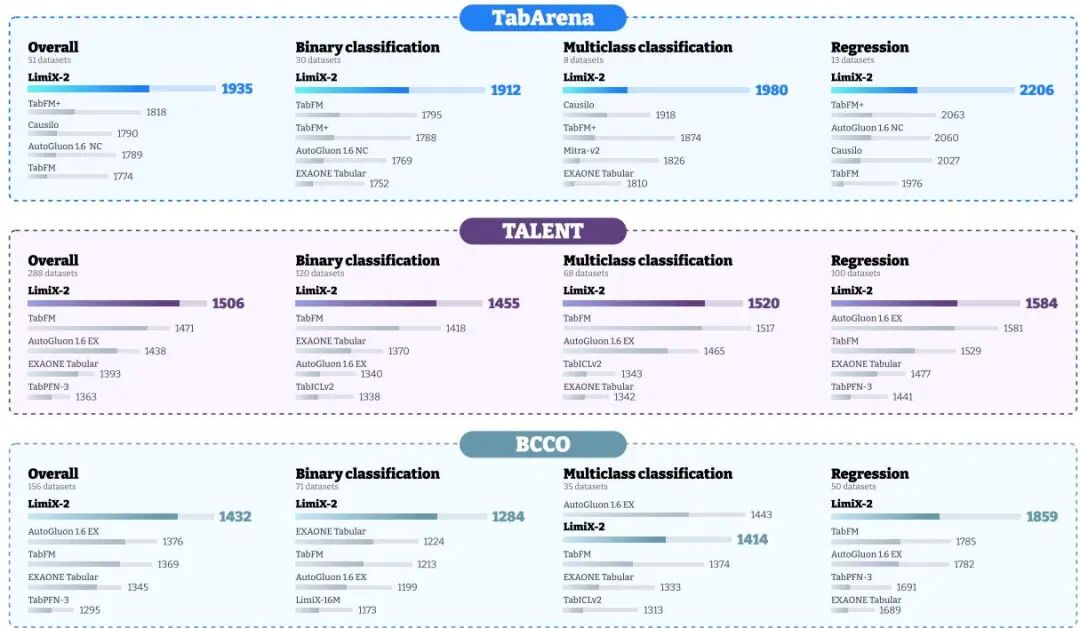
研究团队在三个业内广泛使用的表格学习基准上对LimiX-2进行了全面测试,三个基准分别侧重实际场景性能、跨任务泛化能力、不完美数据下的鲁棒性,覆盖了不同样本量、特征维度、缺失率的各类场景。

在侧重实际落地性能的TabArena基准上,LimiX-2取得1935的Elo得分,比第二名TabFM+高出117.4分,平均排名5.5,聚合获胜次数是TabFM+的3.6倍,和所有竞品的两两对比胜率均超过60%,其中对AutoGluon 1.6的胜率达78.3%,对其他表格基础模型的胜率普遍超过90%。
在包含288个数据集的TALENT基准上,LimiX-2总Elo得分达1506,比第二名TabFM高出35分,在二分类、多分类、回归三类任务上的平均排名均为最低,在不同样本量和特征维度的数据集上都保持稳定的性能优势,和所有对比方法的两两对比胜率均超过50%。
在侧重不完美数据鲁棒性的BCCO基准上,LimiX-2总Elo得分达1432,比第二名AutoGluon 1.6高出56分,其中回归任务的优势尤为明显,Elo达1859,平均排名3.1,大幅领先其他对比方法。
除了常规的预测任务外,研究团队还验证了LimiX-2的因果感知能力:其特征注意力编码了变量间的直接因果关系,只需通过阈值划分注意力得分即可还原因果骨架,在6个常用的因果发现数据集上,LimiX-2的平均F1得分达0.7972,在6个数据集上都排名第一,效果超过了多款专门设计的因果发现方法。
缩放规律分析
团队还针对LimiX-2做了细致的参数量缩放实验,测试了12.5M到406.2M范围内的多个模型版本,结果显示下游任务性能和参数量的对数呈清晰的线性关系,拟合优度R²在0.96以上。不同任务的缩放收益存在差异,TabArena上每翻倍参数量可提升34.68 Elo,BCCO回归任务每翻倍参数量可提升30.06 Elo。到目前测试的406.2M参数量时,性能仍未出现饱和迹象,说明未来将模型扩展到十亿参数级别时,还有很大的性能提升空间。

总结
LimiX-2提出的上下文机制网络范式,突破了此前表格基础模型仅聚焦单目标预测的局限,通过联合建模变量间的依赖关系,让单个预训练模型无需任何针对特定任务的微调 ,即可同时支持分类、回归、缺失值插补、因果发现等多种任务。在三个主流表格学习基准上的测试结果显示,LimiX-2的表现全面超过了现有表格基础模型和针对单数据集训练的传统模型,验证了新范式的有效性。同时清晰的缩放规律也表明,该技术路线还有充足的迭代空间,未来有望为结构化数据的通用智能处理提供成熟的解决方案。
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群