小米玄戒 O1 是 3nm 旗舰 SoC,比亚迪璇玑 A3 是中国首款量产的 4nm 车规智驾芯片,底座都是 Arm 的 IP 授权。
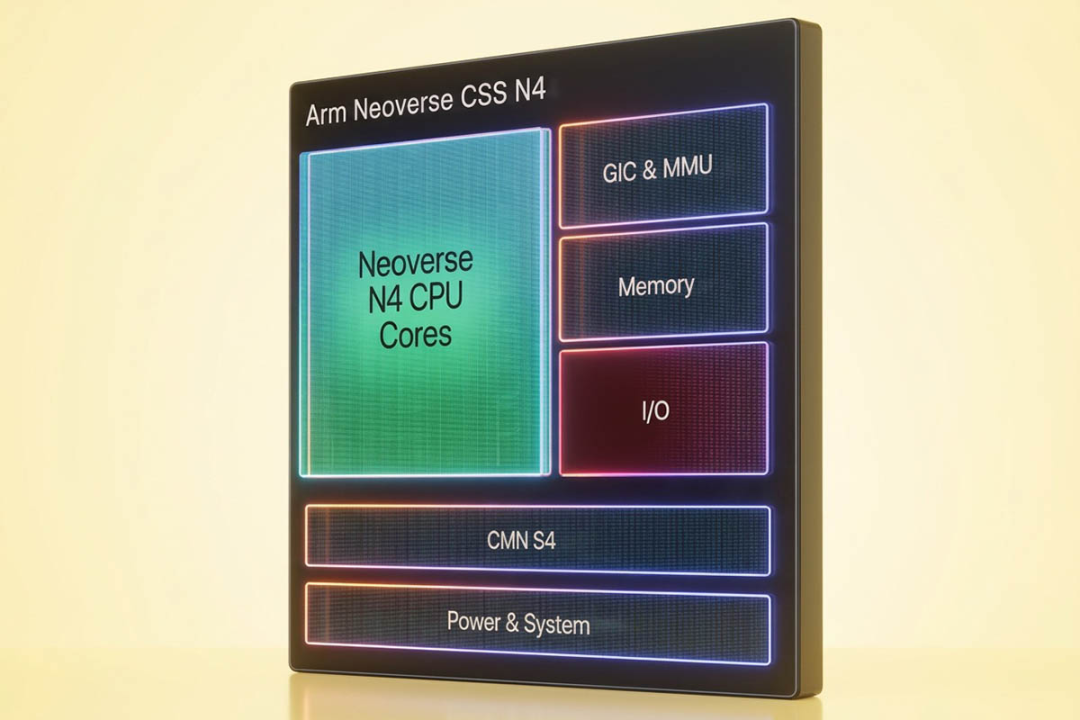
这个底座刚更新了一代:Arm 发布 Neoverse CSS N4,单裸片最多 128 核、3nm 级、最高 3.8GHz、128 条 PCIe Gen 7,N 系列正是对中国客户开放的那一档。
中国企业会做芯片的答案写在 Arm 的清单上,最值钱的那一段却被绕开了。
Part 1
◎ 小米玄戒 O1 是 2025 年 5 月发布的 3nm 旗舰 SoC,190 亿晶体管,最高主频 3.9GHz,研发历时四年多。
小米买的是 Arm 最新的 CPU、GPU 标准 IP 授权,多核与访存系统级设计、后端物理实现全部自研,CPU 部分重新设计了 480 多种标准单元库。
这是一次实打实的自研,起点落在 Arm 的 IP 上。
◎ 比亚迪半导体的车规 MCU 基于 Cortex-M4F 加 M0 双核设计,累计出货超过 20 亿颗。
座舱芯片 BYD 9000 是联发科天玑 9000 的定制版本,Armv9 核心、5G 基带、台积电 4nm。
2026 年 5 月发布的璇玑 A3 是中国首款规模化量产的 4nm 车规智驾芯片,16 核 CPU,三颗协同总算力超过 2100TOPS,通过 ASIL-D 认证。
比亚迪半导体的股东名单里,安谋科技(Arm 中国)在列。
芯片设计的门槛,被 IP 授权模式削掉了一大半。
指令集、CPU 核、GPU 核、互连都能买,剩下的活是系统级设计、后端实现、封装和软件栈。
这部分依然难,它把一件需要几百人干四年的活,变成了一批公司干得动的活。
2025 年 5 月出过一件事,Arm 官网当时发了一篇文章,标题用了小米 XRING O1 Custom Silicon 的说法,外界读成 Arm 给小米定制芯片,舆论迅速发酵。
小米连夜回应:玄戒 O1 由玄戒团队自主研发设计,研发过程里没有采用 Arm CSS 服务。Arm 随后改稿,确认芯片由小米自主研发,表述换成双方 15 年合作的里程碑。
拿 Arm 的现成子系统攒出一颗芯片,还算不算自研。
CSS 卖的就是这一层。客户省下的是最难做也最耗时的系统级设计,效率是真的,代价也长在同一处:省掉的那一段,正好是自研叙事里最值钱的一段。
中国市场的敏感度比别处高。
Arm 在中国的授权客户超过 400 家,这里的自研标签有实实在在的商业溢价,任何可能被读成买来的技术细节,都会放大成公关事件。
小米那次辟谣的强度,说明厂商比谁都清楚这笔账。中国厂商对 CSS 保持距离,原因也在这里:省下的工时,抵不上标签贬值的代价。
Arm 向中国客户开放的是 E 系列和 N 系列的授权,性能最高的 V 系列不在这份清单上。CSS N4 属于 N 系列,落在可授权的范围内。
中国的 Neoverse 客户已经有了一批。
◎ 阿里云倚天 710 基于 N 系列,是国内 Arm 云服务器芯片规模化商用的样本。
◎ 云豹智能、鸿钧微电子、遇贤微电子这批初创公司,在 DPU 和边缘算力上用的也是 Neoverse。
CSS N4 把 DPU 需要的核心数、I/O 和芯粒互连一次给齐,这些公司是直接受益方。
安谋科技贡献了 Arm 两成上下的营收和近一半版税,这个体量决定了中国市场不会被轻易放弃,也决定了授权清单会比别处更谨慎。
Part 2
CSS 全称 Compute Subsystem,计算子系统。CSS 本身不交付成品芯片,它把 CPU 核心、系统 IP、一致互联、内存控制器、I/O 这些已经验证过的构件打包成一套可配置方案,以 RTL 形式交到客户手上,客户直接导入自己的 EDA 流程。
核心数、缓存容量、内存类型、I/O 数量、加速器连接方式、芯粒接口,都能按需求配。
Arm 说这是迄今可配置性最高的一代 Neoverse CSS。
交付包里除了 RTL,还有实现指南、第三方 IP 互操作支持和一套集成软件栈,能直接在子系统上跑起 Linux 做验证。
这套商业模式的价值落在时间上。客户掏钱买的是省下来的两年工期和几百人年。

◎ Neoverse 这条产品线 2018 年发布,头五年只卖核心 IP,系统部分交给客户自己搭。
◎ 2023 年 Arm 第一次推出 CSS,把互联、内存控制器、I/O 这些系统 IP 一并打包,第一代 CSS N2 后来进了微软的 Cobalt 100。
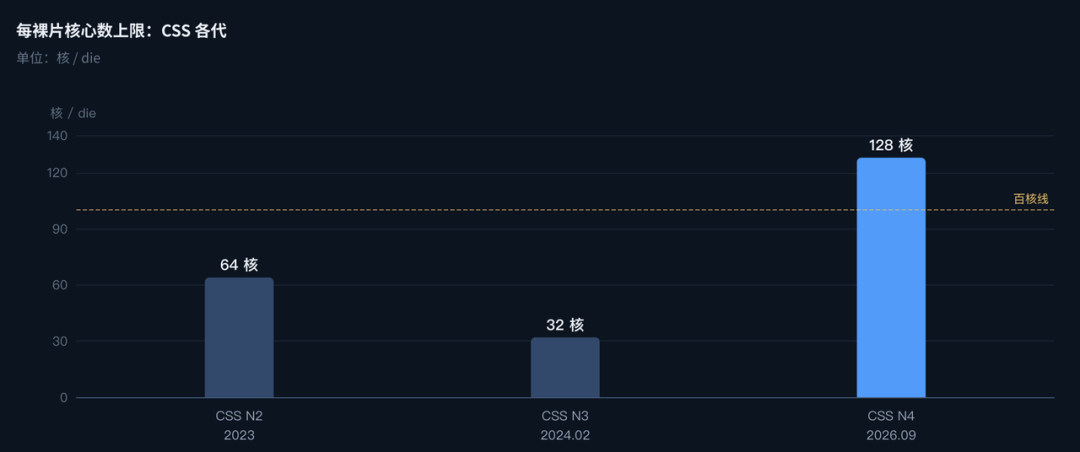
◎ 2024 年 2 月,CSS N3 和 CSS V3 同时发布。CSS N3 的起点并不高:32 核,40W TDP,5nm,Armv9.2,每瓦性能比 CSS N2 提升 20%,配 4 通道 DDR5 和 32 条 PCIe 5.0 或 CXL 通道。
CSS V3 是 V 系列第一次有 CSS,最多 128 核每封装,支持 HBM3、PCIe 5.0 和 CXL 3.0。
◎ 两年半之后,CSS N4 把单裸片核心数从 32 提到 128,工艺从 5nm 走到 3nm 级,I/O 从 PCIe 5.0 跳到 PCIe Gen 7,内存从 DDR5 扩展到 LPDDR6。
N 系列前两代在打磨每瓦性能,把功耗压到 40W 量级,服务网络和边缘设备。
到 N4 这一代,核数和带宽一起放开,目标换成了机架里的计算密度。
◎ 核心。单裸片 8 到 128 个 N4 核心,基于 Armv9.3 架构。原生支持 FP8 和 MMLA 指令,CPU 在核内就能跑低精度 AI 推理,不必把矩阵一趟趟搬去 GPU。主频最高 3.8GHz,这是 N 系列 CSS 第一次摸到这个频率。
◎ 内存。LPDDR6、DDR5、MRDIMM 三种都支持,速率 8000 到 12000MT/s。MRDIMM 的意义在服务器侧,它通过多路复用内存 rank 的数据信号,在不加宽主板内存总线的条件下把带宽翻上去,每一根针脚的吞吐都更值钱。
◎ I/O。最多 128 条 PCIe Gen 7 通道。Gen 7 单通道 128GT/s,是 Gen 6 的两倍,标准本身还在推进过程中。现在就把能力焊进设计,等于给两代之后的服务器生命周期提前留了 I/O 余量,用来挂 800G 网卡和一排排 AI 加速器。
◎ 互联。CMN S4 做底层总线,16×16 mesh 拓扑,横截面带宽是上一代 CMN S3 的两倍,通过 CHI C2C 支持完全一致的多芯粒连接。

相对上一代 CSS N3,Arm 给出的提升是单路性能最高 2 倍、每瓦性能最高 1.25 倍、内存带宽最高 1.75 倍。
对比条件是 N3 用 5nm、N4 用 N3P,都按最高核心数、3GHz 主频、2MB L2 配置。这几个数来自模拟环境,流片实测数据还没有,引用的时候要带上这个前提。
128 个核心先要解决的是内部交通。
核心 0 要读核心 127 的 L2,路径没算好,整条流水线一起等。Mesh 拓扑解决的是这个。
环形总线像单车道公路,数据只能沿着固定环路跑,负载一高就堵。16×16 mesh 更像一张规划整齐的城市路网,数据包能绕过拥堵节点,走最短路径到达任意一个核心、内存控制器或外设接口。
CHI C2C让两颗独立裸片之间的内存访问和缓存一致性,维持得像一颗单芯片。
这条能力要放在芯粒成为主流的背景下衡量:单芯片制造撞到光罩尺寸上限,把大芯片拆成小芯粒,已经是必答题。芯粒分开之后,它们之间的通信质量和成本决定整颗芯片能不能跑起来。
Arm 在 AMBA 体系里把这段协议统一,分量比多给几十个核心更重。

Neoverse 分三条线:E 系列做边缘,N 系列做均衡吞吐,V 系列做极致性能。
◎ V 系列常年上头条,AWS Graviton、Nvidia Grace 都在射程内。
◎ N 系列安静得多,客户名单上是 DPU、智能网卡、5G RAN、边缘服务器。
横向扩展和数据面这两类负载,要的是单位面积塞进更多核心、单位时间搬更多数据,对单核响应速度并不敏感。N 系列的定位就是每瓦性能和每面积性能,正好对上。
Arm 自己的分工描述很直白:V 系列追求每线程性能和最低延迟,N 系列追求吞吐效率和每瓦、每面积效率。
DPU 在智能体 AI 时代变重,逻辑也不复杂。
主机 CPU 的时间要留给业务本身,安全卸载、网络卸载、KV-cache 加速、把智能体工作负载和主机隔离,这些活交给一块独立的控制平面芯片。
Arm 在 CSS N4 的产品页里,把这几项用途一条条列了出来。N 系列几乎不做发布会主角,但数据中心里插在 GPU 旁边那些卡,跑的核心越来越多是 N 系列。

XSight Labs 的 E1 就是这套玩法的成品,64 核 800G DPU,基于上一代 CSS N2 设计。
一家初创公司,64 个 N2 核心加自研网络加速逻辑,做出 800G 级别的数据处理器。放在几年前,这个工程量需要一支数百人的芯片团队干上三四年。
Arm 把核心架构和总线这些基础部分做完,小团队把精力压在自己的差异化上:网络流水线、卸载引擎、软件栈。上市时间从数年压到一两年。
这个模式已经跑出了一串名字。Socionext 基于 CSS V3 做芯粒,走台积电 2nm。Faraday 基于 N 系列做 64 核服务器 SoC,走 Intel 18A。
ADTechnology 做 16 核 N 系列边缘服务器平台,走三星代工。
Arm 在 2024 年推芯粒架构时提到,有 15 家芯片厂商在评估这套方案。另一批客户是超大规模云厂商。
自研芯片从 AWS Graviton 开始变成常态,微软、谷歌、Meta 都在队列里。这些公司不缺钱,缺的是时间,CSS 正好卖时间。
Arm 这在给下一代服务器 CPU 立标杆。
128 核、3.8GHz、LPDDR6、PCIe Gen 7,每一项都在对标两代之后的整机。中国厂商的位置同样清楚。
IP 授权体系已经把设计能力推到能自己攒大芯片的水平,手机和汽车行业先走了一遍,数据中心这一档,倚天 710 之后还有一批 DPU 初创在排队。