作者|Cynthia
编辑|郑玄
9 月 22 日的 2026 杭州云栖大会,平头哥少见地被完整推到了主论坛台前。
当天上午,吴泳铭完成主旨演讲后,千问大模型、多模态模型负责人依次登场,随后就是平头哥副总裁高慧。她的演讲题目是「Agentic 时代卓越算力基石」。
平头哥带来的产品,则从一颗最新得真武 V900 芯片,一直延伸到 ICN Switch 互联芯片、磐脉智能网卡、镇岳 SSD 主控、倚天 CPU 路线图,以及下一步的算、存、网全栈协同的超节点服务器。

发布「产品全家桶」地背后,是 Agentic 时代的负载变化:算力需求已经从训练为主进一步走向推理增长,应用从单轮请求变成连续的多步任务,硬件的竞争也从一颗芯片的指标扩展到整个计算系统的协同。
01
真武V900,平头哥最新一代AI训推芯片
这次发布里,平头哥新一代训推一体 AI 芯片真武 V900 仍然是分量最重的产品。

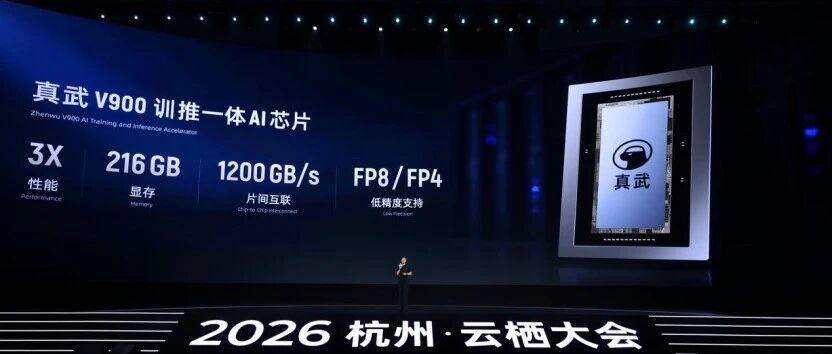
这颗芯片搭载 216GB 显存,片间互联带宽达到 1200GB/s,单芯片性能是上一代真武 M890 的 3 倍,是目前中国算力性能最强的 AI 芯片。精度上,该芯片原生支持 FP8 和 FP4,可覆盖高精度训练以及低精度、超低精度推理。
按照平头哥公布的计划,V900 将在 2027 年第一季度进入量产销售。此后,2028 年 Q3,真武 J900 也将正式推出。
而此时,离上一代真武发布,其实只过去了几个月。2026 年 5 月,平头哥 M890 首次亮相。这颗芯片拥有 144GB 显存和 800GB/s 片间互联带宽,性能达到上一代 810E 的 3 倍,并支持从 FP32 到 FP4 的多种数据精度。到了 V900,性能再次提升 3 倍,显存从 144GB 增加到 216GB,互联带宽也从 800GB/s 提高到 1200GB/s。
再向前看一代,2024 年的真武 810E 也已经从早期的单一推理芯片走向训推一体,采用自研并行计算架构和互联技术,并配套 SAIL 软件栈。
810E、M890、V900 连续三代产品里,平头哥一直在同时提高训练、推理、显存和低精度计算等核心能力。

而背后的关键词,则始终围绕AI 时代工作负载的变化。
举个简单的例子,模型进入万亿参数以后,MoE 几乎成为了默认的架构选择。
如果一个几万亿参数的模型每次推理都让全部参数参与计算,算力消耗和推理成本都会迅速上升。因此,MoE 会把模型拆成大量专家,每个 Token 只调用其中一部分,在继续扩大模型容量的同时,把一次实际参与计算的参数量压下来。
这种架构缓解了计算量,却同时把硬件压力推向了三个方向。
首先是算力。
MoE 减少了每次参与计算的参数量,但每个子专家的参数量仍在几十万级别,Token 也依然要在很短时间内完成大量矩阵运算;进入训练阶段以后,还有反向传播、梯度更新等更重的计算。大模型参数扩张后,AI 芯片的计算性能必须同步增加。这也是平头哥过去几代真武芯片一直在提升的能力
算力之外,模型进入万亿参数规模后,显存也会成为新的重点。
单颗 M890 有 144GB 显存,真武 V900 则进一步提升至 216GB。如此一来,只需 10 多张真武 V900,即可部署一个万亿规模的大模型。
据悉,基于真武 M890 的超节点已大规模应用,并跑通了 Qwen3.8、Kimi K3 等超 2 万亿参数规模模型,让数万亿参数模型的专家并行尽量在一个超节点内部完成。
但只有算力与显存还不够,面对数万亿参数规模的模型,任何一颗单芯片的显存容量都显然不够。因此,模型在部署实际时,必须拆到很多颗芯片上,然后芯片之间就会不断交换数据。
于是,推理由此变成计算与数据交换不断交替的过程:一颗芯片算完自己的子专家部分,数据马上就要交给另一颗芯片上的子专家;专家完成计算,结果还要再次汇总。模型被拆到几十、上百张卡以后,芯片之间交换数据的速度,会直接影响整个模型能跑多快。
所以对于 Qwen3.8、Kimi K3 这样的万亿参数规模模型,几十上百张 AI 芯片只解决了模型「装得下」的问题。它们之间的通信速度,才真正决定了这些专家能不能高效地一起工作。
这也是平头哥这几年持续发力互联能力的原因。
今年 5 月,平头哥互联芯片 ICN Switch 首次亮相,成为了阿里超节点形态算力的核心芯片之一。
据介绍,真武 V900 通过自研 ICN Switch 互联芯片连接后的超节点,具备原生内存语义和内存统一编址能力,可实现千卡全带宽高速互联。这意味着上千颗真武 V900 能像一颗「超级芯片」一样协同工作,为超大参数模型的训练和推理提供高吞吐、低延迟、高并发的算力。
伴随算力与显存、互联的增强,真武系列的客户半径也同步不断增长。
其中,在具身智能领域,众擎机器人基于真武搭建了千卡具身智能训练平台,覆盖模型训练、数据处理等环节,端到端训练效率提升 34%,已有 30 多个模型可以免适配直接跑通。对需要持续处理 3D 动作迁移、数据标注和大规模训练的人形机器人研发来说,真武已经开始进入核心训练流程。

汽车场景里,小鹏则把真武用于自动驾驶、智能座舱和企业大模型等多类 AI 业务。根据现场披露的数据,真武整机性能相比其对比的业界主流 GPU 提升 70%,集群故障数量减少 50%;同时通过替换过去多种不同卡型,实现了把部分分散的算力资源纳入统一资源池的集中管理。

截至目前,真武系列已经服务超过 650 家企业客户,覆盖智驾、金融、大模型、具身智能、能源、制造等行业。
02
从一颗芯片到算存网全栈协同
在 V900 和新一代 ICN Switch 之外,平头哥这次还把磐脉智能网卡、镇岳 SSD 主控以及倚天 CPU 放进了同一张产品图里。
其中,真武承担 AI 计算,ICN Switch 负责 AI 芯片之间的高速互联,磐脉进入服务器与数据中心网络,镇岳负责 SSD 控制,倚天则处理通用计算。
这其中,服务器 CPU 倚天是个关键点。
在传统 AI 训练里,主要计算集中在加速器,CPU 更多承担数据准备、请求处理和调度。
但在 Agent 的情况截然相反。高慧现场举了一个行业研究的例子。一个 Agent 如果要完成一份报告,需要搜索资料、读取文档、运行代码验证、保存中间状态,再把多路结果汇总。模型推理只是整个任务链的一部分,其他环节都会持续占用 CPU。
今年 Computex 上,Intel 也曾给过一组公开测算:在前沿模型训练里,一颗 CPU 大约可以搭配 8 颗 GPU;到了 Agentic AI 负载,CPU 密度已经向 1:1 甚至更高变化。
也是因此,在云栖大会现场公布的倚天路线图中我们可以发现,它的发展趋势,正从 AI 芯片一侧的自研能力,不断继续向整机中的一环深入:具体来说,平头哥将在 2027 年推出倚天 720 和 730,其中倚天 720,190 核,12 通道 GDI,96LanePCIe,面向吞吐并发型场景;倚天 730 则将成为第一代自研高性能核,支持两路同步,多线程,128LanePCIe,单核性能跑分最高可以达到上一代的 1.4 倍,面向延迟敏感型的场景,为 AI Head Node 提供确定性的单核性能。未来还将继续推出基于第二代自研核心的倚天 750,,这颗芯片原可以和真武 AI 芯片通过同一套高速互联体系交换数据,降低 CPU 与 AI 芯片之间的数据交换开销。
云栖大会现场,平头哥的智能网卡和存储主控也悉数亮相。
其中,磐脉智能网卡负责把服务器接入数据中心网络,镇岳 SSD 主控处理本地存储。对于大模型训练和推理来说,模型、训练数据、Checkpoint 和中间结果都需要在存储、服务器和集群之间持续流动,计算单元之外的吞吐也会影响整体利用率。
硬件组合完成后,还要解决软件的配套问题。
模型里的注意力、MoE、矩阵乘等计算,最后都要变成芯片能够执行的算子。而同一个算子,数据怎么排布、使用什么精度、怎样调用片上内存、怎么编译,执行效率可能差很多。
以 Kimi K3 适配真武 M890 的过程为例。
基于 64 张 M890,Kimi K3 发布后,阿里云、平头哥和 Kimi 团队并没有停在模型已经适配真武这一步,而是继续调整软件栈和核心算子。最终实现首 Token 时延下降约 35%,单卡解码吞吐提升 1.8 倍。
今年 7 月,平头哥开放的 SAIL 软件栈在其中起到了关键性作用。在软件层面,它能够覆盖操作系统、SDK 和接口层,同时提供驱动、性能分析和调试工具,从而保证一颗新芯片做出来以后,原来运行在其他硬件上的模型和框架,可以尽快迁过去。
当前,SAIL 已经支撑了 python、TensorFlow、vLLM、SGLang 等 260 多个主流训练和推理框架。在 Github 上,15218 个超过 1 亿 star 的主流 AI 仓库中,SAIL 软件栈已经覆盖了超过 96%,vLLM、SGLang 这些主流的推理框架从上游开源新版本到 SAIL 完成全量的适配,平均时间不超过 1 周。
再往上,是云平台。等模型的用卡需求从几十张卡走向更大的集群,软件面对的问题还会再变一层。
阿里拥有模型、芯片、推理平台和云的完整链条,可以针对模型实现从芯片到云平台层面的全链路优化,显著提升推理效率、大幅降低推理成本。例如,通过算子优化和软硬件架构协同,阿里云灵骏真武超节点实例在 Agentic 推理场景中最多可实现 1.5 倍的推理性能提升。
到了这一步,一颗 AI 芯片才真正变成云上的算力。
03
面向10倍算力中心,
阿里芯片、模型和云协同优势进一步放大
吴泳铭当天的演讲里,把机器智能时代的基础设施归结为三个部分:AI 模型、AI 芯片和 AI 云。
随后他给出的几组数字:
一边是模型。千问计划继续训练 5 万亿到 10 万亿参数规模的新模型。
另一边是云。吴泳铭表示,当前客户 AI 需求依然非常强劲,中长期需求远超供给能力;阿里将继续投入 AI 基础设施建设,到 2032 年,阿里云运营的全球数据中心规模目标超过 20GW。这延续了阿里过去一年持续加码算力的方向。
而当算力建设走到这个规模以后,自研芯片对阿里的意义也会发生变化。
它不再只是一项证明技术能力的芯片业务。几十万张加速卡进入同一个云计算体系,需要长期面对供给、成本、功耗、服务器设计、网络扩展、模型适配和软件效率。对芯片、服务器、超节点、网络、模型和推理系统进行联合调优,提高的是整个 AI 集群的 Token 产能和效率。
但反过来从另一个角度出发来看,整个阿里体系的资源与认知,也在反哺平头哥的能力迭代。
如果回顾过去几年的行业发展,不难发现,在 AI 时代,芯片行业迎来爆发的同时,也面临着一个天然的难题:硬件与软件之间的发展代差。
一颗复杂 AI 芯片,从架构定义、RTL 设计、验证到流片,往往是以年为单位推进的工程。EDA 巨头 Synopsys 披露过一个 AI 加速器案例,18 个月完成流片已经被当作极快的开发速度;同类项目传统上可能需要 3 到 4 年。流片之后,还要经过硅后验证、封装、良率爬坡和量产准备。
但过去三年,AI 模型从参数量到模型架构已经换了几轮技术路线。
2023 年,Qwen 公开的最大模型还是 72B 规模的 Dense Transformer,硬件面对的是一套相对直接的矩阵计算;2024 年 3 月,Qwen 推出首个 MoE 模型 Qwen1.5-MoE,压力分散到显存、专家路由和跨卡通信;到 2025 年的 Qwen3,Dense 和 MoE 已经同时存在于一代模型里;2026 年的 Qwen3.8-Max 则把 Sparse MoE 继续推到 2.4 万亿总参数,每次只激活 950 亿参数,长上下文和推理模型又改变了单次请求持续的时间和内存占用方式。
应用侧变化也在改变我们对硬件的需求结构。最初的大模型应用以 Chat 为中心:用户输入一句话,模型返回一段文本,绝大部分重计算都留在模型内部,GPU 和内存是唯二的主角。随后,模型开始调用搜索、代码解释器、数据库和各种 API,Agent 成为新的主流,模型开始把一部分工作交给外部工具,CPU、网络的重要性被摆上台面。
也就是说,一颗今天立项的芯片真正大规模投入使用时,它服务的模型与应用很可能已经不是立项时最主流的那一类,一旦等 MoE 已经成为主流,再决定要不要加强互联;等 Agent 已经大量进入生产环境,再重新考虑 CPU 和 AI 芯片之间的关系,时间往往已经不够了。
硬件必须能提前几年判断模型的走向,这也是阿里体系做芯片时一个很特殊的优势:
平头哥左手是持续变化的千问模型与 Agent 家族,右手是相对稳定的电商、支付、地图、办公和开发者场景,向下是真实运行这些模型的阿里云。内外部视野结合,有时候变化的苗头刚出现,机会就已经比公开市场需求更早进入芯片和系统团队的视野。
而这种多看见的一点未来,本身就是硬件能力的一部分。
*头图来源:2026 杭州云栖大会
本文为极客公园原创文章,转载请联系极客君微信 geekparkGO