讯飞发布新一代语音大模型
科大讯飞正式发布最新一代语音识别大模型 Spark-ASR-2.0。该模型通过非自回归与 LLM 增强自回归协同、中英文混合文本与声学联合增强、动态上下文注入等技术创新,在通用识别(中英文混合、方言、专业术语)、复杂声学场景(高噪、小音量、快语速、儿童)及文本流畅规范性上明显改善。

整体推理成本较 Spark-ASR-1.0 仅增 10%,词错误率明显降低,在方言、高噪、小音量维度优于业界最优水平。模型明日逐步上线讯飞输入法并开放 API,后续还将落地 AI 眼镜、智能办公本、讯飞听见等产品。
来源:IT之家

阿里千问发布音频大模型
千问正式发布 Qwen-Audio-3.1 系列语音大模型,一次性推出 ASR、TTS、Realtime 三大核心模型升级,并新增音频理解模型 Qwen-Audio-3.1-ASR-Next 与音频创作模型 Qwen-Audio-3.1-TTS-Next,覆盖"理解—生成—交互—创作"完整音频能力栈。
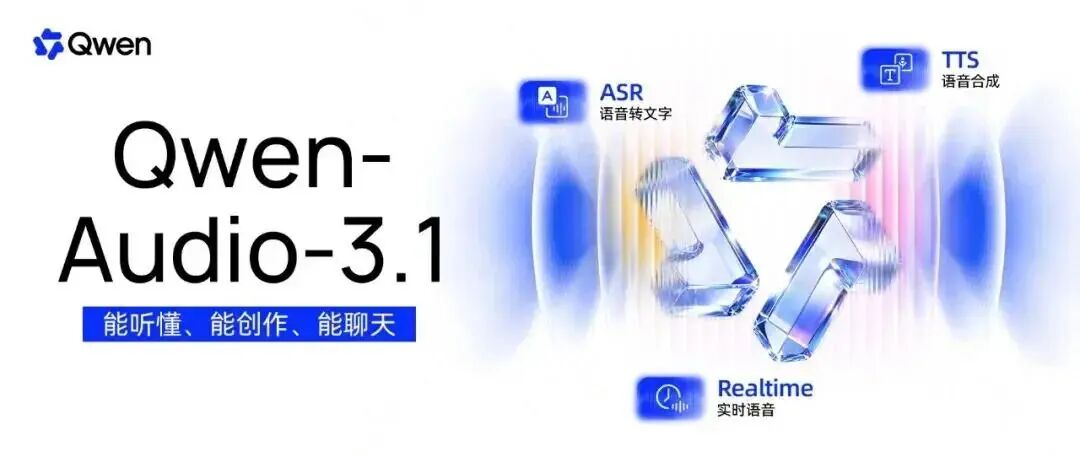
ASR 支持 30 种语言与 16 种中文方言,首字响应约 160 毫秒;TTS-Next 可统一生成人声、音效与环境音。为降低使用成本,全线语音模型价格下调,其中 TTS 降约 70%、Realtime 降约 85%、ASR 降幅达 95%。
来源:DoNews
马斯克惊叹中国AI大模型
特斯拉 CEO 马斯克在央视财经专访中表示,中国 AI 大模型整体非常出色,单位算力产出的性能几乎达全球顶尖水平。他认为中国解决算力问题的速度将快于多数人预期,粗略估计约两到三年内,可依靠光刻技术与芯片制造补齐算力缺口。

谈及教育,他建议广泛学习人文艺术与科学与工程;并预测未来 12 至 18 个月内 AI 在工程及数字领域实现能力跨越式提升,AI 编程最快明年达到"Stockfish 级"水准,人类开发者将丧失软件开发竞争优势。
来源:界面新闻

Deepseek 公开智能体论文
DeepSeek 最新论文(梁文锋署名)公开 Agent 训练基础设施 DSec(DeepSeek Elastic Compute)。该系统专为 Agent 训练批量制造沙盒,每秒生成 5000+ 个、单日达 300 万个、峰值并发 38 万个,由约 160 节点、3 万核 CPU、250TB 内存支撑。

DSec 为函数调用、容器、轻量虚拟机、完整虚拟机四类任务提供统一后端,并通过镜像分层、按需加载、内存优化等手段控制开销。论文还披露 Agent 在训练中出现的多种 reward hacking 手段,以及 AppArmor、eBPF 等平台防御思路。
来源:手机凤凰网

李飞飞呼吁独立评估AI
斯坦福教授、World Labs 联合创始人李飞飞呼吁由独立机构与公共部门对 AI 进行更多监督,认为能力日益强大的 AI 系统的安全评估不应完全交由开发公司负责。

她指出,企业内部研究可评估单个模型的能力与安全,但无法替代政府、行业与学界共同制定的更广泛标准。李飞飞强调人类必须掌握对技术的控制权,相关讨论已超出前沿模型本身,延伸至其"世界模型"等现实应用该如何被评估与治理。
来源:财联社