Jev 火了一周多,这个号称能像直觉一样快速做判断的模型,从“让 AI 工作流提速数百倍”的演示,到各种分类、审核、路由案例,几乎被吹成了下一代智能应用的标准零件。但这几天也出现了不少“打假”的讨论:有人追问基准测试拿什么当正确答案[1],有人发现判断阈值一变,成绩就跟着变[2],还有人发现号称 Jev 能自动通关的我的世界暗影龙,用随机模型也能通关?[3]

我尝试把 Jev 放进一个真实的工作流中,测试它到底能不能替掉正在使用的 GPT-6?结轮很明确 **Jev 在结构清楚的判断上,能以很低的实测费用,做到接近 Luna 的整体一致性。
一、“系统一”模型
心理学里常用“系统一”和“系统二”形容两类思考:前者快,凭熟悉的线索作出直觉判断;后者慢,会展开推理、核对条件、权衡例外。它们是理解人的思维方式的比喻,搬到模型上也只是一个方便的类比。对于一个高频工作流来说,很多问题确实像系统一任务:这是不是一条招聘信息?邮件该分到哪个队列?这个页面和原条目是不是同一个项目?每条都让大型推理模型完整思考一次,成本和等待时间会迅速累积。
TypeSafe 把 Jev 定位为面向这类“可编程判断”的 System One 模型。它的接口直接要求有类型的输出,多选一的 Choice、刻度分数的 Score,以及返回某个命题为真的倾向值的 Noul。
它的实用本质可以理解成一个通用分类器:工程上仍要给出输入、问题、候选项和合成规则,模型负责补上规则代码难以穷举的常识判断。
这类模型能不能真正进入生产工作流,我会看三个要素。第一是智力:是否真的通用,能不能适应不同的场景和问题?第二是速度:是否真的低延迟?能达到类似人类直觉的无察觉判断?第三是价格。
这种系统一和系统二的模式,OpenAI 和 Anthropic 也一直采用,例如 GPT-5.6 系列开始提供的 Luna 就是系统一模型,主打轻量任务的高速反应。刚刚推出的 GPT-6 Luna 与 GPT-6 Sol 也是类似的分工:前者代表更轻、更便宜的选择,后者作为本次评测的对照基准。但这里的“系统一”仍是工作流层面的比喻;Luna 仍然保留推理过程,也可以调整推理强度、生成文字内容,并不能把它当成完全没有思考的分类器。
二、评测
1. 背景
这次测试 PhD Radar 是我帮客户设计,用来追踪海外博士申请机会的工作流。它可以自动从网络抓取博士机会页面,做去重和排队,评估机会的真实性、机会方向、是否有奖学金评估与申请人匹配度,然后为每个机会进行等级评定,最后生成可交互的 HTML 报告。
工作流的抓取、游标、去重、队列、CSV 校验和报表生成都由脚本完成;它们不需要 Jev,也不需要 GPT。真正需要语义判断的是三个环节:一条信息是不是有效的博士机会;它与申请人的研究主题和背景有多匹配、申请起来是否可行,应放到哪个 Tier;官网页面能不能支持原条目的说法。

第一个环节判断“有效机会”会排除普通科研助理、博士后、只有课程介绍而没有博士机会的页面。第二要判断是否“相关”:分别评估主题匹配、背景匹配和可行性,分数从 0 到 4,再给出 1、2A、2B、3 或 irrelevant 的优先级。第三个判断环节是读官方页面,判断是否同一个项目、项目是否仍开放、资助类别和申请资格能否得到支持。
测试先运行了一次增量采集,完成 94 条信息的抓取、增量游标、去重、队列、CSV 校验和基础报告。随后冻结 94 条参与模型对照的候选记录,三种模型在这批相同记录上做判断。评价方式是以 GPT-6 Sol Medium 的输出作为基准,计算另外两个模型 — GPT-6 Luna 和 Jev — 与它的“一致率”或分数偏差。
测试实际要判断的语义项目有六组:
有效博士机会:是博士岗位、带资助的博士项目,还是应排除的其他信息。 主题匹配:研究内容和我关注的问题有多相关,给 0—4 分。 背景匹配:我的经历与项目要求有多贴合,给 0—4 分。 申请可行性:资格、资金、时间和申请路径综合来看有多可行,给 0—4 分。 Tier 优先级:综合判断是 1、2A、2B、3,还是irrelevant。官方页面核验:它内部又细分为页面状态、页面身份、资金和申请资格四个判断。

这 6 项判断共同构成有效性、Tier、和核验状态三个维度的测试结果。
2. 第一轮测试:有效性 100%,Tier 严重失准
先看最简单的判断“是不是博士机会”。Luna 和 Jev 都有 94/94 条与 Sol 一致。在这个样本上,它们识别了 Sol 判定的 85 条有效机会和 9 条排除项。这个结果说明,对边界相对清晰、候选答案有限的问题,Jev 至少没有制造明显分歧。

进入匹配度,差别就出来了。以 Sol 的 0—4 分为参照,Luna 在主题、背景、可行性三个维度的平均绝对差分别为 0.38、0.43、0.48 分;Jev 分别为 0.58、0.73、0.52 分。Jev 的主题分与可行性分有差距,背景匹配的偏差更明显。博士申请里的“背景”常常要把个人经历、方法技能、学科转换空间和项目要求一起考虑,需要更强的知识性和推理能力。
真正让第一轮结论变得复杂的是 Tier。Luna 有 66/94 条与 Sol 一致,约 **70.2%**;Jev 只有 31/94 条,约 **33.0%**。Sol 给了 48 条 Tier 3,Jev 首轮却把其中 **46 条判成 irrelevant**;它一共给出 **77 个 irrelevant**,而 Sol 只给出 21 个。换句话说,Jev 不是偶尔错一档,而是系统性地把“值得放进低优先级候选池”的机会扔掉了。
更值得警惕的是信心分数(Confidence)。首轮 Jev 有 42 条 Tier 判断的置信度达到 0.9 或更高,其中只有 20 条与 Sol 一致。高置信度并没有自动消除错误的任务理解。它似乎把“资金不明、条件不全、匹配不够强”等多个弱信号叠加成了“无关”;而 Sol 和 Luna 在这个判断里对 irrelevant 的要求更严格,真正越出研究边界才应该排除,其他有效机会可以先留在 Tier 3。

官方页面核验则呈现出更细的混合结果。页面或项目状态与 Sol 一致的记录,Luna 为 78/94,Jev 为 72/94;只看 73 条可用官网快照,两者分别为 57/73 和 51/73。判断“是不是同一个页面或项目”,Luna 是 59/94,Jev 58/94,几乎一样。判断资助类型,Jev 85/94,反而高于 Luna 的 79/94;判断申请资格,Jev 62/94,低于 Luna 的 73/94。问题边界不同,模型表现就不同,资助字段可能比资格条件更适合做明确分类。
如果只把有效性、Tier、状态、页面身份、资助、资格这六项类别判断等权相加,首轮 **Luna 为 449/564,即 79.6%;Jev 为 402/564,即 71.3%**。这个总体数能帮助看方向,却会掩盖 Tier 的巨大缺口。对真正要挑博士项目的人来说,漏掉一条值得申请的机会,和把资金字段标得不同,代价未必一样,所以没有办法因为“六项平均”差不多就说明 Jev 和 GPT-6 Luna 表现差不多。
3. 拆成原子问题:Jev 的关键使用技巧
TypeSafe 的组合评分指南[4]建议把宽泛判断拆成更小的可验证问题,再由代码组合。于是我没有继续让 Jev 一口气回答“这是什么 Tier”,而是让它分别判断五个事实命题:研究主题是否至少处在关注范围边缘;是否明确提供全额资助;是否是有明确申请入口的具体岗位或项目;是否是导师或课题组牵头的博士路径;是否是正式、结构化且有资金支持的项目通道。 这些问题使用 TypeSafe 的 Noul,每个返回一个 0 到 1 的判断倾向值。原有的有效性和三个匹配分数仍沿用首轮 Jev 的结果,这样第二轮主要检验“拆解 Tier”带来的变化。
关键是每个问题只问一件事。比如“研究边界”只看课题本身,不因为官网暂时打不开、资助未知或申请时间紧就判为无关;“资金”则只承认文本明确写出的全额学费加生活费,或带薪博士雇佣,不能从“可能有奖学金”推断。下方保留了这次使用的五个问题和判断边界,英文指令为节省版,完整原句与细节在测试脚本里:
QUESTIONS = {
    "within_research_boundary": {
        "type": "noul",
        "instructions": (
            "Does the substantive research topic have at least a peripheral "
            "but genuine connection to the applicant's research priorities? "
            "Judge the topic only. Do not reject for missing funding, weak "
            "prerequisites, a deadline, or unavailable official evidence."
        ),
        "criteria": {
            "true": "There is a specific research connection, even if weak.",
            "false": "The topic is clearly outside those priorities."
        },
    },
    "full_funding": {
        "type": "noul",
        "instructions": (
            "Does the supplied text explicitly establish full tuition plus "
            "a living stipend, or a salaried doctoral position? "
            "Missing or ambiguous funding is no."
        ),
        "criteria": {
            "true": "Full scholarship or salaried doctoral employment.",
            "false": "Partial, self-funded, unknown, or merely possible funding."
        },
    },
    "defined_position": {
        "type": "noul",
        "instructions": (
            "Is this a specific advertised doctoral position, studentship "
            "or defined project with an application route? Judge structure only."
        ),
        "criteria": {
            "true": "A defined doctoral vacancy or project is advertised.",
            "false": "Only a generic PhD programme or self-arranged route."
        },
    },
    "supervisor_led_path": {
        "type": "noul",
        "instructions": (
            "Is a named supervisor or research group leading this doctoral "
            "recruitment path? Do not infer funding."
        ),
        "criteria": {
            "true": "An explicit supervisor-led doctoral route exists.",
            "false": "No such recruitment path is established."
        },
    },
    "formal_funded_pathway": {
        "type": "noul",
        "instructions": (
            "Is this a named, structured and fully funded doctoral "
            "pathway, rather than an ordinary vacancy or generic degree?"
        ),
        "criteria": {
            "true": "A formal funded cohort or scholarship pathway.",
            "false": "No such exceptional pathway is established."
        },
    },
}
为什么不直接把这五个答案再写成一句自然语言交给模型?因为 Tier 是工作流的业务策略,应当由代码明确表达。下面是本次合成逻辑的简化版;条件的先后顺序也有意义,先匹配更高优先级,余下有效机会回到 Tier 3:
OUTSIDE_THRESHOLD = 0.10
YES_THRESHOLD = 0.50

def compose(validity, fit, answers):
    if validity != "valid":
        return"irrelevant"
    if answers["within_research_boundary"]["noul"] <= OUTSIDE_THRESHOLD:
        return"irrelevant"

    def yes(key):
        return answers[key]["noul"] >= YES_THRESHOLD

    funded = yes("full_funding")
    defined = yes("defined_position")
    supervisor = yes("supervisor_led_path")
    formal = yes("formal_funded_pathway")
    topic = float(fit["topic_fit"])
    background = float(fit["background_fit"])
    feasible = float(fit["feasibility"])

    if funded and topic >= 3and feasible >= 2and (defined or formal):
        return"1"
    if funded and supervisor and topic >= 2.5and feasible >= 1.5:
        return"2A"
    if funded and defined and background >= 2.5and feasible >= 2:
        return"2B"
    return"3"
这里有一个必须公开的细节。第一次把原子答案拼回 Tier 时,我用的是 0.5 的研究边界阈值,结果只有 36/94 条与 Sol 一致。 看完这批结果后,我重新审视业务含义:“明确越界”应该是很强的否定证据,不能因为 within_research_boundary 略低于 0.5 就把机会删除。因此把越界阈值改成 0.10,也就是 Jev 对“仍在边界内”的倾向值低到 0.10 或以下,才排除。其余四个肯定命题继续用 0.50。这一改动没有重新调用 Jev,是对已保存的原子答案重新运行确定性代码。
新合成结果是 65/94 条与 Sol Tier 一致,约 **69.1%**;与 Luna 首轮的 66/94,70.2% 非常接近。比 Jev 直接判 Tier 的 31/94 增加了 34 条净一致:有 75 条最终 Tier 与 Jev 首轮不同,其中 48 条分歧被纠正,也新增了 14 条分歧。对 Sol 的 48 条 Tier 3,新方案找回 46 条。
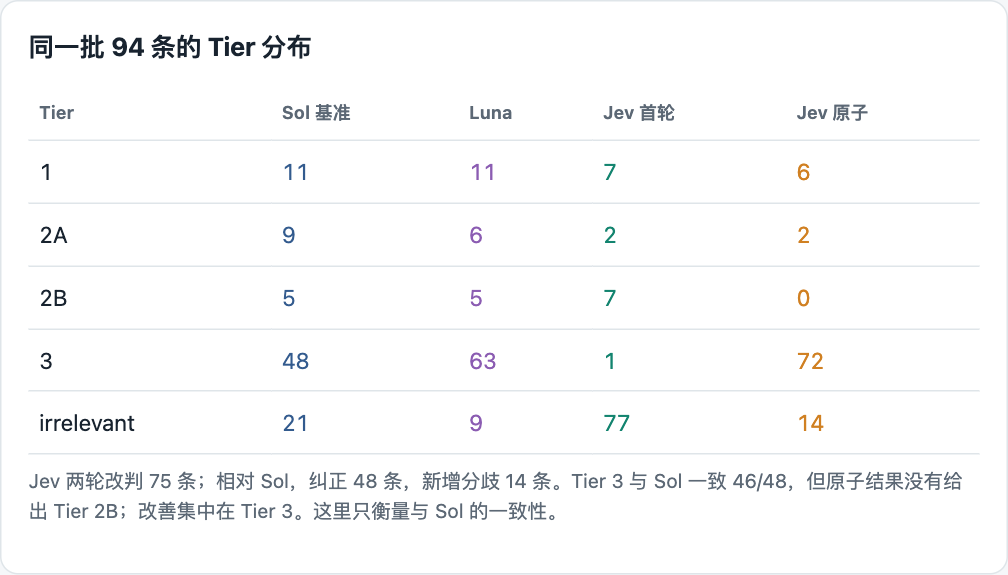
需要注意的是,这个 0.10 是看过同一批 94 条结果后选的,是样本内调参,属于先射箭再画靶,不是独立盲测;需要拿之后的新记录做一次不改阈值的检验。
更现实的问题是高优先级机会:新方案给出 Tier 16 条、2A2 条、2B0 条、372 条、irrelevant14 条;Sol 对应是 Tier 1 11 条、2A 9 条、2B 5 条、3 48 条、irrelevant 21 条。新方案明显更会“留住低优先级线索”,却还不够会把最值得投入申请精力的机会挑上来。尤其是 2B 一条都没选出,这是不能被总体一致率掩盖的缺点。

拿图里的挪威科技大学案例看,Sol 和 Luna 都把这条研究气候风险情景的博士机会放在 Tier 3,Jev 首轮却直接判成 irrelevant;原子化后,研究边界值为 0.62,代码把它留回 Tier 3。这正是新规则修复的那类漏筛。
4. 速度和费用
Jev 首轮三阶段共计 675,823 个输入 token、34,382 个输出 token;追加五个原子判断又用了 261,378 个输入 token、9,494 个输出 token。合起来是 937,201 个输入 token、43,876 个输出 token。在那种官方的定价,Jev 1.13 每百万输入 token 0.042 美元,输出免费,本次全套 Jev 调用约 0.0394 美元:首轮约 0.0284 美元,追加原子判断约 0.0110 美元。
GPT-6 Sol 和 Luna 是通过 Codex 代理通道运行,这个通道没有返回逐条 token 使用量,也没有可比的纯推理耗时。为了让费用有量级感,可以假设每个 GPT 模型完成同样的全流程时使用 50 万输入、5 万输出 token。按 Sol 官方标准 API 单价每百万输入 2 美元、输出 10 美元,情景费用是 1.50 美元;按 Luna 官方单价输入 0.10 美元、输出 0.50 美元,情景费用是 0.075 美元。
Jev 的 0.0394 美元大约是 Sol 情景价的 1/38、Luna 情景价的 1/1.9。

官方介绍里,TypeSafe 展示过很短问题的 70—500 毫秒响应及相对于大模型的高倍数优势;它也说明那些倍数来自自己的评测条件。我们这次传入的是较长的机会描述与官网文本,不是宣传演示中的短句场景,Jev 不同阶段的单次请求中位耗时约 1.47—1.65 秒,包括 API 往返和任务输入。
本轮可直接记录的是批次完成时间:Jev 首轮匹配加官方核验耗时 51.5 秒,原子 Tier 再花 27.0 秒,合计 78.5 秒;Sol 对应的第二、三环节代理批次约 190 秒,Luna 约 667 秒。Luna 那次还包含一次命令语法错误和重试,Jev 用了 6 路并发,三条路线的调用架构也不同。
5. 测试小结
为了直观比较,我把三项指标放进同一张雷达图。“智力”轴实际使用本任务六项类别判断相对 Sol 的等权一致率:Sol 的 100% 是基准定义,Luna **79.6%**,原子化后的 Jev **77.3%**,两者只差约 2.3 个百分点。速度轴用上述第二、三环节的批次耗时倒数;价格轴用 Jev 已测 token 费用与 GPT 的同一假设 token 情景价折算。

二、Jev 现在可以替换到什么程度?
对这个博士雷达,我的结论是:Jev 已经适合替换一些窄而清楚的 Luna 判断;还不适合不经复核就接管整个筛选流程。 有效博士机会的识别,本轮与 Sol 全部一致;官方资助字段,Jev 甚至比 Luna 更接近 Sol;把 Tier 的事实问题拆开后,六项类别判断总体也接近 Luna,而且 Jev 的计量费用只有几美分。这些都是值得试点的理由。
反过来,首轮 Tier 的大规模错排、二轮高 Tier 识别不足、官网资格判断偏弱,都是需要留住人工复核和旧流程兜底的理由。
我还会警惕一个常见的“漂亮数字”陷阱。TypeSafe 自己的基准测试很有参考价值,但和任何厂商基准一样,参考答案、阈值、任务长度与调用架构都会影响结论。外部机构 Arize 的 Jev 实测[5]也展示了阈值选择对成绩的影响,并强调要在人类标注数据上校准,再用未参与调参的数据检验。
Jev 值得关注的地方,是它把许多原本夹在脚本和大模型之间、需要一点常识的判断变成了可调用、可计量、可组合的零件。如果你这个假期想试 Jev,我建议从已有工作流里挑一个高频、答案边界清楚、错一次可以检查的环节,先冻结一小批真实输入。把“这个项目值不值得做”之类的大问题拆成几条能核对的原子命题,明确每条问题的肯定和否定标准,让代码负责最终策略。保存原始答案、置信度、token 和时间;再拿一批没参与改阈值的新数据复测,最好由人核对其中最容易造成损失的错例。
这样得出的结论,也许不如一句“便宜数百倍、速度数百倍”刺激,却能告诉你自己的工作流究竟能在哪里省钱、省时间,以及会错过什么。
有人追问基准测试拿什么当正确答案: https://counterproof.io/notes/typesafe-jev-benchmark-consensus-labels/
[2]有人发现判断阈值一变,成绩就跟着变: https://arize.com/blog/jev-as-a-judge/
[3]还有人发现号称 Jev 能自动通关的我的世界暗影龙,用随机模型也能通关?: https://www.bilibili.com/video/BV1ZLht69E7b
[4]组合评分指南: https://docs.typesafe.ai/patterns/composite-scoring
[5]Arize 的 Jev 实测: https://arize.com/blog/jev-as-a-judge/
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群