点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
作者供稿直发 | 来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
城门要在指定位置,角色要按设计路线前进,镜头还得照着轨迹走。要做到这些,是否必须先把整座城的模型、材质和灯光全部做完?
腾讯团队提出的 Proxy2World 给出了另一种做法:先用简化的 3D 场景代理(scene proxy)指定必须可控的结构和运动,再让生成模型补全真实的形体、外观与氛围。
论文:Proxy2World: Learning to Generate Worlds from Lightweight Proxies without Seeing Them
研究机构:Tencent
项目主页:https://dumdumgura.github.io/proxy2world/
作者:Hongli Xu、Weilong Yan、Anbang Wang、Chunyu Zou、Siyu Hong、Jingwei Huang
arxiv链接:https://arxiv.org/pdf/2609.35023v1
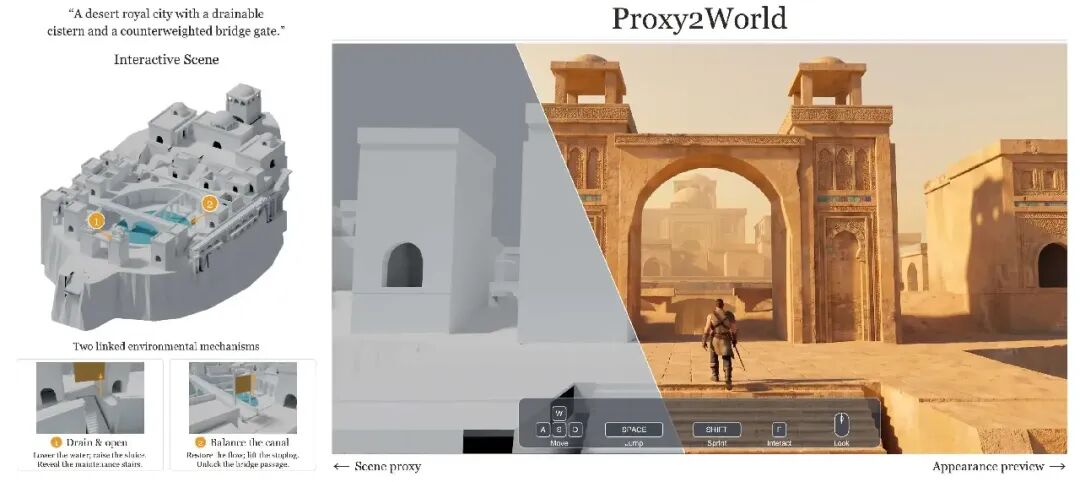 图 1|灰色代理规定城门、通道与交互结构;生成结果补上建筑细节、材质和光照。图片裁自论文主视觉。
难题:既要“听指挥”,也要有想象力
只给文字或相机轨迹,视频模型可以生成丰富画面,却未必能保证人物站在指定位置、桥按脚本升起,或建筑始终保持预定布局。把完整 3D 场景当作硬约束,又可能让低模人物的圆柱形身体、粗糙边缘直接出现在成片里。
Proxy2World 的出发点是:用户只需构建必须受控的部分,不必预先制作最终世界的全部细节。 代理可以由低多边形网格或简单几何体组成,也可以故意留白;它表达的是空间与行为意图,而非最终画面的逐像素答案。
这里有一道数据难关:真实视频通常没有与之成对的“设计师版低模代理”。为每段视频重新拆解场景、搭建代理,成本很高。Proxy2World 因而没有依赖成对的代理—真实视频训练样本,而是从 120,624 段带相机位姿的 RGBD 视频片段学习。
核心方法:先定结构,再长细节
同一模型在训练时学习两种互补能力:
深度条件下生成 RGB:把几何当作固定条件,学会遵循空间结构。 联合生成 RGB 与深度:让外观和几何一起变化,学会补全与细化场景。
推理时,两种能力接力工作。以论文采用的 40 步采样设置为例,前 3 步用代理深度锚定布局、物体范围与运动;后 37 步不再把代理深度锁死,而是联合细化 RGB 和深度。相机引导始终保留,深度与相机平移也被校准到一致的度量尺度,避免几何和镜头运动“各说各话”。输入还可包含文字描述和可选的首帧参考图。
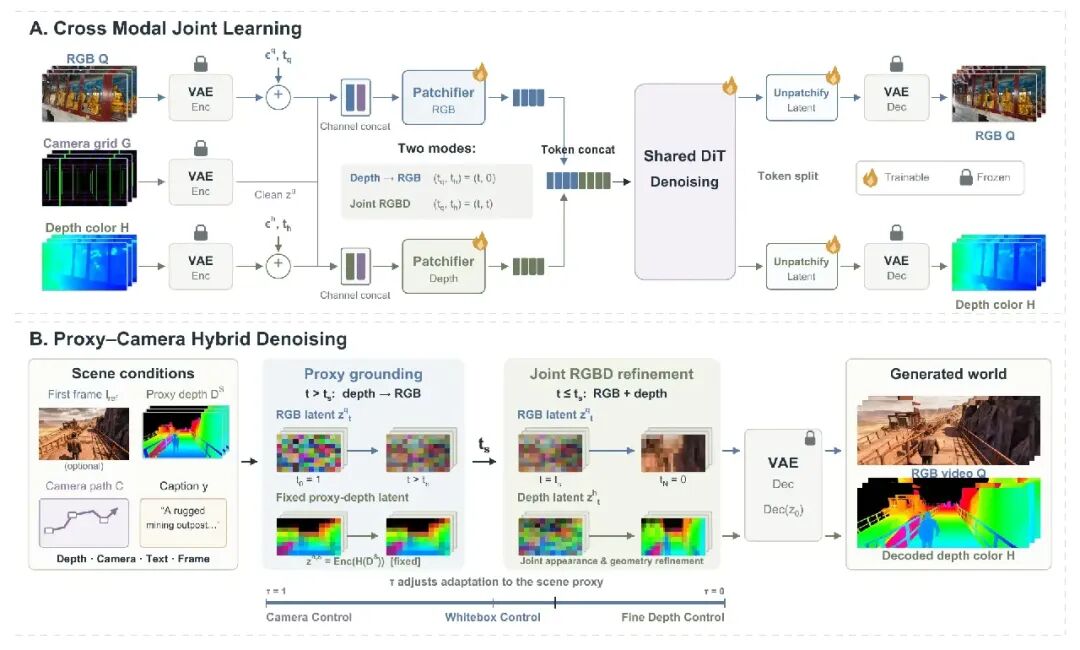 图 2|上半部分是同一模型学习两种生成模式;下半部分展示推理时由“代理定结构”过渡到“RGBD 联合细化”。图源:论文方法图。
“没有见过代理”并不是推理时不使用代理。 它指训练阶段无需成对的代理—RGB 视频;真正生成时,模型仍接收代理渲染的深度,遵循用户给出的结构。
怎么评测一个“听话又好看”的世界?
团队同时提出 ProxyBench:包含 25 个场景、300 段五秒序列;论文的统一定量比较选取其中 78 段,覆盖不同场景、相机轨迹、主体运动和代理抽象程度。评测既看相机轨迹、几何与时间对齐,也用视觉语言模型比较“是否遵循代理”以及“是否合理地丰富细节”,并辅以人工偏好实验。
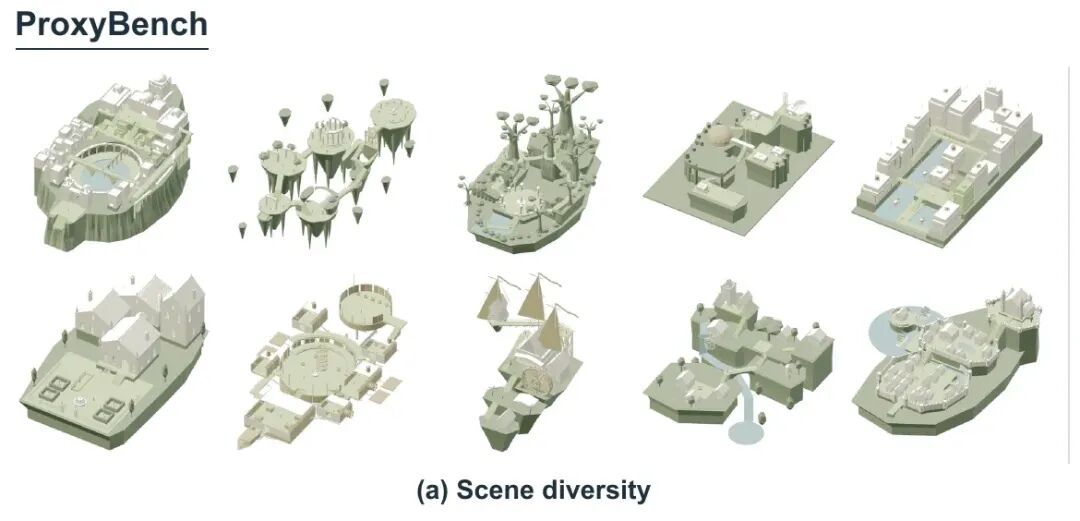 图 3|ProxyBench 的部分场景代理。不同主题与几何复杂度用于检验模型对抽象结构的适应能力。图源:论文基准图。
在同一权重、同样提供文字、首帧和相机轨迹的对照中,加入代理混合控制后,几何对齐分数从 0.5340 提升到 0.6795(相对提升 27.2%);VLM 评估的代理遵循胜率从 53.55% 提升到 64.18% ,细节精修胜率从 71.44% 提升到 77.96% 。这些胜率来自与其他配置的两两比较,平局按半胜计算,并非单条视频的成功概率。
在同为“文字+相机+代理”、不使用首帧的配置中,相比 Coarse2Real,Proxy2World 的归一化位移和旋转误差分别降低 47.3% 和 77.2% ,几何对齐提升 28.3% 。在论文的小规模人工偏好实验中,混合控制版本排名第一;该实验由 10 位参与者评估 10 段序列。
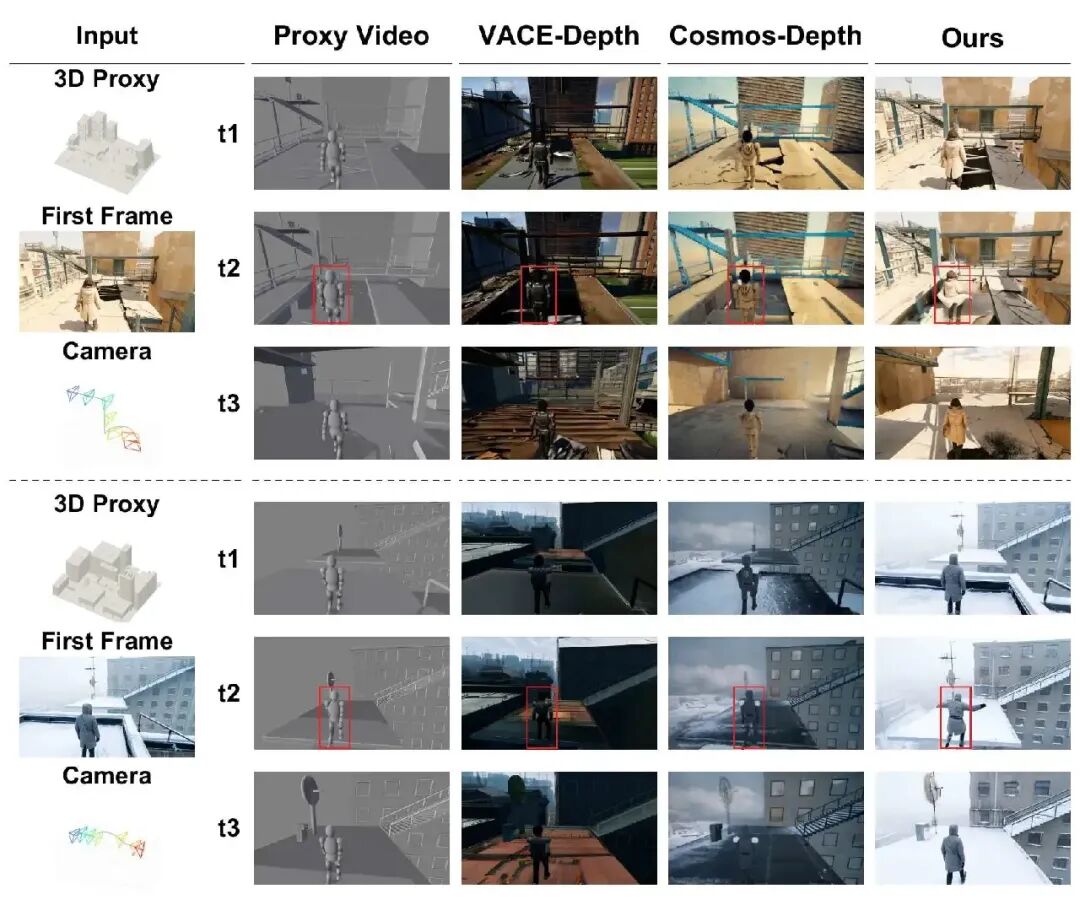 图 4|为便于手机阅读,从论文原始对比图中保留 Input、Proxy Video、VACE-Depth、Cosmos-Depth 和 Ours 五列;其他方法请见原论文。红框标示代理指定的主体位置。
结果也不是“所有指标都第一”。例如,Cosmos-Depth 的 VLM 代理遵循胜率高于混合版本;Proxy2World 的重点是在保留可控结构的同时,让粗糙几何有机会变成更自然的形体和外观。下面的消融图直观呈现了这种取舍:只依赖代理容易保留僵硬形状,只依赖相机可能偏离预设位置,混合推理则试图兼顾两者。
 图 5|同一模型在不同控制强度下的生成结果。中列为代理—相机混合推理。图源:论文消融图。
同一副“骨架”,不止一种世界
轻量代理保留的是可编辑的世界结构,而不是锁死的最终外观。在论文展示的同一场景中,风格、角色与光照都可以变化:城门仍在那里,但世界可以呈现不同气质。
 图 6|同一世界结构的不同视觉呈现。图片裁自论文主视觉。
Proxy2World 展示了一条有意思的路径:让创作者明确指定“什么必须保持”,让模型负责“其余可以如何生长”。 它目前聚焦短视频生成;更长时序的持续交互,仍是论文指出的后续方向。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。



