点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
人类运动员展现出多样且高度动态的网球技能,能够成功进行高速网球的对打。然而,在人形机器人上复现此类行为十分困难,部分原因在于缺乏完美的人形动作数据或网球场景中的人类运动学运动数据作为参考。在本工作中,我们提出了 LATENT,一个从不完美人体运动数据中学习竞技人形机器人网球技能的系统。不完美人体运动数据仅包含捕捉网球运动中所用基本技能的片段,而非来自真实网球比赛的精确完整人体网球运动序列,从而显著降低了数据收集难度。我们的核心见解是,尽管不完美,这些准真实数据仍然提供了网球场景中人类基本技能的先验。通过进一步校正与组合,我们学习到一种人形机器人策略,能够在广泛条件下持续击打来球并将球返回目标位置,同时保持自然的运动风格。我们还提出了一系列针对鲁棒仿真到现实迁移的设计,并将策略部署在 Unitree G1 人形机器人上。我们的方法在真实世界中取得了令人惊讶的结果,能够与人类选手稳定地进行多拍对打,如图1所示。

代码:https://github.com/GalaxyGeneralRobotics/LATENT
项目页面:https://zzk273.github.io/LATENT/

1 引言
学习竞技体育技能仍然是人形机器人的核心挑战之一。此类运动通常需要高度动态的动作、快速反应和高精度。以网球为例,运动员通常需要在球场上以超过 6 m/s 的速度冲刺,对以 15-30 m/s 飞行的来球做出反应,并在仅几毫秒的极短球拍接触时间内击球。这些特点使得通过人类-人形机器人遥操作直接模仿学习来收集人形机器人动作数据变得不可行,对在人形机器人上复现竞技网球技能构成了重大挑战。
另一种方法是使用运动学人体运动数据作为参考。然而,网球通常涉及:(i) 跨越半个球场的大范围人体运动,(ii) 持续的多拍交互,以及 (iii) 击球过程中细微且高度精确的手腕运动。这些特点使得运动捕捉系统极难从真实比赛中收集精确完整的人体网球运动数据。Vid2Player3D 44 通过利用广播视频缓解了这一问题。然而,它需要一个复杂的流程从单目视频中提取人体运动数据,包括球员检测、相机估计、2D 和 3D 人体姿态估计,随后是带有外部残余力以校正运动伪影的模仿策略。组装这些模块可能需要大量的专业知识和工程努力。
在本工作中,我们提出了 LATENT,一个新颖的系统,从不完美人体运动数据中学习竞技人形机器人网球技能。不完美人体运动数据仅包含捕捉网球运动中所用基本技能(例如正手击球、反手击球、侧向滑步、交叉步等)的运动片段,而非来自真实网球比赛的逼真完整人体网球运动序列,从而显著降低了数据收集难度。这里,不完美表现在两个方面:1 不精确。由于运动捕捉困难和跨具身差距,挥拍过程中的手腕运动通常不精确。2 不完整。运动数据仅提供关于自然运动技能的先验,不包含如何将其用于网球任务的任何知识。我们的核心见解是,尽管不完美,这些准真实数据充分提供了网球场景中人类基本技能的先验。这些知识,经过进一步校正与组合,可用于学习网球技能,同时保持自然的人类行为。
我们的方法建立在近期分层人形机器人控制与潜在动作空间的思想之上:构建一个潜在空间来表示自然人形机器人动作,然后训练一个高层策略从中采样以完成网球回球任务。我们提出了两个新颖的设计来缓解数据的不完美性。首先,为了弥合高精度人体-网球交互与不精确准真实人体运动数据之间的差距,我们设计潜在空间以兼容高层策略预测的潜在动作校正。其次,由于运动数据不包含关于如何利用这些基本技能来返回网球的任何知识,高层策略在学习完成任务时可以轻易地利用潜在空间。为了平衡任务性能与对基本技能先验的遵循,我们设计了一个潜在动作屏障,根据基于状态的动作分布先验来约束高层策略的 RL 探索。
为了实现鲁棒的仿真到现实迁移,我们还提出了一系列针对鲁棒仿真到现实迁移的精心设计,包括应用于机器人和网球的动力学随机化与观测噪声。我们将方法部署在 Unitree G1 硬件上,能够与人类选手稳定地进行多拍对打。
我们的贡献有四个方面:
我们提出了 LATENT,一个从不完美人体运动数据中学习竞技人形机器人网球技能的新系统,为未来研究铺平了道路。 我们提出了两个新颖的设计,以更好地从不完美人体运动数据中构建和利用潜在动作空间。 我们成功地将方法部署在真实世界的人形机器人上,能够与人类选手稳定地进行多拍对打。 在仿真和真实世界中进行了大量实验,验证了我们主要设计的有效性。
2 相关工作
2.1 用于人形机器人控制的潜在动作空间
由于人形机器人具有高自由度(DoFs),从零开始学习技能通常导致 RL 采样效率低和动作不自然。为了解决这个问题,学习一个潜在动作空间,从预先记录的人体运动数据中编码可重用的基本技能,然后训练高层策略在该潜在空间内采样,已被广泛研究 44, 46, 38, 39, 18, 19, 22, 28, 4, 23, 35, 13。一些先前工作 44, 23 学习运动学运动潜在空间,随后使用预训练的运动跟踪器完成下游任务。然而,生成的运动学运动通常表现出物理不可行性,对跟踪器构成重大挑战。相比之下,一些工作 46, 38, 39, 18, 22, 28, 13 直接学习关节动作的潜在空间。PULSE 18 从通用运动跟踪器中蒸馏出 VAE 风格的潜在动作空间。RS 46 在真实人形机器人上采用这一思想,从一组预训练的基本技能中学习潜在空间,以解决移动操作任务。
与现有工作相比,我们专注于从不完美人体运动数据中学习竞技人形机器人网球技能,这些数据仅包含不精确和不完整的基本技能。我们提出了两个关键的新颖设计来校正和组合这些不完美的人体运动先验,使高层策略能够学习完成任务,同时保持自然的运动风格。
2.2 用于体育的人形机器人
用于体育的人形机器人长期以来一直是角色动画的核心主题。大量工作 44, 20, 32, 41, 37, 11, 45, 30, 36, 15 被提出以使人类能够进行各种运动,包括网球 44、篮球 32, 41, 37 和足球 11。其中,与我们最相关的工作是 Vid2Player3D 44,它构建了一个模拟角色,可以使用多种击球方式将来球击打到目标位置。然而,这项工作依赖于若干物理上不可行的假设,例如无限的关节扭矩和根部的残余力 42,并且未考虑整个系统的仿真到现实差距。此外,我们的工作重点是如何利用易于收集但不完美的人体运动数据来学习网球技能。
随着人形机器人硬件的最新进展,若干工作 6, 27, 14, 10, 31, 34, 40, 33, 3, 12, 24 成功在真实世界人形机器人上学习运动技能,包括乒乓球 27, 10、羽毛球 14, 3、足球 31, 34, 12 和拳击 40。然而,这些工作通常缺乏高度动态的动作、敏捷的身体协调或快速反应。我们的工作在实现竞技人形机器人运动技能方面迈出了重要一步。
3 使用 LATENT 学习网球技能
LATENT 的概述如图2所示。我们的方法包括三个阶段。首先,我们使用紧凑的运动捕捉系统收集不完美人体运动数据(即基本技能的运动片段,如正手击球、反手击球、侧向滑步、交叉步等),见 3.1 节。然后,我们在 3.2 节中使用收集的不完美数据构建一个兼容潜在动作校正的潜在动作空间。最后,我们在 3.3 节中训练一个高层策略来校正和组合存储在潜在空间中的基本技能,以执行网球技能。
我们使用 PPO 26 作为强化学习框架,使用 MuJoCo JAX 29, 43 进行训练仿真。我们在 8 个 GPU 上并行训练策略。我们的高层规划器和低层控制器以 50Hz 运行,仿真频率设置为 2000 Hz,以准确模拟球拍和球与地面的接触。
3.1 不完美人体运动数据的收集
尽管由于网球运动的大范围移动、多拍特性和高精度要求,从真实网球比赛中收集全面的人体网球运动数据既困难又昂贵,但获取所涉及的基本动作技能则要容易得多。
我们邀请五名业余网球选手在光学运动捕捉系统中收集网球中常用的基本技能,包括正手击球、反手击球、侧向滑步、交叉步等。由于我们仅收集基本技能演示而非网球比赛中的完整运动序列,对运动捕捉系统的要求显著降低。在我们的设置中,系统仅覆盖 的有效区域,比完整网球场小 17 倍以上,与在网球中收集完整人体运动数据相比,在捕捉区域和相机数量上都大幅节省。
总共,我们收集了五小时的运动数据,未进行任何编辑或标注。收集后,我们使用 LocoMuJoCo 1 将人体运动重定向到人形机器人运动。
3.2 可校正潜在动作空间构建
为了学习基本技能的潜在空间,我们首先训练一个运动跟踪器来模仿收集的运动数据,然后使用变分信息瓶颈将其蒸馏为潜在模型。
3.2.1 运动跟踪器预训练
为了将嘈杂的人形机器人运动数据转换为可执行的人形机器人基本技能,我们训练一个运动跟踪器来模仿收集的运动数据。我们使用 Any2Track 47 的运动跟踪框架。我们的跟踪器可以看作一个 RL 策略 ,它将人形机器人本体感觉状态和运动目标映射到低层机器人动作。在每个时间步 ,策略 的输入包括当前状态 和来自收集运动数据的当前运动目标 。当前状态 包括角速度、投影重力、每关节位置、每关节速度和上一帧动作。策略 需要输出关节动作 ,进一步输入 PD 控制器以计算执行器扭矩。运动跟踪的任务目标是,在时间步 ,机器人状态 应尽可能接近 所描述的目标运动,同时保持平衡和安全。
如前所述,我们收集的运动数据不包含击球过程中精确的手腕运动,并且在人体到人形机器人重定向过程中误差进一步放大。因此,在后续步骤中,高层策略需要为手腕关节提供校正调整。为了使控制器能够鲁棒地处理这些潜在校正,同时保持稳定性,我们在训练期间从 中移除关于右腕(持拍)的控制信号,并对右腕关节施加额外的随机扰动。跟踪器需要在未知手腕扰动下模仿其余关节的运动。

3.2.2 带变分瓶颈的在线蒸馏
在学习模仿收集的人体运动片段后,跟踪器现在包含足够的打网球的基本技能。为了学习这些基本技能的紧凑且结构化的表示,我们通过在线蒸馏 18, 46, 17 训练一个具有潜在表示的学生网络。对于学生网络,我们采用编码器-解码器框架,带有条件变分信息瓶颈,将技能编码在连续技能空间中,包括一个后验变分编码器 来建模以当前状态和运动目标为条件的潜在编码分布,一个解码器 将采样的潜在编码映射为以状态为条件的动作。
在训练期间,我们通过 编码 ,并采样潜在编码 。然后我们使用解码器将 解码为人形机器人动作 。我们训练网络重构教师跟踪器的动作 ,并保持潜在分布接近先验。总损失可以写为:
其中
是 DAgger 25 的监督损失,一种在线蒸馏方法。 表示由学生当前状态 和教师动作 组成的数据缓冲区。同时, 表示学生策略的动作。如前所述, 和 不包含右腕的任何控制信号。我们在在线蒸馏期间保持右腕关节的扰动,使潜在空间对此类扰动具有鲁棒性。
我们不是像通常 VAE 那样针对固定的单峰高斯训练网络,而是使用可学习的条件先验 来捕获基于状态的动作分布,因为不同机器人状态的动作分布差异显著(例如,侧向滑步与击球挥拍)。KL 散度损失:
鼓励编码后验分布接近可学习先验。
3.3 高层策略学习
我们训练一个高层策略 来校正和组合预构建潜在动作空间中存储的基本技能,以实现竞技人形机器人网球行为。在每个时间步 ,高层策略 的输入包括当前机器人状态 、机器人根姿态的全局信息 和球状态 。
3.3.1 任务设置
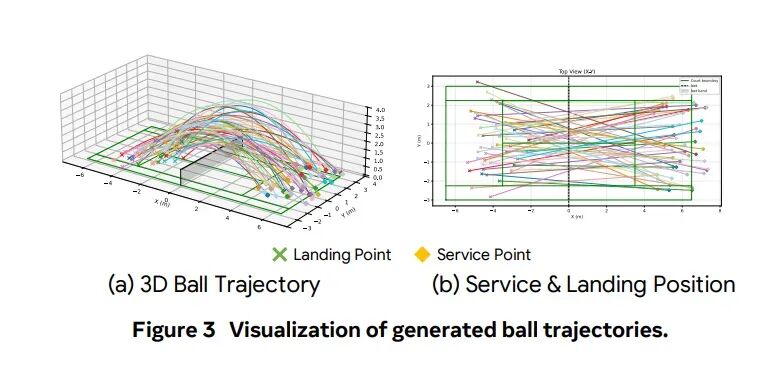
在每个回合开始时,人形机器人随机初始化在球场上的某个位置,处于准备姿势。在每个回合中,机器人需要连续将八个网球返回到目标位置,每个球具有不同的初始位置和速度。我们工作中生成的球轨迹如图3所示。来球每 2 秒发射一次。奖励如表1所示。
表1 LATENT 中使用的奖励项。奖励项分为三种类型:任务、正则化和终止。
| 任务 | |||
| 正则化 | |||
| 终止 | |||
3.3.2 动作校正
准确捕捉人类运动员挥拍过程中细微的手腕运动极其困难。人类与人形机器人之间的具身差距进一步放大了这种差异。因此,重定向后的手腕运动高度不准确,无法直接使用。为了缓解这个问题,我们采用混合控制方法 44。高层策略同时输出 ,包括潜在动作和右腕的直接控制命令。由于潜在动作空间设计为对右腕校正具有鲁棒性,高层策略可以输出任意手腕运动调整,而不会损害下半身运动的稳定性和敏捷性。
3.3.3 潜在动作屏障
学习到的潜在空间创建了由预先收集的人体运动数据表征的基本技能的紧凑连续流形。我们旨在学习一个高层策略,能够校正和组合这些基本技能以完成网球回球任务,从而使策略在完成任务的同时保持运动自然性。然而,由于我们的不完美人体运动数据仅提供关于自然运动技能的先验,不包含如何将其用于网球回球任务的任何知识,高层策略需要通过强化学习发现如何利用这些技能来完成任务。一个关键挑战在于高层策略训练期间任务性能与遵循基本技能先验之间的平衡。尽管潜在空间包含许多高质量的基本技能,但如果没有适当的约束,高层策略在 RL 训练期间可以轻易地利用这个空间,采样次优动作并将其组合成不自然、抖动的运动序列。例如,高层策略可能在跑向来球时在不同运动基本技能之间来回切换,导致低质量运动,尽管如此仍成功完成任务。

为了解决这个问题,我们提出约束高层策略的探索空间。可学习的条件先验分布 描述了状态相关的动作分布,可以作为良好的起点。 的动作空间可以形成相对于先验均值 的残差动作空间 18, 46。
然而,基本技能的流形不仅由先验均值决定,还由相关方差塑造。如果残差潜在动作 的探索空间不受约束,高层策略仍然可以轻易采样显著偏离先验均值 的潜在动作,最终将其解码为次优运动动作。因此,我们提出将残差潜在动作 的探索范围约束在先验均值 周围的潜在动作屏障内。在我们的设置中,我们观察到先验标准差 在不同状态之间以及潜在空间的不同维度之间变化显著。因此,我们基于马氏距离而非欧几里得距离设计屏障(即屏障范围根据状态相关标准差自适应缩放)。最终的 PD 目标动作可以

5 实验
5.1 与基线方法的比较
表3 与基线方法的比较。粗体数字表示最佳性能。
| 96.52 | 1.32 | 25.61 | 7.40 | 82.10 | 1.89 | 27.76 | 7.71 | 86.35 | 1.73 | 25.51 | 7.47 | 89.80 | 1.55 | 27.20 | 7.60 |
表4 消融研究。粗体数字表示最佳性能。
| 96.52 | 1.32 | 25.61 | 7.40 | 82.10 | 1.89 | 27.76 | 7.71 | 86.35 | 1.73 | 25.51 | 7.47 | 89.80 | 1.55 | 27.20 | 7.60 |
5.1.2 实验指标
我们使用以下两个指标来衡量任务性能:
成功率 (SR) 记录人形机器人成功将网球返回到目标位置 2.5 米范围内的试验百分比。距离误差 (DE) 是返回网球实际落点与目标位置之间的平均距离。我们还使用以下两个指标来衡量人形机器人的动作质量:平滑度 (Smith) 是每个关节的平均加速度,用于衡量人形机器人动作的自然性和稳定性。扭矩 (Torque) 是每个关节的平均扭矩,用于衡量人形机器人动作的物理可行性和硬件安全性。
5.1.3 基线
我们选择以下方法作为基线:
PPO 26:我们直接使用原始 PPO 算法训练策略以完成网球回球任务,没有任何人体运动先验。
MotionVAE 44:我们采用 Vid2Player3D 中使用的 MotionVAE 框架,训练基于运动学的运动 VAE。高层策略训练在潜在运动空间中采样。采样的潜在编码被解码为运动学运动,然后由解耦的运动跟踪器跟踪。
AMP 21:我们采用 AMP,一种通过对抗训练融入人体运动先验的强化学习框架。
ASE 22:我们采用 ASE,一种学习可重用对抗训练技能嵌入以完成高层任务的方法。
PULSE 18:我们采用 PULSE,它通过从预训练运动跟踪器在线蒸馏学习 VAE 风格的运动表示。与我们方法的关键区别在于,在此基线中,我们严格遵循原始论文的流程构建和采样潜在空间,不应用任何手腕校正。
5.1.4 实验结果
结果如表3所示。“N/A”表示方法无法收敛。LATENT 在网球回球任务性能和动作质量方面优于基线方法。对于原始 PPO,没有任何运动先验,从零学习网球技能极其困难。我们实现了 Vid2Player3D 中提出的 MotionVAE。然而,我们发现运动生成器和跟踪器的解耦设计对两个组件都提出了严格要求。运动生成器生成的低质量运动会使准确跟踪变得困难,进而进一步降低自回归生成的运动学运动的质量。这种累积误差会迅速导致机器人失去平衡并摔倒。Vid2Player3D 44 通过引入残余力和依赖不现实的物理假设来缓解这个问题。然而,真实机器人部署的要求阻止我们采用此类假设。对于 AMP 和 ASE,我们发现这些基于对抗学习的方法难以在任务完成和遵循运动先验之间取得平衡。对于 PULSE,我们发现其构建和利用潜在动作空间的方法导致采样动作质量较低。此外,缺乏手腕级校正进一步降低了其任务完成性能。
5.2 关键组件消融
为了解决 Q2(每个组件对 LATENT 最终性能的贡献如何?),我们对方法的每个关键组件进行了消融研究。
5.2.1 实验设置与指标
我们采用与 5.1 节相同的实验设置和指标。
5.2.2 基线
我们选择以下方法作为基线:
我们的 w/o Correction (w/o Corr.):我们训练一个全身运动跟踪器,包括右腕关节,然后将其蒸馏为所有关节的潜在空间。高层策略不允许校正右腕动作。
我们的 w/o Latent Action Barrier (w/o LAB):我们移除潜在动作屏障,允许高层策略以无约束方式输出残差潜在动作。
5.2.3 实验结果
结果如表4所示。我们的关键设计对最终性能有贡献。没有手腕校正,策略的成功率显著下降。没有潜在动作屏障,高层策略倾向于利用潜在空间采样次优动作,导致抖动的运动序列,最终降低整体策略性能。
5.3 真实世界性能评估
为了解决 Q3(LATENT 在真实世界中表现如何?),我们进行了真实世界实验。
5.3.1 实验设置
我们进行 20 次连续人-机器人对打比赛,以评估我们的策略在真实世界中的网球回球性能,球的初始位置和速度随机化。对于每个成功返回的球,我们记录落点位置,将其分类为前场或后场区域,并分析正手和反手击球的使用。
5.3.2 实验指标
我们仍然采用成功率 (SR) 和距离误差 (DE) 作为指标。然而,由于仿真到现实的差距,我们观察到真实世界性能的落点精度相对较低。因此,如果机器人成功将球返回到对手球场边界内,我们认为试验成功。
5.3.3 基线
由于人形机器人本身的仿真到现实迁移已在先前工作中广泛研究 47, 8, 7,且不是本文的主要焦点,我们设计基线主要验证融入球动力学随机化和观测噪声的有效性。
我们的 w/o Dynamics Randomization (w/o DR):在此基线中,我们移除应用于球的所有动力学随机化。
我们的 w/o Observation Noise (w/o ON):在此基线中,我们移除应用于球的所有观测噪声。
表5 真实世界性能。粗体数字表示最佳,下划线数字表示第二。
| 90.90% | 3.15 | 77.78% | 3.89 | 88.89% | 3.57 | 81.82% | 3.80 |
5.3.4 实验结果
真实世界评估结果如表5所示。我们的方法展示了强大的真实世界性能。我们表明,充分随机化球动力学和观测可以实现有效的仿真到现实迁移,而无需依赖精确的系统辨识。
6 结论
我们提出了 LATENT,一个从不完美人体运动数据中学习竞技人形机器人网球技能的新系统。我们成功地将方法部署在真实世界的人形机器人上,能够与人类选手稳定地进行多拍对打。尽管本工作主要关注网球回球任务,但所提出的框架有潜力推广到更广泛的、无法获得完整高质量人体运动数据的任务(例如足球和跑酷)。
当前工作提出了若干潜在改进方向。首先,所提出的方法在真实世界部署中依赖运动捕捉系统。引入主动视觉可以帮助缓解这一限制。其次,当前任务公式侧重于将随机初始化的来球返回到目标位置,这仍与真实双人网球比赛不同。达到与职业人类选手相当的性能水平可能需要引入多智能体训练框架。
本文仅做学术分享,如有侵权,请联系删文。
3D视觉工坊中秋国庆双节专属课程福利重磅来袭!为回馈新老学员一路支持,本次活动特推出重磅折扣福利,所有课程统一享8折特惠,其中10余门课程加入知识星球可一次性全部购买学习(限时福利仅需279元)!
中秋国庆双节八折特惠
中秋国庆专属8折优惠 微信扫码领取,限时三天内使用
3D视觉工坊所涉及课程的包括但不限于:工业3D视觉、自动驾驶、SLAM、具身智能、扩散模型、无人机、大模型和3D视觉基础等。

专属打包福利
上图中的:ROS2、相机标定、线结构光、3D缺陷检测、激光-视觉-IMU-GPS融合SLAM、VINS-Fusion、模型部署、3D目标检测、深度估计、多传感器融合这10门课程,除各自单独购买享8折外,也支持一次性全部购买,限时福利仅需279元,扫描下方二维码加入一次性全部解锁!

活动咨询




