拿起杯子、拉开抽屉、整理桌面,人类每天都在完成丰富的操作。如何让这些经验进入机器人的学习过程?UniWAM 通过数据处理、共享监督与统一架构,将人类操作经验转化为机器人的操作能力。
从人机联合学习,到多项基准 SOTA;代码与权重现已开源。 UniWAM 在 LIBERO、LIBERO-Plus 和 RoboTwin 2.0 C2R 上分别取得 99.2%、92.6% 和 68.32% 的成功率。这些成绩展示了人机联合学习在标准操作与泛化任务中的效果,代码与权重为社区提供了直接使用和继续研究的入口。
项目与开源入口:
项目主页:uniwam.github.io
Github代码:UniWAM/UniWAM
ModelScope 模型权重:modelscope.cn/collections/Kosmos524/UniWAM
Huggingface 模型权重:collections/chenpyyy/uniwam

从架构到数据:具身 Scaling 的关键问题
拿起杯子、拉开抽屉、整理桌面,人类每天都在产生丰富的操作经验。对具身模型而言,怎样让这些经验成为可以大规模利用的训练信号?
主流 VLA 与 WAM 设计逐渐趋于相似:以 VLM 或 VGM 为主干,搭配流匹配动作专家。站在 Scaling 的角度,研究的关键从固定数据量下的架构表现,进一步转向架构能利用多少数据、又能多充分地利用数据。
第一视角数据具有很大的扩展潜力。相较机器人与 UMI 采集,它可以借助更简易、低成本的穿戴设备记录日常行为;自然操作还带来丰富的物体、场景与动作变化。利用好这些数据,是扩展具身预训练规模、丰富模型操作经验的关键。
UniWAM(Unified World-Action Model,统一世界与动作模型)通过人机联合训练打通这条路径。 人类数据参与预训练,提供丰富的运动与交互经验;机器人后训练将这些经验落实到控制,仿真与真机评测展示最终操作效果。
第一视角数据的难点:动作标签有噪声,但运动信息仍有价值
第一视角动作标签常由手部追踪与三维估计得到,容易受到遮挡、相机运动和深度误差影响。对于 WAM,一条可行路径是只用视频训练视觉预测,从而避开动作标签误差。
但视频中的动作与轨迹本身也是重要经验。理解交互动态,需要关联采取的动作与随后的变化;若只利用画面,就没有充分使用其中的运动信息。UniWAM 的目标是充分利用其中的运动信息,让有噪声的动作标签参与规模化学习。
团队对所分析标注管线的观察是:二维轨迹通常保留了较可靠的形状与运动趋势,而深度与绝对尺度更难准确估计。这意味着,标签的某些数值可能有偏差,但方向、轨迹结构与动作意图仍然可以成为监督线索。
先把长视频组织成局部操作
UniWAM 使用子任务级标注,将语言描述与对应的视频事件关联。团队为 EgoDex 补充 EgoANT 自动分段与标注:先浏览整段视频提出粗边界,再在局部窗口细化,随后生成并选择片段描述。

流程关注带来物体状态变化的操作,如拿起、放下和打开。EgoVerse、VITRA 的已有标注保留使用,机器人数据则检查异常轨迹、时序一致性与视觉有效性。局部语义和有效运动信息由此得到更清晰的对应。
用物理语言连接不同本体
受到 LAP 的启发,我们用自然语言为第一视角人类数据与机器人数据构建共享监督,文中称为 physical language(物理语言)。
物理语言保留动作段中的运动含义。用自然语言组织方向、位移与旋转,例如“向前移动 5.5 cm,再顺时针转动 30°”,就可以把数值与动作意图放到同一表达中。这个例子用于说明表示方式,语言词汇也与 VLM 既有的语义空间相衔接。
对于有噪声的人类标签,这种方式侧重保留运动趋势与意图,减弱对精确连续数值的依赖。它将可用的运动信息组织成共享监督,使人类与机器人经验能够共同参与学习。连续动作仍由动作预测器建模,文本目标用于辅助监督。
在搭建的清洗与标注管线上,团队处理超过一万小时机器人与人类第一视角数据,并混合 VQA 问答数据。机器人示范、人类操作与 VQA 分别提供控制经验、丰富的操作样本和视觉语义监督,共同服务于预训练。
物理语言促进跨本体共同表征学习
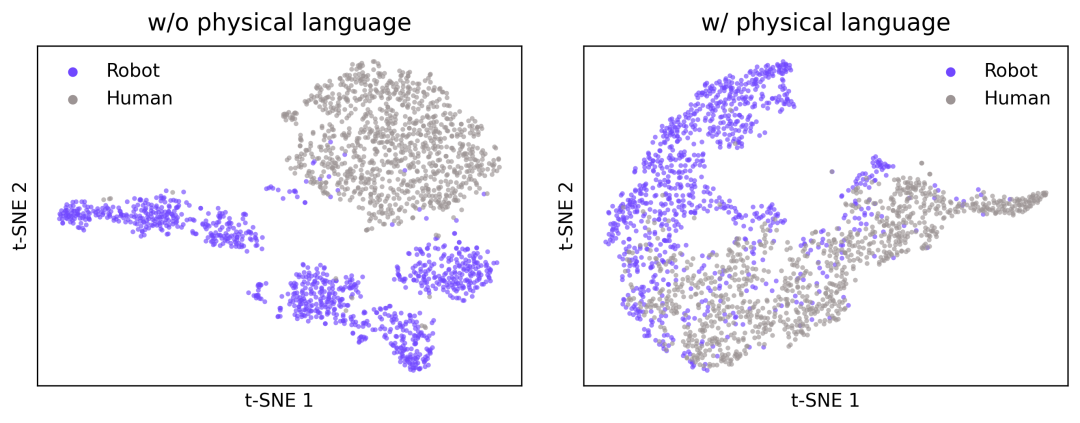
物理语言监督促进 VLM 学习不同本体之间的共同表征,从人类与机器人的操作中提取共性的运动意图与操作语义。加入监督后,人机表征在可视化中呈现更多重叠,不同本体的经验通过共享语义联系起来。
表征可视化与下游消融从两个层面展示了共享监督的效果:人机经验在表征中建立联系,联合训练进一步提升机器人操作成绩。

在机器人+人类方案中,保留语言—动作监督使 C2R 成功率从 56.40% 提升至 67.56%,提高 11.16 个百分点。共享动作语义是发挥人类数据价值的重要训练环节。
机器人单源预训练的平均成功率为 67.53%,加入人类数据后达到 71.34%,进一步混合 VQA 后达到 71.73%。机器人控制经验、人类运动经验与视觉语义监督共同构成了有效的训练配方。
共享经验需要统一的学习架构 有了不同来源的监督,模型还需要把理解、视觉变化与控制连接起来。UniWAM 采用三个组件:
Physical Reasoner(物理推理器):基于 Qwen3-VL-2B-Instruct,编码场景与任务的语义信息。
World Generator(世界生成器):基于 Wan2.2-TI2V-5B,学习未来视觉变化。
Action Predictor(动作预测器):建模连续动作流场,预测机器人动作片段。
三个组件通过联合多模态注意力交换信息。人类视频中的动态经验、语言中的操作含义和机器人示范中的控制信息,因而能够在统一架构中共同参与学习。

学习到的能力还需要高效执行。后训练中,UniWAM 利用经过扰动的历史动作初始化生成过程,同时对未来视觉表示加入噪声,降低动作生成对精确视觉预测的依赖。
在动作生成对比中,历史初始化方案用 4 步得到 C2C 75.14%、C2R 68.32%,接近同方案 10 步的结果。这里的步数指生成过程中的更新次数。

模型怎样适应具身任务?
物理推理器继承视觉语言模型的知识,同时需要适应操作场景。论文的训练策略消融按照解冻、加入语言—动作监督、加入预训练的顺序逐项增加训练措施:

随着解冻 VLM、加入语言—动作监督和预训练,平均成功率从 42.61% 逐步提升至 71.34%。这组累积消融展示了视觉语言知识向具身控制能力的有效适配路径。

过去的动作,也是一种可用经验
人类经验参与预训练,机器人近期动作则为当前生成提供起点。两者在不同阶段发挥作用:前者扩大训练经验,后者帮助连续控制利用已经发生的运动。

历史初始化在 4 步与 10 步时的平均成功率分别为 71.73% 和 71.79%,仅相差 0.06 个百分点。利用近期动作作为起点,让 UniWAM 在少步生成下保持较高的操作成功率。
人类数据的收益,与规模有关
回到最初的问题:人类视频能否帮助机器人?UniWAM 的规模实验显示,答案与训练数据规模有关。
实验比较了不同机器人数据规模下,机器人数据组与额外加入人类数据的混合组;各组均包含 VQA。随着机器人数据从数百小时增长至数千小时,下游表现持续改善。
在较小规模时,加入人类数据可能降低性能;当机器人数据达到约 1000 小时后,混合训练开始带来收益,且在更大规模时更明显。
实验揭示了人机联合训练的规模收益:随着数据规模扩大,人类经验对机器人操作的贡献更加明显。充分扩展数据,是释放跨本体联合学习价值的重要条件。

混合预训练的收敛验证损失与数据规模呈对数—线性关系,拟合 R² 约为 0.983。在探索范围内,这为继续扩展人机联合训练提供了实验依据。
验证损失的下降与下游任务成绩的提升相互呼应,支持以第一视角数据扩展具身预训练的研究路线。
对具身 Scaling 而言,数据规模与有效监督需要共同建设。UniWAM 将数据清洗、局部操作标注和物理语言监督结合起来,为大规模利用第一视角经验提供了具体方案。
相近研究方向:EgoLAP 的语言动作接口
在 UniWAM 发布后,来自 Princeton University、Toyota Research Institute(TRI)和 Physical Intelligence(PI)的团队发布了 EgoLAP。它同样通过共享的语言动作目标连接人类与机器人数据,并进一步结合运动层面的推理监督。这一相近方向,让我们更有信心继续探索语言化动作接口在人机联合学习中的价值。

EgoLAP 与 UniWAM 共同关注用语言表达可迁移的运动信息。相近的研究选择进一步体现了语言动作接口在人机联合学习中的研究价值;UniWAM 则将这一接口与统一世界—动作建模结合起来。
学习收益如何体现在操作上?
联合训练的价值,最终要在机器人任务中检验。UniWAM 在标准操作与环境变化评估中取得多项基准 SOTA,为完整联合学习方案的效果提供下游验证。具体结果如下:

LIBERO-Plus 包含背景、视角、语言、光照等变化;RoboTwin C2R 考察训练环境之外的随机化条件。LIBERO 平均、LIBERO-Plus 整体与 RoboTwin C2R 成绩,均为论文对应表格所列方法中的最高值。
迁移效果也要经受环境变化
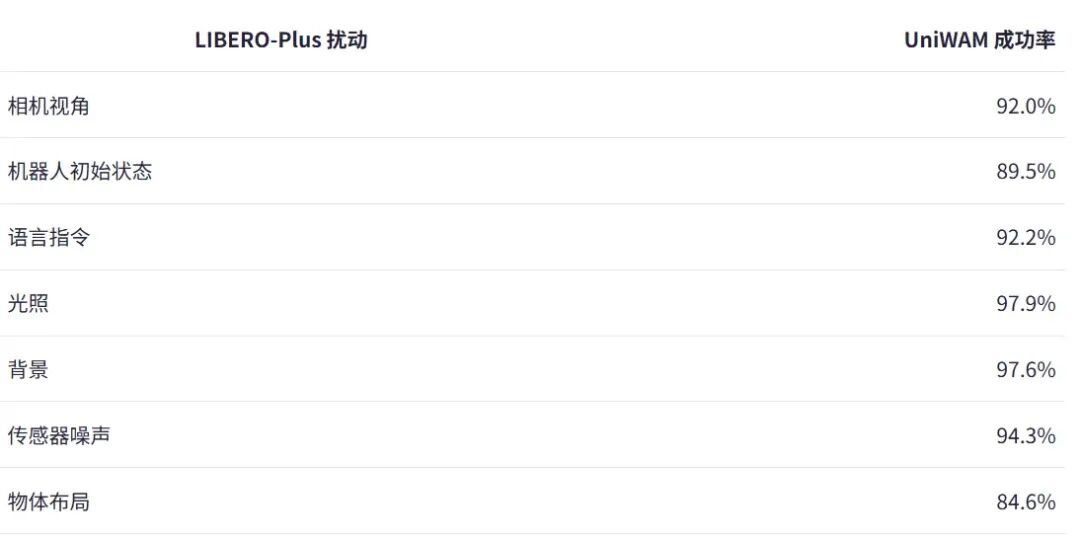
从相机视角、光照和背景变化,到语言表达与物体布局变化,UniWAM 在七类扰动下保持较高成功率,整体达到 92.6%。
UniWAM 在机器人初始状态、语言、光照与背景四项评测中均取得论文所列方法的最高成绩,在物体布局变化下达到 84.6% 的成功率,展现了面对多种环境变化的泛化能力。
RoboTwin 中,UniWAM 从 C2C 到 C2R 的成功率仅下降 6.82 个百分点,π₀.₅ 对应下降 24.70 个百分点。UniWAM 在随机化环境中取得 68.32% 的领先成功率,展示了从标准训练环境向变化测试环境迁移的能力。
在双臂 AgileX Piper 真机平台上,四类任务的平均成功率为 67.5%,指令跟随率为 82.5%。前者衡量任务完整完成,后者衡量是否选对目标物体与交互方式。
长程桌面整理时,模型接收一句高层指令“Tidy up the desk.”,在 0–6 分的任务进度指标上得到 5.0 分,π₀.₅ 和 Motus 分别为 4.8 和 3.2。这一评分体现连续阶段的完成程度。
从语言落地,到连续执行

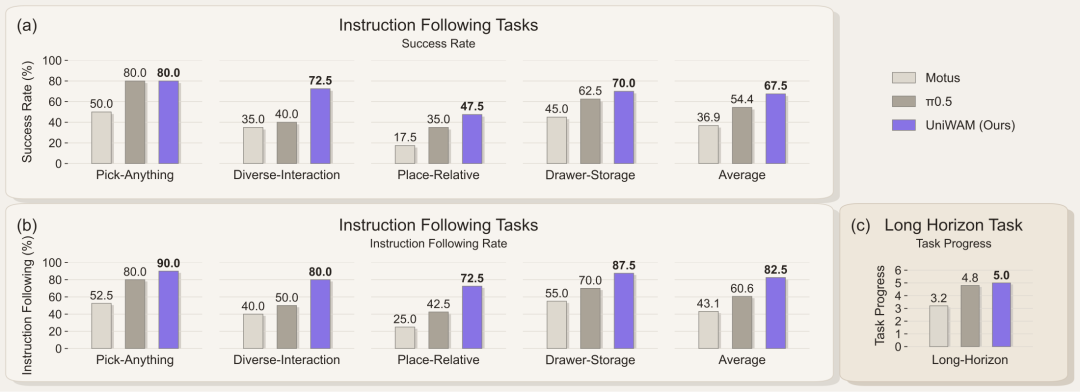
真机四类任务逐步增加要求:抓取指定对象、对不同对象实施不同交互、按相对位置放置物体,以及双臂配合完成抽屉收纳。它们把物体、动词与空间关系的理解落实到机器人操作。
在不同交互任务中,UniWAM 成功率为 72.5%,指令跟随率为 80.0%;π₀.₅ 对应为 40.0% 和 50.0%。选对交互与完成交互,是两个相关但不同的能力。
长程任务的进度节点覆盖两次杯子放置、打开抽屉、放入目标、关闭抽屉和笔的收纳。训练时提供细分子任务描述,推理时接收高层指令。实验因此检验了模型能否依据场景与执行状态持续推进任务。
真机比较使用每任务 200 条示范,各方法联合训练单个策略,并采用同一训练协议。UniWAM 在这一设置下展现了语言指令落地与长程连续执行的操作能力。
从视频里的日常行为,到机器人的连续操作,UniWAM 将人类经验、共享动作语义与统一架构连接起来。共同表征学习、规模收益与操作成绩共同展示了这条路线的价值:让第一视角数据成为具身模型持续扩展能力的训练资源。
结语
具身模型的 Scaling,关键在于让更多经验成为有效的训练信号。UniWAM 用物理语言连接人类与机器人的操作,让 VLM 学习跨本体的共同表征,再通过统一的理解、预测与行动架构,将这些经验转化为机器人能力。
从人机联合训练的规模收益,到多项基准 SOTA,再到真机上的指令跟随与连续执行,UniWAM 展示了多源、多模态数据联合训练推动具身能力提升的价值。代码与权重现已开源,欢迎大家使用、研究,共同推动人类操作经验向机器人能力的迁移。
-END-
点击下方卡片,关注【Xbotics具身智能实验室】
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀