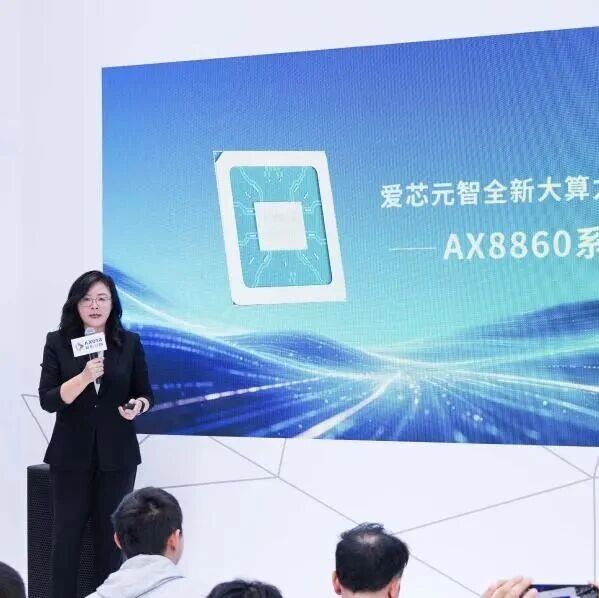
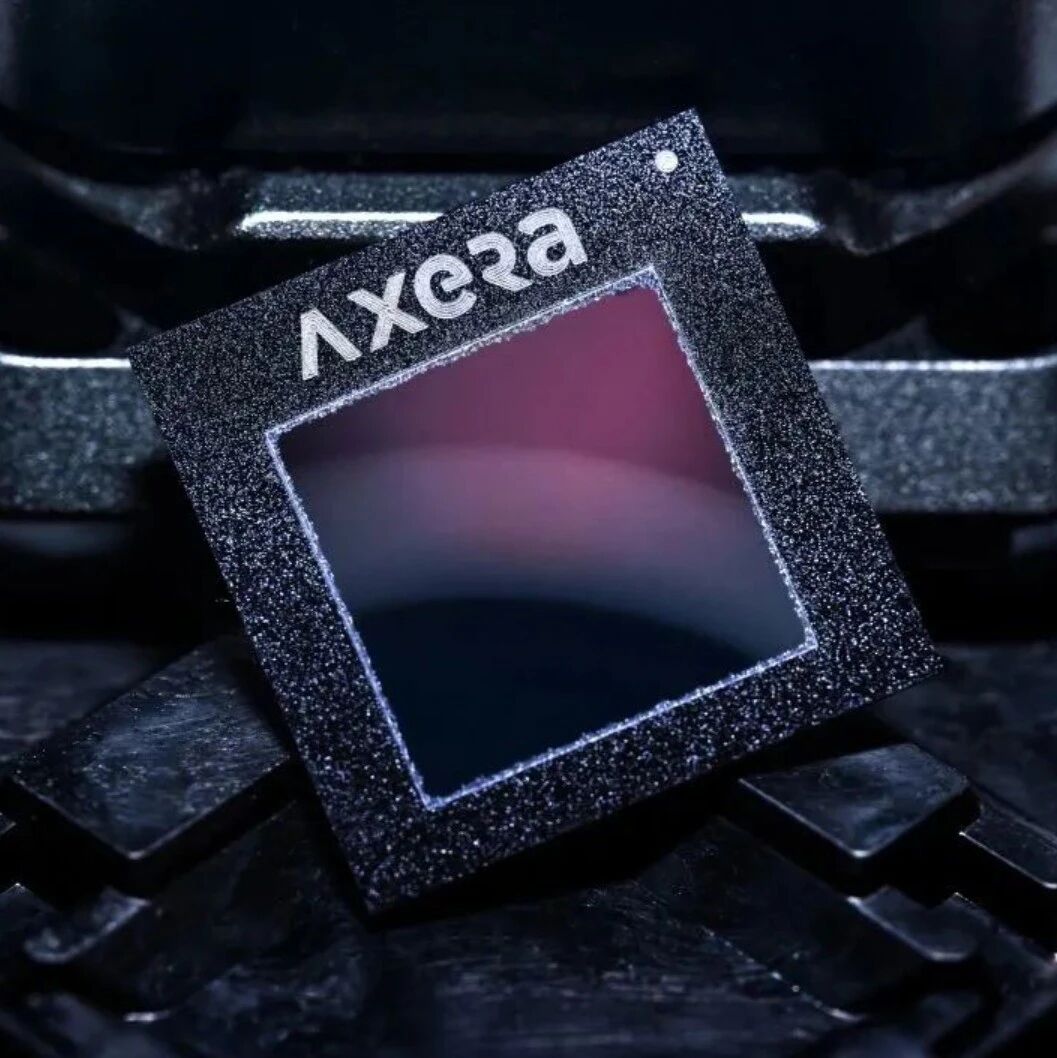
2026年10月13日,上海中国国际工业博览会现场,爱芯元智以“智造无界,算力抵达”为主题,正式发布AX8860大算力边端AI芯片系列,面向工业、机器人、企业本地部署等物理AI场景,推出从芯片、模组到推理卡、服务器的完整硬件产品矩阵,标志着边端大模型从技术验证走向业务落地的全新阶段。

来源:爱芯元智
在展会现场,爱芯元智创始人&董事长仇肖莘博士、边缘&终端计算产品线总经理刘瑞聚围绕新品技术、产业战略以及行业机遇与挑战,分享了国产AI芯片企业的思考。
不拼算力,为边端大模型而生
大模型持续轻量化迭代的当下,8B-27B参数模型已经成为边缘场景落地的主力,行业评判芯片的标尺也随之发生变化。算力、带宽、内存容量与功耗之间的综合平衡,成为决定大模型在边端运行效果的核心因素。爱芯元智在此时节推出的AX8860大算力边端AI芯片系列,正是顺着这一产业变化而来。

来源:爱芯元智
AX8860采用6nm工艺,提供256TOPS混合精度算力、原生支持FP4,配备273GB/s带宽与最高128GB LPDDR5X大内存,并支持AXLink级联、PCIe5.0互联与算力弹性扩展,具备64路解码、16路编码能力。
对于256TOPS的算力设定原因,爱芯元智介绍,在芯片定义阶段,团队观察到千问27B、35B等轻量化大模型快速普及,于是以“原生流畅运行8B-27B主流边缘大模型、实现30 Tokens/s吞吐”为目标,经多轮仿真验证,敲定整套硬件规格。
与国际竞品相比,AX8860在prefill、decode两个核心环节表现突出,满负载峰值功耗仅为竞品的45%。仇肖莘解释,prefill高度依赖算力,decode的瓶颈在内存带宽,竞品基于面向训练的GPGPU架构,用于推理时算力利用率仅30%-40%,而爱芯面向大模型专门设计的架构,利用率可达80%-90%,等效算力实现数倍提升。
目前AX8860已完成回片与基础Bring-Up调试,处于送样阶段,爱芯元智还同步推出元曦模组A256S,以及推理卡、推理服务器等形态。
平台级打法,应对碎片化市场
新品之外,值得关注的还有爱芯元智的产业打法。面对边缘AI市场高度碎片化情况,工业、车载、机器人、终端各赛道需求差异巨大,依靠单颗芯片无法全部满足。爱芯元智选择平台型路线:以ISPIP、NPUIP、编解码IP组成统一技术底座,通过IP复用与差异化组合,面向不同赛道定制芯片,以控制研发投入、支撑多条业务线并行。
这套平台策略,支撑起爱芯元智业务的递进式布局。据爱芯元智介绍,第一条落地的产品线是视觉处理芯片,作为整个公司的业务基座率先量产,为后续赛道拓展打下基础;第二个切入的领域是智能驾驶车载芯片,自2021年启动已形成完整产品矩阵;第三个方向便是AX8860所代表的边缘计算业务线。未来,视觉处理、车载智驾、边缘计算这三大业务,还将共同托举开拓可能的“第四条增长曲线”。
本地部署升温,具身智能等待跨越鸿沟
展望未来,爱芯元智判断,除工业现场外,企业本地AI部署将迎来快速增长。企业研发、运营数据高度敏感,而报表生成、文档问答等任务并不需要云端超大模型,27B级别即可胜任,基于AX8860的PCIe卡与本地盒子,恰好能化解企业的数据安全顾虑。
在家庭端,本地智能体盒子Agent Box被视为长期潜力赛道。依托本地算力运行家庭智能管家,搭配NAS分级存储并依靠模型蒸馏实现长期记忆。当前商业化难点主要来自成本与使用门槛,未来普及既需压硬件成本,也需靠自然语言交互做到即插即用。
具身智能的产业化落地,则是更为长期的目标。在爱芯元智看来,想要实现规模化商用,仍要突破三重核心瓶颈:一是工业严苛场景的低时延要求;二是垂类定制模型的快速部署能力;三是工业级稳定性,需要宽温域、冗余防护等设计。
而低时延恰恰是工业现场最棘手的挑战之一,为此爱芯元智设计了分层算力协同方案:由前端芯片部署在工业相机端,就地完成图像采集和初步推理;再交由AX8860这类大算力芯片承接后续高层决策计算。前端感知与后端算力联动,以此满足工业流水线对毫秒级响应的硬性要求。
结语
大模型浪潮之下,AI正从云端走向物理世界,工业制造、机器人、企业内部智能化,都迫切要把计算放到事件发生的现场。AX8860系列的发布,是爱芯元智平台战略的关键一步。
作为国产平台型AI芯片厂商,爱芯元智不追求单芯片能力顶尖,而是依靠IP复用的技术底座,并行推进车载、边缘、终端业务。正如仇肖莘所言:“我们要做客户长期稳定的算力底座,让企业聚焦业务创新,不用为算力迁移分心。算力不必远在天边,智能就该近在眼前。”
点这里👆加关注,锁定更多原创内容
*免责声明:文章内容系作者个人观点,半导体芯闻转载仅为了传达一种不同的观点,不代表半导体芯闻对该观点赞同或支持,如果有任何异议,欢迎联系我们。
推荐阅读

喜欢我们的内容就点“在看”分享给小伙伴哦~