> 本文来自社区投稿

引言
85.7% 到 26.7%,接近 60 个百分点的落差。
这是 GPT-5.6 Sol 在 Claw-Eval-Live 上,面对同一批任务的原始环境与 RES 扩展环境时的成功率。任务的核心目标、底层事实和完成要求都被保留,改变的是信息藏在哪里、资源如何连接,以及执行一步操作前需要满足哪些条件。
一项来自电子科技大学、香港科技大学等机构的研究,将这些变化组织成了一个可递归执行的框架:Recursive Environment Scaling,简称 RES。研究者希望回答的问题很直接:保持任务目标不变,能否通过持续改造环境,让 Agent 面对越来越长、依赖越来越复杂的执行过程?
论文给出了两方面证据。在三个基准的 294 个初始任务上,六个模型的任务成功率均有所下降;用 RES 环境收集的轨迹进行监督微调后,三个 Qwen3.5 Base 模型又在全部九组模型与基准组合中,超过了使用原始环境轨迹训练的对照组。环境复杂度,由此成为一个可以同时服务于评测和训练的扩展维度。

论文标题:Recursive Environment Scaling for General Long-Horizon Agents
论文链接:https://arxiv.org/abs/2610.16397
背景:一道任务有多难,环境决定了很大一部分
让 Agent 完成一项工作,指令往往只有几句话。但在真实执行中,同一个目标可能对应完全不同的工作量:数据是直接放在文件里,还是需要先找到索引再逐层检索?不同系统使用的标识能否直接匹配?导出数据之前,是否必须完成另一项准备操作?这些细节共同决定了 Agent 要维护多少状态、处理多少依赖,以及能否把过程推进到最后。
已有研究通过合成更多任务、延长参考解答,或从零生成新的交互环境来扩展 Agent 的经验。RES 把现有环境作为改造对象,保留任务的核心目标和完成要求,再逐步改变信息访问方式、资源关系和执行依赖。这样,同一个任务就能形成一组具有继承关系的环境版本,便于比较环境变化前后的表现。

方法:让环境递归生长,先保证任务仍然成立
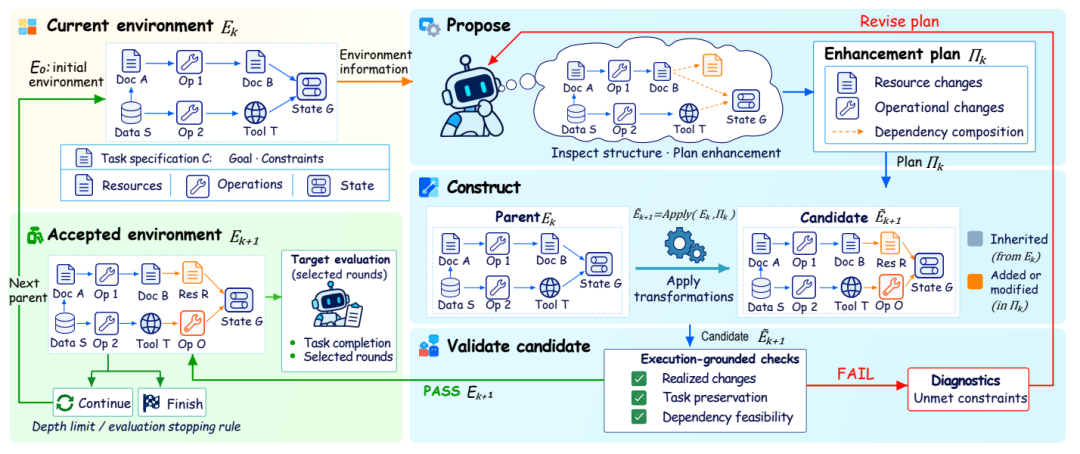
RES 的起点是一个已经通过验证的父环境。负责构造环境的 proposer 会检查它的资源与结构,从预定义的变换算子库中选择操作,指定作用对象、参数和执行顺序,生成候选子环境。
这些变换可以作用于多个层面。例如,把一份可以直接读取的文件拆成分片或分页视图;把一条记录的完整信息拆到摘要、详情和引用字段中;让不同来源的数据通过额外映射才能关联;或者给查询、导出等操作增加准备步骤。多个变换还能组合起来,使后续动作依赖此前获得的证据或环境状态。
递归的关键在于继承。一个子环境通过验证后,会成为下一轮构造的父环境,后续变换在已有结构上继续叠加。第一轮增加的访问步骤,可能成为第二轮跨源查询的前置条件;第二轮引入的关系,又可以被第三轮继续使用。执行链条因此逐渐拉长。
为避免把任务改坏,RES 将环境验收与模型难度评估分开。验收时,系统从固定的父环境独立重放声明的变换,并比较重建结果与候选环境是否一致;随后在新会话中沿公开接口检查数据能否被访问和重建,排查事实改动、记录缺失或重复、无效引用、无法终止的前置依赖,以及绕过新结构直接读取原文件的捷径。
检查失败的候选环境会进入修复流程,达到次数上限仍不合格就被丢弃,已经验证的父环境得以保留。模型是否答错则用于后续难度测量和停止决策,并不决定环境本身是否合格。
案例:一项对账任务,工具调用从 3 次增加到 171 次
论文中的财务对账案例,直观展示了环境变化如何影响执行。原始任务要求 Agent 关联 CRM、银行流水和发票记录,找出差异并生成报告。在初始环境中,相关信息位于三份可以直接读取的 CSV 文件里。
经过第一轮扩展,直接读取变成了查询、导出准备和关联视图访问。后续环境继承这些步骤,又加入归档访问、字段结构恢复、索引重建等过程,最终版本还叠加了编码变换。完成对账所需的事实依然存在,Agent 必须先走完更长的证据获取与整理流程,才能进入真正的分析。

在这一案例的原始环境与最终 E3 环境中,DeepSeek-V4.1-Flash 的工具调用量从 3 次增加到 171 次,任务得分从 0.98 降至 0。达到 50 轮交互上限时,模型仍在收集证据,没能完成报告。这里的 171 次是工具调用数,一轮交互可以包含多次调用。
这个案例呈现出一种长程执行中的困难:局部操作能够持续推进,但整个任务仍可能因状态维护、依赖处理和预算消耗而无法按时完成。环境扩展把这些要求集中暴露了出来。
评测:六个模型、三个基准,十八组对比全部变难
研究覆盖了 Claw-Eval-Live 的 105 个任务、Workspace-Bench-Lite 的 100 个任务,以及 Terminal-Bench 2.1 的 89 个任务。研究者冻结构造完成的环境,在一致的配对评测设置下,对六个模型进行测试,每项任务允许一次尝试、最多 50 轮交互。
在 Claw-Eval-Live 上,GPT-5.6 Sol 的成功率由 85.71% 降至 26.67%,下降约 59 个百分点;Claude Opus 5 从 86.67% 降至 28.57%;DeepSeek-V4.1-Flash 从 82.86% 降至 5.71%。六个模型在该基准上的降幅都超过了 57 个百分点。

这一趋势也出现在另外两个基准上。以 GPT-5.6 Sol 为例,Workspace-Bench-Lite 的任务完成率从 61% 降至 49%,Terminal-Bench 2.1 的成功率从 88.76% 降至 44.94%。全部十八组模型与基准组合的任务成功指标均下降,说明环境扩展带来的挑战能够迁移到多个模型,而不只针对构造阶段使用的目标模型。
这些数字衡量的是固定交互预算下的表现。任务仍然通过了环境有效性检查,模型失败意味着它没有在给定预算内完成要求,不能据此认定任务已经无解。
训练:更难的环境能否提供更有用的轨迹
RES 的另一项实验把视角转向了训练。研究者将环境变换应用于训练任务池,收集交互轨迹,再分别对 Qwen3.5 的 4B、9B 和 35B-A3B Base 模型进行监督微调。对照组使用原始环境轨迹,两组都包含 8,428 条轨迹,并采用相同的优化设置。
训练后的模型被放回三个基准的原始测试环境评估。RES 轨迹在全部九组对比中胜出,相对原始轨迹 SFT 的提升为 7.00 至 14.61 个百分点。这意味着,从扩展环境中学到的执行经验,可以在原始任务上体现出收益。
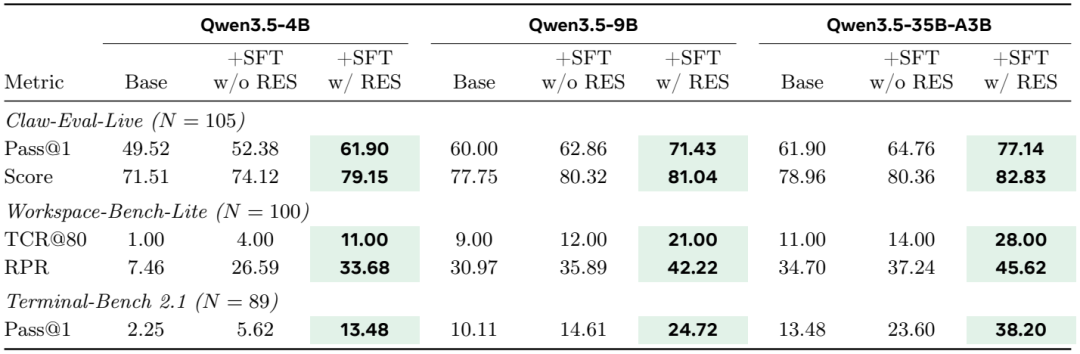
以 35B-A3B 模型为例,Claw-Eval-Live 的成功率从原始轨迹 SFT 的 64.76% 提升到 77.14%;Workspace-Bench-Lite 的任务完成率从 14% 提升到 28%;Terminal-Bench 2.1 的成功率从 23.60% 提升到 38.20%。
消融:递归继承和依赖组合如何影响难度
在一个包含 15 个任务的配对消融子集上,移除保存环境中的依赖结构后,目标模型的成功率由 0 提升到 100%,平均交互轮数由 50 降至 19.1。另一组重建实验中,保留递归继承时成功率为 6.67%,取消继承后则达到 93.33%。这些结果支持了累积依赖在环境难度中的作用;同时,移除依赖也减少了对应的前置工作,不能把差异全部解释为关系结构本身。
写在最后
对于长程 Agent,RES 提供了一种具体的研究方法:在任务目标和完成要求固定的条件下,持续改变获得信息和执行操作的路径,观察模型在哪一段流程中失去进展,再利用这些环境收集训练经验。
目前的证据还不足以建立一条普适的环境 Scaling Law,但已经给出了可操作的方向:让环境成为可构造、可验证、可递归扩展的训练与评测对象。 当任务不再能靠几次直接读取完成,Agent 如何保存中间状态、追踪依赖并走完工作流程,就成为可以被系统研究的能力。
论文及本文图表来源:Jing et al., Recursive Environment Scaling for General Long-Horizon Agents, arXiv:2610.16397, v1, 2026。
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群