【内容目录】
一、英伟达CPO进展
二、AI算力机组交付进度
三、结语
【本文涉及的相关企业】
Nvidia、Broadcom、Marvell、Google、AMD、TSMC、Foxconn、Quanta、Flex、中际旭创、新易盛、沪电股份。
英伟达CPO进展
从物理层与系统互连演进的角度来看,传统可插拔光模块在单通道速率向200G/400G迈进以及单交换机带宽突破100Tbit/s时,面临着极其严峻的信号衰减与功耗瓶颈。作为算力机组硬件龙头的Nvidia推出的Quantum-X与Spectrum-X两款CPO产品,正是针对下一代超大规模AI集群Scale-out网络构建的技术方案。
先来看硬件物理架构分析,这两款CPO交换机在光电物理层高度同源,核心 SerDes 单通道速率均基于 200G 规格,且均采用 200G 单波道微环(Micro-ring)硅光芯片架构来实现光通道调制,但是两者在网络协议栈和带宽配置有所不同,Quantum-X的核心交换速率达到100T/s,支持144 个 800G 端口或 72 个 1.6T 端口(也就是NV72的72路1.6T端口互联)。而Spectrum-X更倾向于以太网的生态,提供100T(128×800G)与 400T(4×128×800G)两种档位,可支持最多 576 个 GPU 的 Scale-out 互连。
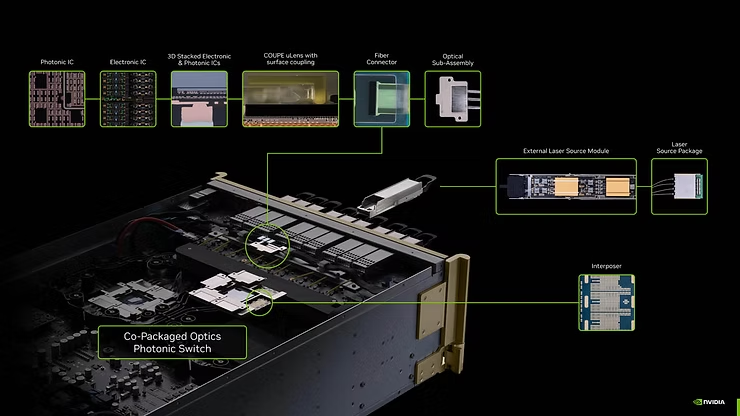
Nvidia的CPO方案(图源:Nvidia)
对于CPO的核心硅光来说,单通道200G/s已经在业界达到商业化量产标准了,但是单波道向 400G 冲刺时受到硅光芯片内部调制器的限制,目前还有待研发。所以Nvidia选择通过横向扩展系统容量,而不是盲目追求单通道速率确实收效巨大。其NV72和NV576及万卡互联方案的产能都早已被预订一空,其系统容量从 100T 向 200T、400T 甚至 800T 也在不断演进。同样对于量产的可靠性来说,Nvidia采用外置激光光源(ELS)与液冷结合的方案,因为激光器对温度极其敏感且易老化失效率高,将 ELS 置于面板侧做成可插拔形态,并配备液冷模块可以控制温度,从而稳定激光器的输出波长,所以微环谐振器的温漂问题得到改善,并显著降低了系统长期功耗。
另一个笔者也是多方了解到,目前市场关注的“量产进展”问题,从封装和测试端信息来看,官方和业界所称的“量产”更贴近于小批量样机交付与早期客户验证阶段,而非成熟的规模化持续大批量出货,并且首期客户也主要集中于CoreWeave、Lambda 以及 Oracle 等服务商,整体预期在1000台左右,目标也是主要集中于万卡集群搭建与前期可行性测试。并且想要大规模量产CPO方案还面临着两大难题需要攻克:
首先是运维服务问题,传统可拔插光模块支持单端口热拔插,而CPO架构中光引擎与 ASIC 高度集成,单一器件的损坏可能让一个价值三十万美元的CPO封装体直接报废,数据中心的运维成本和收支平衡对于投资方来说需要权衡考量。
第二是生态竞争,大型 CSP(如 Meta、微软、AWS)目前在交换网络上高度依赖博通(Broadcom TH5/TH6)方案,且 1.6T 可插拔光模块即将进入大规模集中采购期,并且LPO和LRO的同时发力也在玻璃DSP的基础上进一步降低功耗,极大程度上保留了模块化的运维优势,并且NPO作为兼具的方案,也是收到国内一众厂商的追捧,例如阿里、腾讯、字节都在积极部署NPO(近封装光学)方案。

BROADCOM的CPO方案(图源:BROADCOM)
AI算力机组交付进度
同样笔者也从一线了解到,目前AI 算力基础设施的部署正在经历从“芯片级”向“机柜级(Rack-level)”复杂系统集成的跨越,例如Blackwell(GB200/GB300)与 Rubin(Vera Rubin NVL72/CPX/LPU)系列产品,市场预期不断走低。2026年初市场乐观预期下半年 NVL72 的需求量可达 1.5 万柜,但最新的产业链数据表明预期大幅下修至7000左右。预期降低的核心大体来自于两方面因素:
1量产进度和量产良率问题:据富士康、广达和伟创力等ODM厂商的良率来看,其整机全线良率在70%左右,显著低于标准通用服务器的产线良率95%,也低于上一代A100/H100 的传统 GPU 服务器良率85%。对于包含了多组Compute Tray、NVLink Switch Tray、复杂液冷管路的复杂机柜产品来说,元器件数量翻倍带来的信号干扰和串扰问题、液冷微渗漏等各种问题都亟需解决。
1存储和零部件成本飙升问题:不光是AI服务器行业,整个电子行业都受到元器件涨价影响,HBM3/3e、HBM4、大容量DDR5以及NAND的价格持续飙升,市场上单条64G DDR5价格翻了五倍不止,并且价格趋势还将进一步走高,经过行业测算单台服务器内存储的总价格甚至超越了 GPU 芯片本身,整机的BOM成本高企。
同时在统计北美大型CSP厂商端的订单时,笔者也看到对于2027年展望,诸如AWS、Google、Microsoft、Meta、Oracle、OpenAI等巨头其订单都瞄准了Rubin NVL72系列,并且预估Rubin 平台总体体量约 7 万柜,并且绝大多数的订单都将交由拥有系统工程验证能力的台系 ODM厂商。另一方面由于政策导向,对于AI主权和地域性政策,部分国内算力厂商订单开始瞄向华为、HPE、戴尔、中科曙光等标准服务器机组厂商,尤其GB系列中,2026 年初占比 5% 快速攀升至 GB300 阶段的 20%–25%,并在 Rubin 系列中达到 30%–35%。
同时根据媒体报道称,目前运营商的算力机组和国家级项目的新建机房背后拥有着巨额的产业基金做靠山,区别于CSP厂商这种商业实体,不受严格的资本开支与 ROI 约束。(CSP资本回报要求,按AI 算力资产按 5 年折旧,每年摊销约 20%,商业回报的兑现周期将达到8年左右,并且伴随竞争可能进一步放缓)相比之下,主权 AI 资金不受短期财务回报约束,且其算力使用也较为灵活,后期转为科研或者教学用途,所以更倾向于高算力的Rubin平台,所以目前在该系列的出货量需求很大一部分原因是这类主权AI的资金。
中科曙光无线缆箱式超节点(图源:中科曙光)
结语
AI算力竞争已触达下半场了,CPO技术确实领先,但是量产从来都是一个工程问题,成本和资本回报是一种CSP厂商首先要面临的问题,所以可拔插光模块和NPO作为先行者注定还有很大发展空间。对于交货量和周期,目前的良率确实是一大瓶颈,并且主权AI和政府引导资金将作为接力棒继续推动行业的快速发展。
文中插图为生成式AI生成