作者:Nithya Rao,英特尔公司系统与软件优化工程师
英特尔® 至强® 6处理器带来更高的智能体AI吞吐量,助力系统在复杂的智能体工作流中完成更多任务。
智能体AI的兴起改变了过去AI应用相对简单的交互模式:用户提交AI提示词,模型生成响应,交互结束。在这一模式下,围绕AI基础设施的讨论主要聚焦于模型质量、加速器性能和推理时延。
如今,现代AI系统日益需要具备推理、规划、信息检索、工具调用、动作执行、结果验证以及迭代优化自身行为的能力。用户看似只发起了一次交互,但在最终结果呈现前,系统可能触发跨越多个软件组件的数十项独立任务。
企业不再只关注时延,而是越来越重视一个更实际的问题:系统在一定时间内能完成多少有效工作?在诸多智能体部署中,吞吐量正成为最终决定系统生产效率的关键指标。

智能体AI带来新的基础设施挑战
传统AI应用通常遵循简单的执行流程:输入提示词、调用模型、生成响应。智能体AI则引入了规划、工具选择、执行、验证和迭代等环节。
因此,现代智能体AI工作负载在整个系统栈中产生的活动,远多于传统推理工作负载。在部署编程智能体、企业级copilot、研究助手、运营自动化系统和AI驱动的业务工作流时,企业发现,制约整体效率的并非模型生成速度,而是任务编排、工具执行、内存访问、存储操作和运行时管理等环节。

英特尔® 至强® 处理器为什么适合智能体AI
一个常见误解是,智能体AI的性能可以只通过模型推理速度来衡量。强大的CPU性能仍是推理、工具执行、任务编排和安全操作的基础,与此同时,智能体工作负载也对内存、存储和I/O资源提出了极高要求。
与传统AI应用不同,智能体需要在多个执行阶段,保留对话历史、执行上下文、检索到的知识、中间输出和工作流状态。同时,它们还要频繁调用工具、访问数据源、启动子进程并协调从属任务。因此,系统整体性能不仅取决于计算能力,还取决于平台在工作流各阶段高效推动任务流转的能力。
企业规模的智能体部署具有高并发、高内存占用、大量任务编排需求以及持续执行异构任务等特点。内置加速功能的英特尔至强处理器将强劲的计算性能,与大容量内存、高内存带宽和出色的I/O能力相结合,高效应对多样化工作负载需求。
当企业将部署规模从单个智能体扩展到数千个并发工作流,平台效率对整体生产力的影响日益突出。那些能够在计算、内存、存储和任务编排资源之间实现均衡配置,最大限度减少瓶颈,并在持续高负载下稳定运行的平台,才能实现高吞吐量。英特尔至强处理器能够很好地满足现代智能体AI部署的需求。

构建可重复执行的智能体AI基准测试
智能体AI基准测试面临的一项挑战是,真实环境中的智能体行为本质上是动态的。不同的提示词可能会产生不同的执行路径和工具选择。
为解决这一问题,测试采用了录制与回放方法。在录制阶段,系统运行有代表性的智能体工作流,记录其任务构成和执行特征。在回放阶段,各个平台处理完全相同的工作负载执行轨迹,确保观测到的性能差异源于基础设施本身,而非应用层面的随机性。

通过真实工作流评估智能体AI
为了解平台能力如何转化为真实场景中的智能体性能,我们在基于英特尔至强6处理器、同类产品A以及同类产品B的实例上,使用同一套确定性Terminal-Bench工作负载进行了评估。该基准测试包含一组代表性的智能体任务,在60分钟评估窗口内以24路并发执行。所有平台的代码、输入和智能体执行轨迹完全一致。
为评估平台在不同真实部署场景中的表现,我们选取了三个代表性的行业领域:医疗健康、银行与金融服务以及制造业。尽管各行业的具体应用工作流有所不同,但它们都体现了智能体AI工作负载的共同特征,包括推理、检索、分析、文档处理和任务编排。

医疗健康领域的智能体AI
医疗健康基准测试涵盖临床文档记录、证据检索、诊断分析、欺诈检测、风险评估、分子研究、基因组分析和实验室诊断等代表性智能体工作流。

图1.医疗健康领域的代表性智能体任务
如图2所示,在60分钟的评估中,基于英特尔至强6处理器的实例取得了更高的标准化智能体任务吞吐量,达到同类产品A实例的1.66倍、同类产品B实例的4.5倍。更高的吞吐量意味着,企业能够在相同基础设施上支持更多并发智能体工作流,提升整体生产效率,加快大规模智能体任务的完成速度。

图2.在医疗健康任务中,基于英特尔至强6处理器实例的智能体吞吐量最高可达同类产品A实例的1.66倍,以及同类产品B实例的4.5倍。
英特尔至强6处理器的吞吐量优势并非由单一工作负载类型驱动,它在推理、安全和控制操作中均实现了更高的任务完成率,加快真实医疗健康智能体工作流的端到端执行。
如图3所示,在所有受测工作负载类别中,基于英特尔至强6处理器的实例均取得了更高的标准化吞吐量。与同类产品A实例相比,英特尔至强6在分析与推理工作负载中的吞吐量达到其1.67倍,在安全数据处理工作负载中达到1.63倍,在控制类工作负载中达到1.61倍。与同类产品B实例相比,上述吞吐量分别达到4.67倍、4倍和4.14倍。这一稳定的性能优势有助于企业支持更多并发AI智能体工作流,提高基础设施利用率,更快完成智能体驱动的工作。

图3.在同一轮60分钟测试中,基于英特尔至强6处理器的实例在推理、安全和控制操作中完成的医疗健康任务多于同类产品A和同类产品B实例。

银行与金融服务领域的智能体AI
银行与金融服务基准测试涵盖了信贷、风险分析、投资研究、交易分析、欺诈检测、合规和监管报告等代表性智能体工作流。

图4.银行与金融服务领域的代表性智能体任务
如图5所示,基于英特尔至强6处理器的实例取得了更高的标准化智能体任务吞吐量,达到同类产品A实例的1.64倍,以及同类产品B实例的4.57倍。更高的吞吐量让金融机构在相同的基础设施规模下支持更多并发智能体驱动的工作负载,包括风险分析、文档处理、合规操作和面向客户的服务。

图5.在银行业务任务中,基于英特尔至强6处理器的实例智能体吞吐量最高可达同类产品A实例的1.64倍,以及同类产品B实例的4.57倍。
如图6所示,在所有受测工作负载类别中,基于英特尔至强6处理器的实例均取得了更高的标准化吞吐量。与同类产品A实例相比,英特尔至强6在分析与推理工作负载中的吞吐量达到其1.66倍,在安全数据处理工作负载中达到1.61倍,在控制类工作负载中达到1.59倍。与同类产品B实例相比,英特尔至强6的上述吞吐量分别达到4.84倍、3.95倍和3.91倍。这一稳定的性能优势有助于避免AI智能体工作流关键环节出现瓶颈,让金融机构能够在既定的基础设施规模下处理更多智能体驱动的工作。

图6.在同一轮60分钟测试中,基于英特尔至强6处理器的实例在推理、安全和控制操作中完成的银行与金融服务(FSI)任务多于同类产品A和同类产品B实例。

制造业领域的智能体AI
制造业基准测试涵盖了预测性维护、质量检测、供应链优化、生产规划、工厂运营、工业安全和流程优化等代表性智能体工作流。
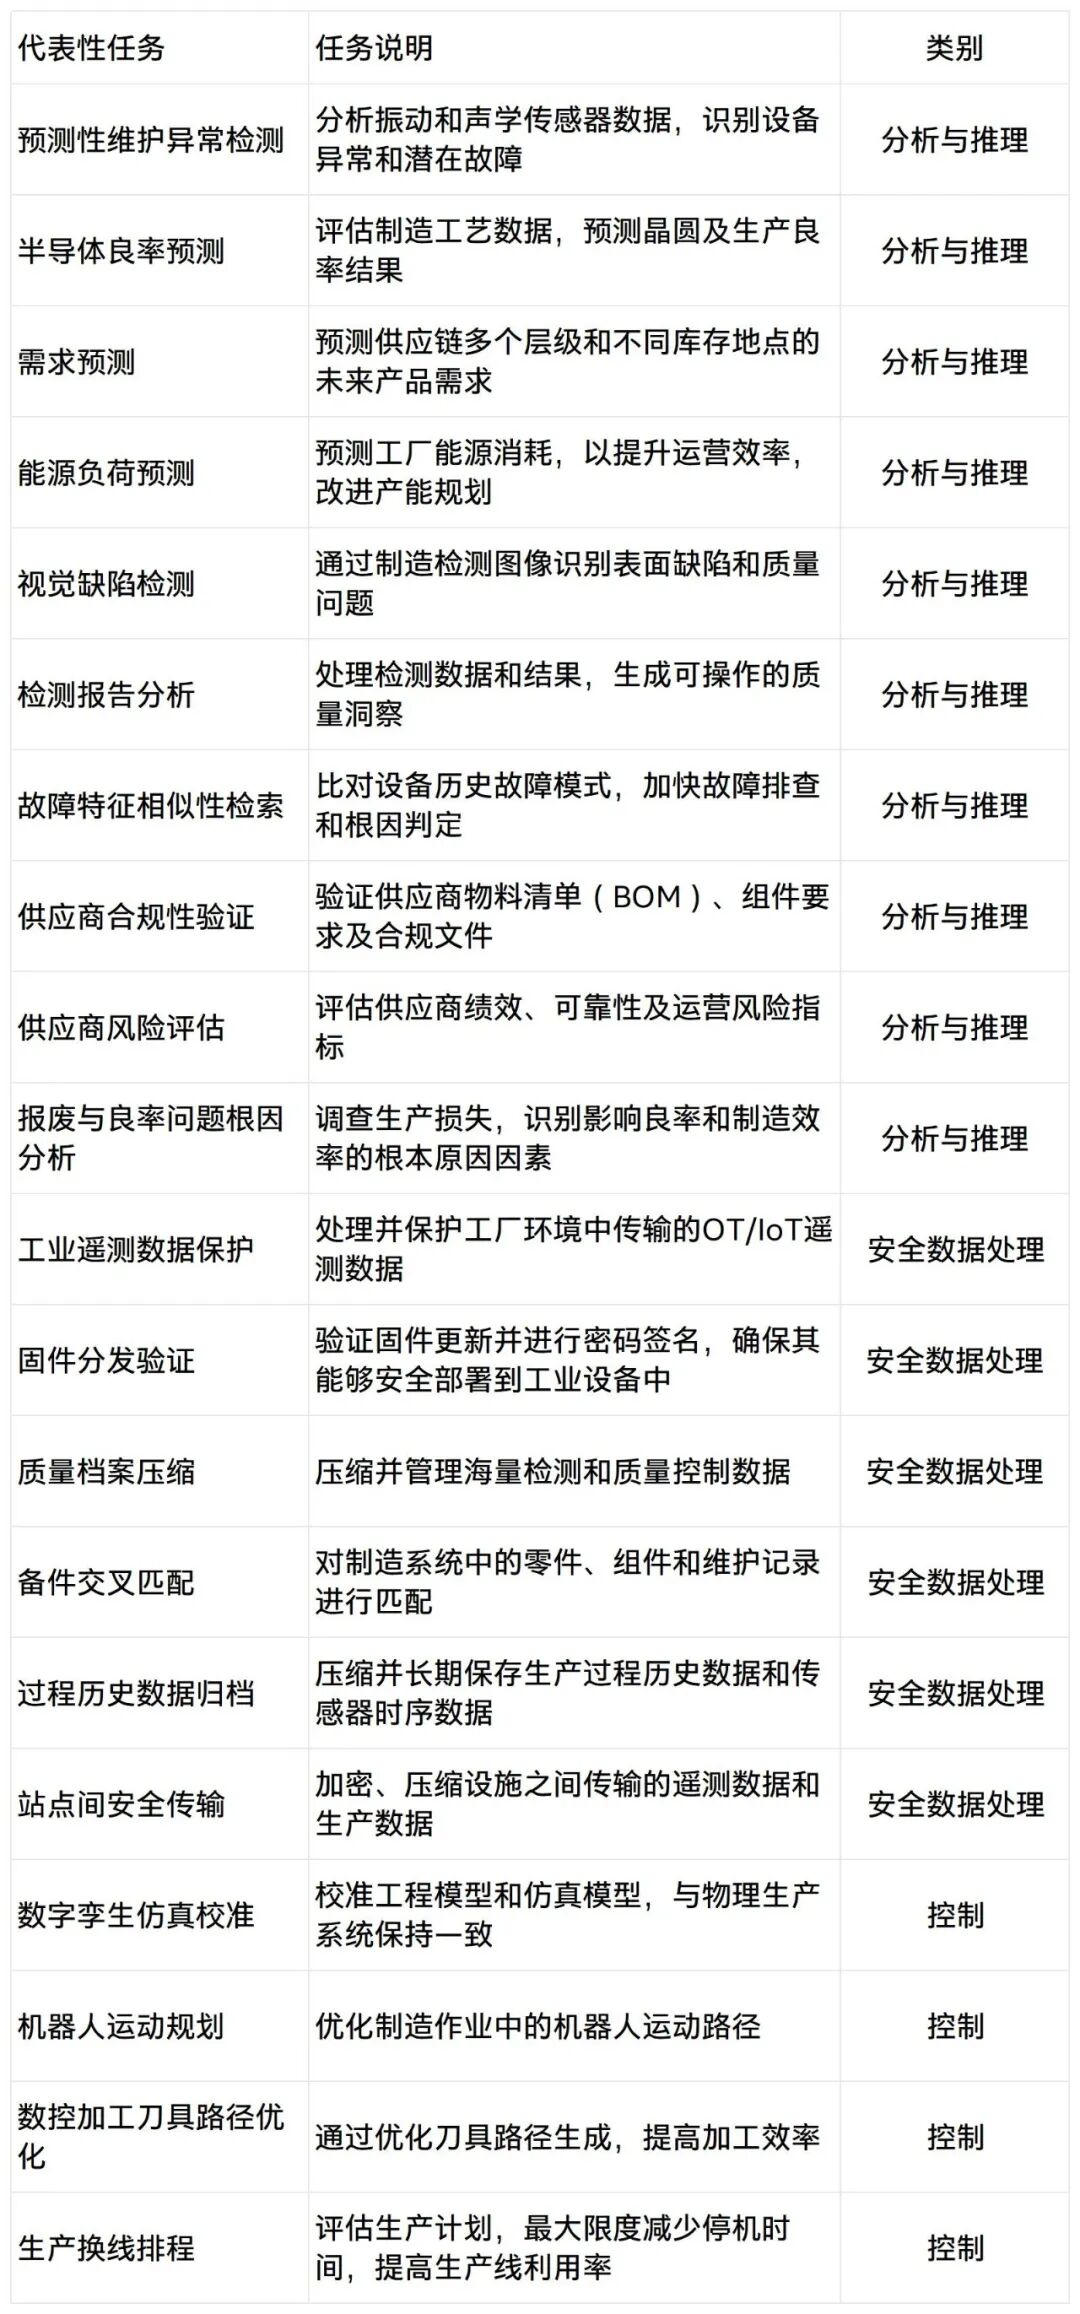
图7.制造业领域的代表性智能体任务
如图8所示,基于英特尔至强6处理器的实例取得了更高的标准化智能体任务吞吐量,达到同类产品A实例的1.58倍,以及同类产品B实例的4.24倍。这一吞吐量优势,让制造企业能够在每台服务器上支持更多并发智能体驱动的工作流,并在相同基础设施规模下,加速预测性维护、质量检测、良率分析、供应商管理和生产优化等任务。

图8.在制造业任务中,基于英特尔至强6处理器实例的智能体吞吐量最高可达同类产品A实例的1.58倍,以及同类产品B实例的4.24倍。
如图9所示,在所有受测工作负载类别中,基于英特尔至强6处理器的实例均取得了更高的标准化吞吐量。与同类产品A实例相比,英特尔至强6在分析与推理工作负载中的吞吐量达到其1.59倍,在安全数据处理工作负载中达到1.55倍,在控制类工作负载中达到1.55倍。与同类产品B实例相比,上述吞吐量分别达到4.48倍、3.78倍和3.78倍。这一持续的性能优势,有助于为端到端制造智能体工作流的各个环节,从生产分析、质量检测到工厂运营和流程控制,提供稳定的吞吐量和响应能力。

图9.在同一轮60分钟测试中,基于英特尔至强6处理器的实例在推理、安全和控制操作中完成的制造业任务多于同类产品A和同类产品B实例。

为什么吞吐量至关重要
智能体AI使性能评估不再局限于单项操作,而是转向完整工作流的执行。真正重要的是,平台能否高效执行任务、调用工具、处理数据、管理状态、验证输出、协调存在依赖关系的操作,并在持续负载下保持生产效率。最有价值的平台,应当在保持高效、响应灵敏和可扩展的同时,持续承载、流转最大量的工作任务。

总结
企业部署的智能体数量与日俱增,工作流也日趋复杂,高吞吐量成为决定运营效率的关键因素。这些测试结果表明,基于英特尔至强6处理器的实例能够为智能体AI提供坚实的基础,在医疗健康、制造业和金融服务等真实场景工作流中实现更高吞吐量,让企业在同一套基础设施上处理更多智能体驱动的任务。
向上滑动阅览
©英特尔公司,英特尔、英特尔logo及其它英特尔标识,是英特尔公司或其分支机构的商标。文中涉及的其它名称及品牌属于各自所有者资产。
相关资讯
/转载请注明出处/