一个 100 克的小方块,以每秒 1 米的速度在桌面上滑出去,滑了 12 厘米多停下。同一个场景放进四个仿真器,算出来的停止位置最多只差 0.05 毫米,差不多一根头发丝粗。

可刚滑出去的那一下,方块受到的力相差很大。两个仿真器算出来,桌面给方块的力最大有 10.5 牛,是方块自重的十倍多;另外两个只有 1 到 1.5 牛。机器人抓东西、推东西,靠的就是这一路上的力,力算得不一样,抓不抓得稳、会不会把东西推飞,结论都可能跟着变。
训机器人,现在几乎绕不开仿真:策略先在仿真里练、在仿真里考,考过了再上真机。可选哪个仿真器,很多人凭的是习惯,或者手头那份教程用的是哪个,很少有人把同一个任务放进几个仿真器认真比一遍。

同一个任务:左边是S0-101在仿真里的策略推理录像,右边是真机录像(4倍速)(我们的实验录像)
做机器人训练与评测基础设施的团队 Manda Robotics,十月初发了一份长报告,把几个主流仿真器放在一起比了一遍:同一台 Franka 七轴机械臂、同一套控制程序,放进四个物理引擎里跑,从方块滑行一路做到插销装配和抓软球,一共十来组实验。上面那个方块,是其中最简单的一组。
我把报告和作者配套写的那篇入门文章读了一遍,又对了对我们自己给开源桌面机械臂 SO-101 做仿真数据时踩过的坑。我的判断是,只看结果成没成,比如方块推没推过去、叠上去倒没倒,四个仿真器的答案大体一致;要是看过程,比如方块一路上受了多大的力、走了哪条路,四个仿真器算出来的彼此对不上;碰上软的东西,连结果都对不上。所以挑仿真器,先得想清楚你要看的是结果,还是过程。
01|仿真器里装着什么?
平时说的“仿真器”,其实是三样东西叠在一起。最外层是框架,比如英伟达的 Isaac Lab、机器人圈用了很多年的 Gazebo,负责加载机器人和场景、跑任务;中间是物理引擎,算东西怎么动、怎么撞;还有一个渲染器,负责生成相机画面。

渲染和物理由两个部件分别负责,所以画面逼真不代表物理算得对,一个场景完全可以看着像真的、动起来却不像。不少框架还能换引擎,Isaac Lab 默认用英伟达自己的引擎 PhysX,也能接新的开源引擎 Newton。

物理引擎是把时间切成很短的一小段一小段往前算的。每一小段时间里,它都按顺序做同样四件事:先找出哪些东西碰上了,给每一处接触算一个力,再把所有接触力和关节力一起解出来,最后把每个物体的位置和速度更新到这一小段时间结束的时刻。这一小段时间叫步长,机械臂仿真里通常取 1 毫秒,一秒钟的动作要把这四件事重复一千次。

各家分歧最大的,是「接触」这一环。按报告里的设置,PhysX 把接触当成刚性约束来算,两个物体不许互相穿进去(PhysX 本身也支持带弹性的柔性接触,报告没有打开);MuJoCo 用的是软接触,允许挤进去一点点,像中间垫了一层很硬的弹簧,挤得越深,推回来的力越大。Genesis 算刚体时,用的也是和 MuJoCo 类似的软接触。

报告比的四个引擎,正好三软一硬。MuJoCo 是 Google DeepMind 维护的老牌引擎,跑在 CPU 上;MuJoCo Warp 是 MuJoCo 的 GPU 版,DeepMind 和英伟达一起开发,报告里是通过 Newton 调用的;Genesis 也跑在 GPU 上;PhysX 跑在英伟达的仿真平台 Isaac Sim 里,刚体实验用的是 CPU 版,软体实验用的是 GPU 版。

两个GPU引擎的官方演示(图源:MuJoCo Warp、Genesis的GitHub项目页)
三个软接触引擎算法相近,结果接近是意料之中;PhysX 是唯一用硬接触的,它和另外三个对不对得上,最能说明问题。
我们在《Xbotics 具身智能教程(21 讲)》第 5 讲讲仿真时,列过一张平台表:轻量调试看 MuJoCo,接机器人操作系统 ROS 做系统联调看 Gazebo,GPU 大规模并行看 Isaac Lab 和 Genesis。表下面我们加了一句提醒:脱离硬件、模型和求解器设置的性能数字,不能当成通用结论。
Manda Robotics 这份报告,是先把这些条件统一了再比的。同一份机器人模型,导入每个引擎之后,逐项核对质量和惯量,也核对关节轴和碰撞形状;同一个控制器,绕开各家自带的关节驱动,直接算好力矩发下去。这份报告也有边界:比的是引擎和引擎,没有拿真机做对照。四个引擎答案一样,只能说明它们彼此一致,说明不了谁更接近真实世界。
02|只问成没成,四个仿真器几乎没有分歧
刚体任务里,只看结果成没成,四个引擎几乎每次都给出同一个答案。
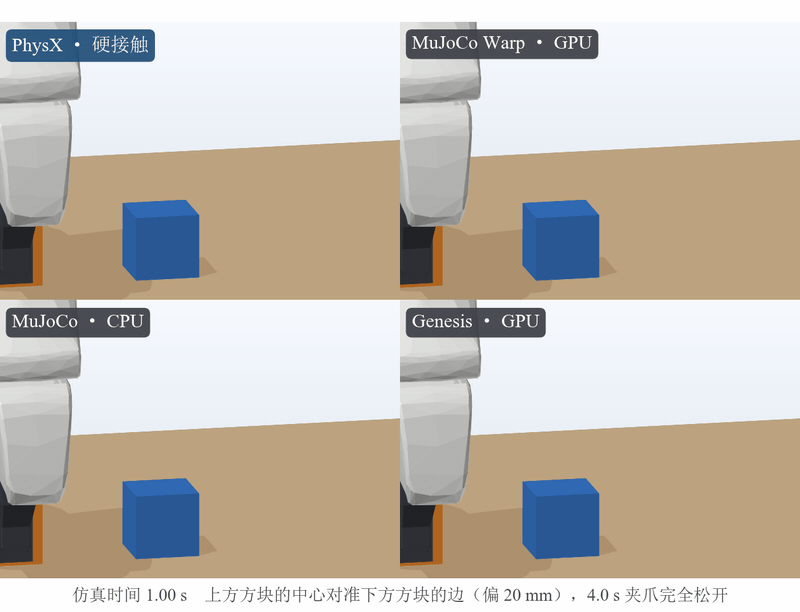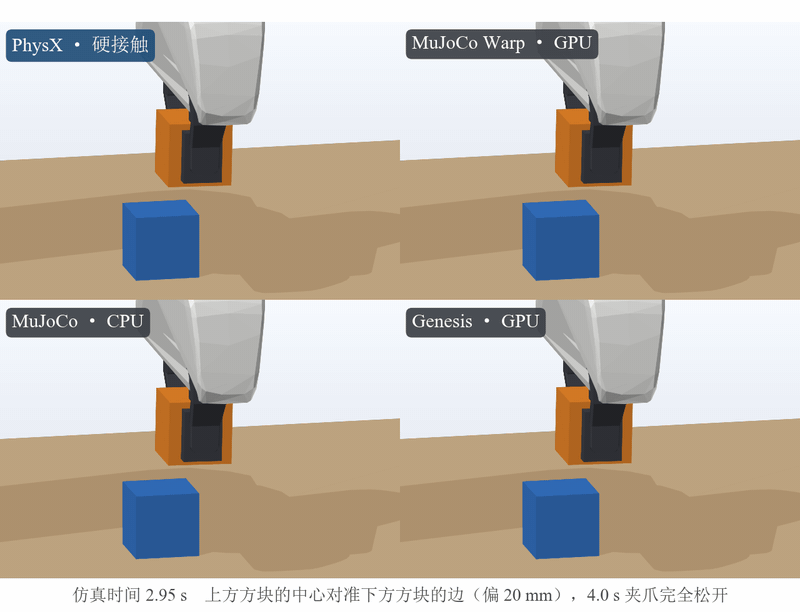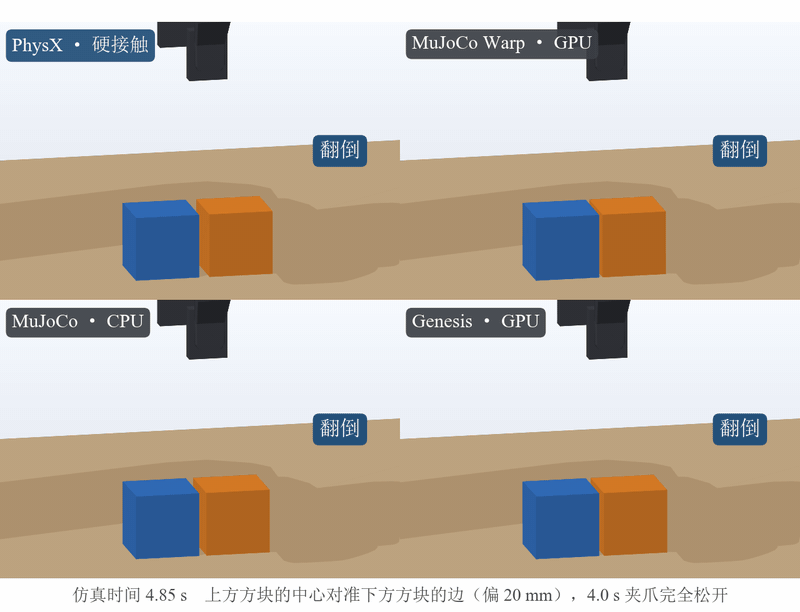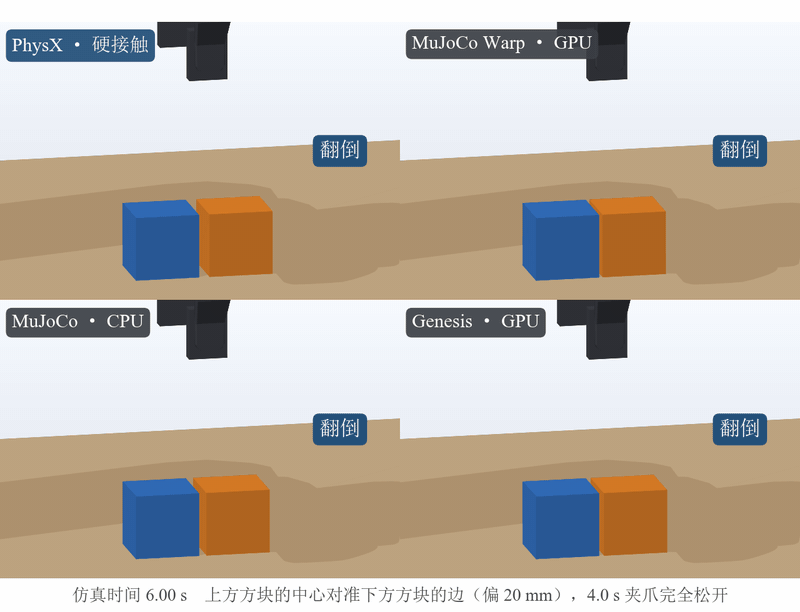
上方方块往外偏20毫米:四个引擎里,松手之后都翻了下去(根MandaRobotics公开的仿真轨迹重绘)
最直观的是叠方块。机械臂夹起一个 4 厘米见方的方块,挪到另一块同样大小的方块上方,松手,看上面那块倒不倒。放正了、往外偏 16 毫米,四个引擎里都稳稳立着;偏到 20 毫米,也就是上面那块的中心正好对着下面那块的边,四个引擎里都翻了下去,偏 22 毫米也一样。

抓起再放下、推三个方块穿过两堵墙之间的通道,结论同样一致。通道留 90 毫米,四个引擎都推过去了;收窄到 80 毫米,四个都卡住。机械臂在空中自由运动时,手爪走了约 19 厘米,四个引擎的轨迹相差不到 0.2 毫米。

推三个方块穿过90毫米宽的通道:四个引擎都推过去了,一路上方块的姿态各不相同(根据Manda Robotics 公开的仿真轨迹重绘)
这是个好消息:只要把模型核对清楚,拿仿真回答“这个动作能不能成”,换哪个引擎,给出的成败判断都基本一致。
03|问过程,四个仿真器就对不上了
一旦看过程,比如受了多大的力、走了哪条路,四个引擎算出来的就各不相同;碰上间隙很小的装配,接触的算法不同,连成败都会跟着不同。
先看一个方块从 33 厘米高处掉到桌上。PhysX 用硬接触,方块几乎瞬间停住,接触那一下的力峰值是 254 牛;三个软接触引擎让方块往桌面里陷了 7.6 到 7.8 毫米,再被推回来,峰值只有 52 到 53 牛。最后方块都静静停在桌上。

分歧最大的是插销。机械臂把一根直径 20 毫米的销子插进孔里,孔和销子之间每边只留 0.1 毫米的缝,销子还歪了 1 度,目标是插进去 19 毫米以上。三个软接触引擎里,销子都插到 15.5 毫米左右就卡住了;PhysX 里,接触力一路冲过 40 牛的安全线,实验被强行叫停。

作者又给控制器加了一点“手感”,让它根据销子受到的接触力微调动作:销子侧面受了力,就顺着受力方向把位置挪一点,必要时稍微往上退;销子被孔别住、受到扭转的力,就把销子的角度往回正一点。四个引擎用同一组参数。加上之后,三个软接触引擎里销子都插到了位;PhysX 里重复跑了三次,三次都超限停机。

同一个装配策略,放在 MuJoCo 里评测会判成功,放在 PhysX 里会判失败,分数有一部分取决于引擎的接触算法。哪个更接近真实的钢件装配,报告没有拿真机比,回答不了。作者自己也写明,真实的钢对钢装配,摩擦力可以超过 60 牛,这组实验的力上限设得温和得多;PhysX 在销子完全对正的情况下还算出过 485 牛的力,作者把这个结果记为没查清的仿真异常。
04|软的东西,各说各话
换成软物体,四个引擎连结果成没成都对不上;把网格加密、把步长调小之后,各家的结果也没有变得一致。
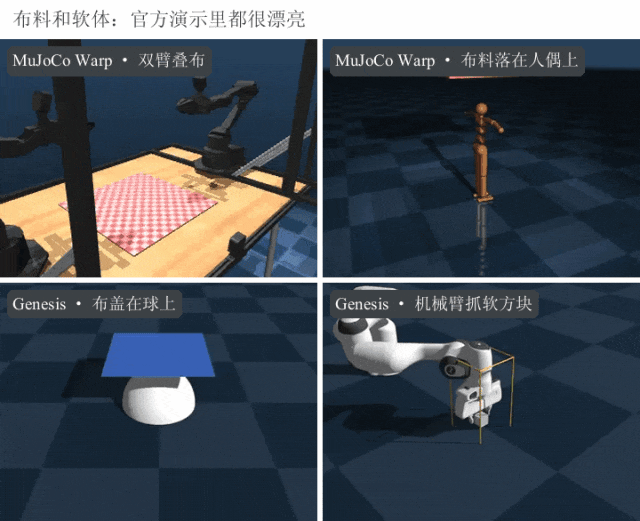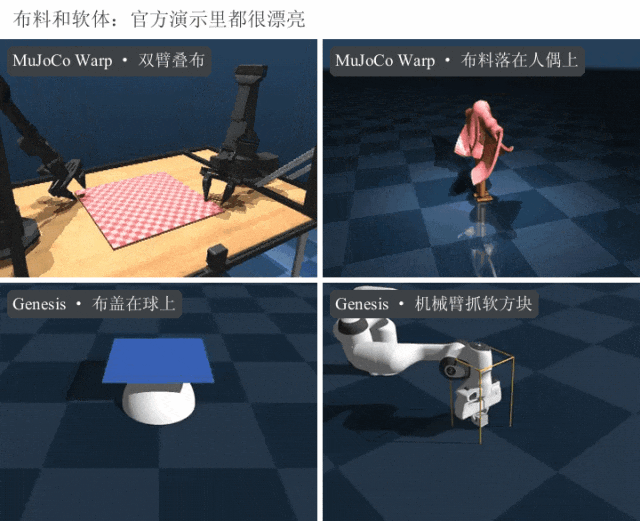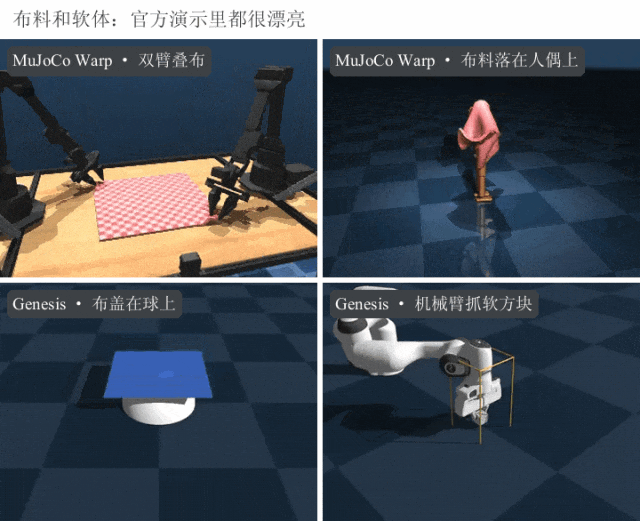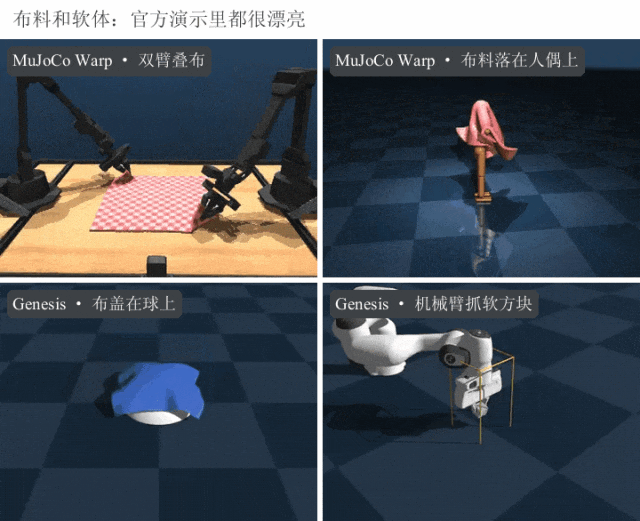
布料和软体的官方演示(图源:MuJoCoWarp、Genesis 的 GitHub 项目页)
布料和软体,各家的官方演示都做得很漂亮,不过每段演示只在自家引擎里跑。
这组实验把同一个任务交给了不同的引擎:机械臂两根手指夹住一个直径 6 厘米的软球,抬起 8 厘米,停一会儿,再放下松手。每种跑法拿到的是同一个球:同样的软硬(杨氏模量 20 千帕)、同样的摩擦、同样由 384 个小四面体拼成的网格,每根手指的力上限都是 2 牛。
软体这一组有五种跑法:MuJoCo Warp 除了自己直接算,还多了一种组合,经 Newton 调用,软球改用另一套算法(VBD)来算。

同一个软球、同一套动作,五种跑法五种结局(根据MandaRobotics公开的仿真轨迹重绘)
结果五花八门。CPU 上的 MuJoCo 把球抬起约 66 毫米,从夹起到松手全部做完。MuJoCo 的 GPU 版也抬起来了,可放下的时候网格里有四面体被挤得翻了面,仿真算不下去。Genesis 的仿真一直算到了最后,没有出错,球却始终没被抬起来。PhysX 还没把球抬起来,网格里就出现了翻面的四面体,作者标明这是自己的配置没调通,不能拿来判断 PhysX 的本事。Newton 的组合抬起约 69 毫米,也完成了全部动作。

会不会是网格太粗、步长太大?作者把四面体从 384 个加密到 3072 个,步长减半、再减半,五种跑法一共做了 25 组对照。CPU 版 MuJoCo 每次都能抓住;GPU 版每次都在放下时出错;Genesis 换了细网格,反而在抬起阶段就出错。网格和步长都调细之后,五种跑法的结果还是各不相同。
五种跑法为什么对不上,报告没有归到某一个原因上。名义参数虽然填得一样,各家实际算的并不完全是同一个模型。一是材料的算法不同,Genesis 还重新划分了球的网格;二是机械臂和软球之间传力的方式不同,MuJoCo 和 PhysX 把机械臂和软球放在同一个引擎里一起算,Genesis 和 Newton 是两个求解器各算各的,再通过一个耦合器互相传力,Newton 那边传回来的力还要晚一步。可就连 MuJoCo 的 CPU 版和 GPU 版,模型和网格完全相同,结局也不一样。报告最后的结论是:材料参数填成一样,抓取的结果并不会跟着一样。
软的东西在仿真里算不准,我们自己也撞上过。我们用 SO-101 夹一块海绵方块,真机上海绵被夹扁了 4.7 毫米,仿真里的海绵是刚体,一点不变形。把同一串真机动作喂给仿真,五个臂关节对得上,95% 的时刻误差不超过 3.1 度;夹爪那一列的偏差却到了行程的 16%,偏差集中在夹紧海绵的那一段。
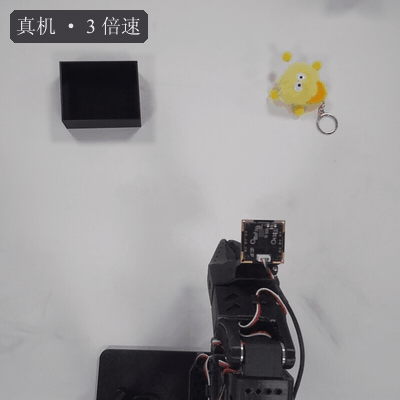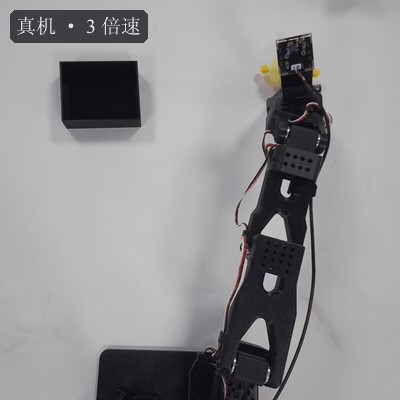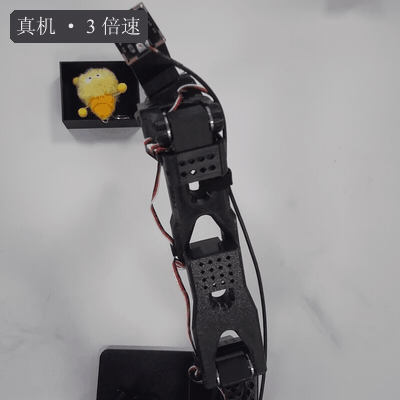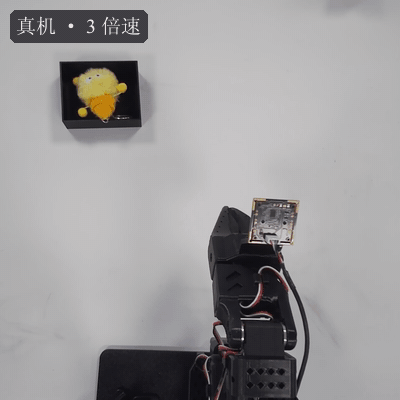
S0-101真机抓毛绒玩具(3倍速):软的东西一夹就变形(我们的实验录像)
如果你的任务里有布料和海绵,或者要抓食物、线缆,先在你用的每一个引擎里把软物体单独验证一遍,比如不带机械臂,只拿两块板压一压,看变形和受力对不对,再去信仿真器给出的成功率。
05|那到底怎么挑?
我的建议有三条。调单个场景用 CPU 上的 MuJoCo,大批量训练上 GPU;不管用哪个,结果对不上时先查模型导入和默认参数,确认没问题了,再怀疑是不是引擎本身的算法不同;凡是跟力和接触有关的结论,换一个引擎再跑一遍。

第一条,用 CPU 还是用 GPU,要看速度。
只跑一个环境,CPU 上的 MuJoCo 每秒能算约 16.7 万步,GPU 上的 MuJoCo Warp 只有约 5700 步,Genesis 约 1900 步。一个小场景喂不饱 GPU,每一步启动计算的开销占了大头。同时跑 8192 个环境,局面就反过来:MuJoCo Warp 每秒合计 2160 万步,Genesis 1180 万步。

我们用仿真框架 ManiSkill 搭 SO-101 仿真时测到过一样的现象。ManiSkill 底层也是 PhysX,只跑一个环境时,控制程序每走一步,GPU 版要算 48 毫秒,CPU 版只要 3.2 毫秒;GPU 版多开几个进程并行,总速度也只涨到单进程的两倍左右,开到 8 个就不再涨了。GPU 引擎是为成百上千个环境一起算设计的,只喂一个环境,反而慢。
第二条,结果对不上,先查设置。
报告里好几处看上去是引擎之间的差别,查到最后都是设置问题。有一根挂在铰链上来回摆的连杆,Genesis 摆得明显比别家慢,1 秒内和理论解最多差了 51 度;原因是导入模型时,关节被悄悄加上了 0.1 kg·m² 的附加转动惯量,模型文件里写的明明是 0。显式改回 0 之后,Genesis 和 MuJoCo 一致到了浮点精度。
连步长都比引擎影响大:步长减半,滑块的停止位置挪了 0.5 毫米,是换引擎带来差别的十倍。
我们自己吃过的最大一次亏,最后也查到了设置上。同一串抓取动作,在 GPU 版 PhysX 上能把方块抬起来放进盒子;换到 CPU 版,夹爪一合拢就把方块弹出去 27.6 毫米,8 次全部失败。
两边 27 项求解器和材质参数逐项一样,最后查出来是一个默认值:ManiSkill 默认物体相距 20 毫米以内就开始生成接触,可夹爪两指的净空只有 3.5 毫米,接触范围比空隙宽了近 6 倍,两种实现在合拢那一下的细微差别被放大成了完全相反的结果。改成 5 毫米之后,8 次里有 7 次,两个版本抬起的最高点只差 0.1 到 1.9 毫米。

同一串抓取动作:默认接触距离20毫米时,GPU版把方块放进了盒子,CPU版把方块推开了;改成5毫米后两边都放了进去(我们用ManiSkill搭的S0-101仿真录像)
第三条最省钱:评测时换一个引擎再跑一遍。
报告里分歧最大的几处,也是策略最容易出事的地方:挤满东西的场景和间隙很小的装配,还有软的物体。第二个引擎给的分数和第一个相差很多时,先别急着说策略不行,回头查场景和设置。
顺便测一下同一个引擎自己的波动。有一组实验让机械臂用推板把 15 个物体推进托盘,同样的输入在 GPU 版 MuJoCo Warp 上跑三次,分别推进去 11 个、8 个、7 个,同一个引擎自己的波动,和换引擎的差别差不多大。CPU 版 MuJoCo 和 PhysX 三次都一模一样。
结语
这份报告最大的缺口,作者在报告开头就写明了:没有拿真机做对照。四个引擎一致,只说明它们彼此一致。大多数配置也只跑了一次;有些场景是先在 CPU 版 MuJoCo 上搭好的,任务的挑法天然偏向 MuJoCo 熟悉的设置。
不过这份报告已经能说明,仿真里报出来的成功率,有一部分是由所用的引擎决定的。我觉得以后报仿真成绩,应该像报数据集一样,写清楚用的哪个引擎、哪个版本、步长多少。
Manda Robotics 在报告里预告,这个系列还有两篇:下一篇把在一个引擎里训好的策略拿到别的引擎里考,再下一篇才上真机。我最想看的是真机那一篇:两个仿真器都点头的结论,真机会不会也点头。
-END-
点击下方卡片,关注【Xbotics具身智能实验室】
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀