导读:只需几秒参考音频,现代语音克隆模型就能合成与目标说话人高度相似的语音。但真实部署中的参考录音往往带有噪声,文本可能异常、超长或跨语言,生成的语音还要经过压缩和电话传输,有人甚至会给自己的声音加上「防克隆」保护。在这些条件下,模型还能保持内容、身份和自然度吗?来自英属哥伦比亚大学(UBC)与 Vector Institute 的研究团队提出 RVCBench,把语音克隆的鲁棒性拆成输入、生成、输出和音频扰动四个环节,用 18 项评测、10 类任务系统检验 18 个代表性开源模型,并将基准升级为可直接 pip 安装的通用语音克隆评测工具包。该工作已被 NeurIPS 2026 接收。

论文标题:RVCBench: Benchmarking the Robustness of Voice Cloning Across Modern Audio Generation Models
会议:NeurIPS 2026
论文链接:https://arxiv.org/abs/2602.00443
代码链接:https://github.com/Nanboy-Ronan/RVCBench(PyPI:rvcbench)
项目主页:https://nanboy-ronan.github.io/RVCBench/
背景:当语音克隆走出实验室
语音克隆,也被称为零样本语音合成(zero-shot TTS)或说话人条件语音合成,目标是只凭几秒参考音频,就生成与目标说话人音色相近的任意内容语音。过去两年,以自回归编解码 token 语言模型和扩散 / 流匹配模型为代表的新一代方法快速发展,在干净测试集上的相似度和自然度已经相当惊人,个性化语音助手、影视配音等应用也随之落地。
但「在测试集上表现好」与「在真实场景中可靠」是两回事。真实部署中,模型会不可避免地遇到这样一些情况:
参考录音来自嘈杂环境,或混入了其他说话人的声音;
输入文本带有异常格式、幻觉式内容,甚至是诈骗类话术;
需要生成很长的段落,或跨语言克隆;
生成的语音还要经过 MP3 / AAC / Opus 压缩,或通过窄带电话传输;
声音的主人主动给录音加上对抗扰动,试图让自己的声音「无法被克隆」。
现有评测大多聚焦干净条件下的生成质量,对上述部署偏移下的鲁棒性缺少系统、统一的刻画。RVCBench 想回答的问题,正是从「生成质量有多高」推进到「条件变化之后,模型还能否保持内容、身份、自然度以及与安全相关的行为」。
RVCBench 做了什么:四个环节、十类任务
RVCBench 沿着语音克隆的完整流程,把鲁棒性拆成四个维度:输入、生成、输出,以及贯穿其中的音频扰动(图 1)。

图 1|RVCBench 总览:沿语音克隆全流程评测输入、生成、输出与音频扰动四类鲁棒性。
图源:RVCBench 论文原文图 1(arXiv:2602.00443)。
四个维度下共设 10 类任务,为方便中文读者,我们把它们整理成图 2。

图 2|四个环节下的 10 类任务与统一评测指标(中文整理)。
图源:作者根据论文内容绘制。
输入鲁棒性关注模型拿到的「原材料」发生变化时的表现。RVC-AudioShift 改变参考音频的说话人属性,覆盖 12 种英语口音以及不同性别、年龄群体;RVC-TextShift 把标准文本替换为容易诱发幻觉的异常文本(如拼写错误、格式异常、中英混杂片段)和诈骗类机器人电话话术。
生成鲁棒性关注更难的生成设定。RVC-LongContext 分别考察长参考音频和分钟级长文本;RVC-Expression 检验情感与表达风格能否被正确传递;RVC-Multilingual 覆盖英语(VCTK、LibriTTS)、中文(AISHELL-1)、法语(Common Voice)三种单语设定,以及参考音频与文本语言不同的英 - 中跨语言克隆。
输出鲁棒性关注生成之后的「下游链路」。RVC-Compression 模拟 AAC、MP3、Opus 等不同码率的压缩以及窄带电话传输;RVC-Detectability 用九种深度伪造检测器(涵盖自监督、图神经网络、卷积网络以及音频大模型裁判等类型)衡量合成语音与真实语音的可分性。
音频扰动鲁棒性关注参考音频受到干扰时的表现。RVC-PassiveNoise 加入咖啡馆、车站、火车等环境噪声和多说话人干扰;RVC-AdvNoise 引入 SafeSpeech 及其变体 SPEC、Enkidu、POP 等主动防克隆保护产生的对抗扰动;RVC-AntiProtect 进一步考察用 DEMUCS 去噪能否「破解」这些保护。
在规模上,当前版本的 RVCBench 共包含 18 项鲁棒性评测,覆盖 10 类任务和 14,370 个评测样本;各子数据集合计 225 个说话人条目,去除跨子集重复后为 204 名独立说话人。
评测怎么做:统一的指标与模型
为了让不同模型、不同任务之间可以直接比较,RVCBench 使用一套统一的指标体系:

论文主文系统评测了 18 个代表性开源语音克隆模型,覆盖三类主流生成范式:
自回归编解码 token 模型(6 个):FishSpeech、XTTS-v2、Spark-TTS、IndexTTS、MOSS-TTSD、Higgs;
扩散 / 流匹配等非自回归模型(8 个):MaskGCT、StyleTTS2、F5-TTS、OZSpeech、OpenVoice、PlayDiffusion、VibeVoice、ZipVoice;
语言模型与扩散 / 流匹配结合的混合模型(4 个):CosyVoice、Qwen3-TTS、MGM-Omni、GLM-TTS。
附录另外报告了 Fish Audio S2、MOSS-TTS v1.5、dots.tts、Higgs TTS 3 四个扩展系统的结果。
主要发现
输入偏移:文本异常主要伤害内容准确性
在文本端,把标准 VCTK 文本换成幻觉式文本后,各模型的 WER 普遍上升,部分模型的退化相当明显(图 3a),说明异常格式和不常见的 token 会破坏文本与语音之间的对齐。诈骗类文本带来的变化更小,但依然可见(图 3b)。

图 3|文本偏移下相对标准 VCTK 文本的 WER 变化:(a) 幻觉式文本;(b) 诈骗类文本。
图源:RVCBench 论文原文图 4(arXiv:2602.00443)。
在参考音频端,不同口音的克隆质量存在差异:在所评测的 VCTK 子集中,印度口音参考音频的平均 MCD 最高,加拿大口音较低。需要说明的是,部分口音组只有一名说话人,这些结果更适合作为「值得进一步检验的潜在差距」,而不是对口音群体的排名。
生成任务:参考长度、长文本与情感都会暴露短板
参考音频长度会显著影响克隆质量。随着参考音频从几秒增加到约 8–12 秒,MCD 快速下降、SIM 快速上升;超过这个范围后,收益逐渐趋于饱和(图 4a、4b)。不同模型的敏感度也不同:CosyVoice、Higgs、MGM-Omni 等较强的模型能持续从更长参考中获益,而 StyleTTS2、OZSpeech 等模型即使给了长参考,相似度提升也有限。

图 4|(a)(b) MCD 与 SIM 随参考音频时长的变化;(c)(d) 不同压缩与传输方式下的 MCD 与 STOI。
图源:RVCBench 论文原文图 3(arXiv:2602.00443)。
长文本则是一个普遍难题。从常规长度的 LibriTTS 换到分钟级的 LibriSpeech 长文本后,大多数模型的 WER 明显上升,MCD 也普遍增加(图 5),内容遗漏、替换和声学漂移会随生成长度不断累积。论文指出,虽然个别模型相对更稳定,但没有一个模型能够完全免疫长文本带来的退化。
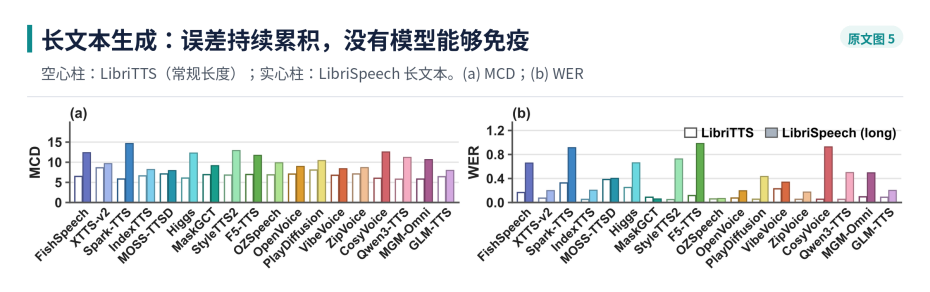
图 5|长文本生成:LibriTTS(空心)与 LibriSpeech 长文本(实心)上的 (a) MCD 与 (b) WER。
图源:RVCBench 论文原文图 5(arXiv:2602.00443)。
情感表达上的结果更值得警惕。论文用音频大模型(Gemini-3-Flash)按 0–3 分评估合成语音是否传达了文本应有的情感。在普通文本上,几乎所有模型都接近满分;但换成诈骗类机器人电话文本后,所有模型的情感对齐评分都明显下降,不同模型之间的差异也更大(图 6)。有意思的是,诈骗文本本身往往带有更强烈、更直白的情绪(紧迫、恐惧、施压或安抚),模型却没能把这些情绪可靠地转化为韵律和说话风格。
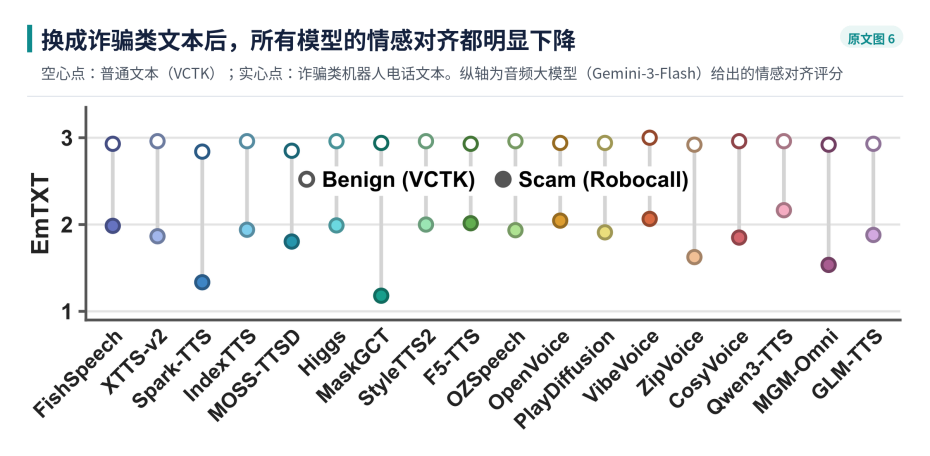
图 6|普通文本(VCTK,空心点)与诈骗类文本(实心点)上的情感对齐评分。
图源:RVCBench 论文原文图 6(arXiv:2602.00443)。
在多语种设定中,模型同样表现出明显差异。例如 FishSpeech 的 WER 从英语 VCTK 上的 0.03 上升到中文 AISHELL-1 上的 0.47,Higgs 则从 0.19 上升到 0.78;相比之下,CosyVoice、MGM-Omni、GLM-TTS 等混合模型在中文和跨语言设定下仍能保持较高的说话人相似度。
输出端:压缩带来稳定损失,可检测性因模型而异
所有模型在压缩后都会出现 MCD 上升、STOI 下降,其中窄带电话传输对频谱一致性的影响最大,而不同低码率编码对可懂度的影响则因模型而异(图 4c、4d)。这说明输出端的稳健性与模型架构和声码器设计紧密相关,并不是「生成质量高」的自然副产品。
在可检测性上,九种检测器的结果显示,OpenVoice、OZSpeech、PlayDiffusion 生成的语音更容易与真实录音区分,而 CosyVoice、Spark-TTS、MGM-Omni、Qwen3-TTS、GLM-TTS 在常规检测器下的可分性更低。论文将这一维度视为对鲁棒性的补充安全信号:生成质量与「是否容易被检测出来」需要分开看待。
音频扰动:噪声损害克隆质量,防克隆保护难以被简单破解
在参考音频中加入自然背景噪声后,18 个模型的各项指标平均都出现了退化(图 7a):WER 的相对恶化幅度达到 265.6%,MCD、SIM、说话人验证通过率(SVA)和 MOS 也分别下降约 19% 至 36%。不同模型对噪声的敏感度差异很大(图 7b):OpenVoice 的 MCD 甚至略有下降,ZipVoice 等模型变化也很小,而 Spark-TTS、MOSS-TTSD 的 MCD 上升最多。论文也观察到,大约一半模型在噪声参考下的 WER 变化并不显著,另一半则出现了不同程度的下降。多说话人干扰的影响更普遍:随着干扰强度增加,所有被测模型的身份、自然度和频谱一致性都会明显下降。

图 7|自然背景噪声的影响:(a) 18 个模型平均的各指标相对变化;(b) 每个模型的 MCD 变化。
图源:RVCBench 论文原文图 7(arXiv:2602.00443)。
从安全角度看,主动防克隆保护的效果是一个相对积极的信号(图 8a)。整体而言,SafeSpeech 及其变体 SPEC 对多数模型的干扰最强:对 18 个主文模型取平均,干净参考音频的说话人相似度约为 0.492,而加上 SPEC 和 SafeSpeech 保护后分别降到约 0.223 和 0.242,降幅超过一半。保护效果也因模型而异,例如 POP 几乎让 FishSpeech 完全无法克隆(SIM 仅 0.01),而 Qwen3-TTS 在各种保护下都保持了相对最高的相似度;MOSS-TTSD、Spark-TTS 等模型则在噪声和对抗扰动下都显得较为脆弱。

图 8|(a) 不同主动保护下每个模型的 SIM;(b)–(d) SPEC 保护后及 DEMUCS 去噪(DNS64)后,MCD、MOS、SIM 相对干净参考的变化。
图源:RVCBench 论文原文图 9(arXiv:2602.00443)。
更进一步,RVC-AntiProtect 先用 SPEC 保护参考音频,再用 DEMUCS 去噪,试图「抹掉」保护扰动(图 8b–8d)。结果显示,去噪能为部分模型降低频谱失真,但生成语音仍明显不如干净参考,SIM 和 MOS 的下降在多数模型上依然存在。换句话说,当前的主动保护会对克隆质量造成持续的损伤,而朴素的去噪并不足以绕过它们。
三点更深的观察
第一,干净条件下的高分不能代表鲁棒性。同一个模型可能在干净测试集上拥有很高的自然度和相似度,却在噪声、异常文本、长上下文、跨语言或后处理条件下暴露出完全不同的弱点。例如在英语 VCTK 上,StyleTTS2 和 PlayDiffusion 的 WER 低至 0.01,但它们的说话人相似度(0.24 和 0.43)明显低于 CosyVoice(0.58)和 GLM-TTS(0.57)。只看单一指标或单一排行榜,容易高估模型在真实场景中的可靠性。
第二,模型更大不等于更稳。论文没有观察到鲁棒性随参数量单调提升的趋势:639M 参数的 CosyVoice 在各类语言偏移设定下都优于 5.97B 参数的 Higgs,2.16B 的 GLM-TTS 在中文和跨语言评测中也比 Higgs 更稳健。从三类范式来看,自回归模型在干净英语场景中很有竞争力,但面对语言偏移时退化较明显;扩散 / 流匹配模型在简单英语任务上内容准确性很强,但说话人相似度有限;混合模型在多语种和跨语言设定下表现最均衡。论文据此认为,架构家族、条件注入方式、多语种训练和说话人表征设计比参数规模本身更能解释鲁棒性差异。当然,这一分析是描述性的而非因果性的,因为各模型在训练数据和目标等方面也各不相同。
第三,鲁棒性与安全是同一枚硬币的两面。对使用者来说,我们希望模型在噪声和压缩下依然稳定;对声音的主人来说,我们又希望保护扰动能有效阻止未经授权的克隆。RVCBench 把这两类需求放在同一套协议下评测,使「模型有多稳」和「保护有多强」可以被一起讨论。
从论文基准到开源工具
RVCBench 并不只是一次性的论文实验。GitHub 主分支(v2)已经把基准重构为一个可直接 pip 安装的通用语音克隆评测工具包,目标是让研究者能方便地评测自己的新模型,而不只是复现论文结果。目前,RVCBench 已在 PyPI 正式发布(pip install rvcbench,v2.2.1,发布首周即迭代 5 个版本);项目网站公开了 22 个模型的结果榜单,涵盖 Qwen3-TTS、CosyVoice 2 等最新模型;评测数据集和在线 Demo 同步发布在 Hugging Face 上,代码以 CC0 协议完全开放,学术研究与工业评测均可自由使用。安装后先运行一次 rvcbench setup-scorers,下载并校验各指标所用的模型:
pip install "rvcbench [eval]"rvcbench setup-scorers
工具包提供两种用法。
第一种:直接为自己的音频打分。如果你已经有生成的语音和参考录音,可以不使用 RVCBench 的数据集,直接调用 Python 指标 API(metrics.Evaluator),一次加载、批量计算 SIM、SVA、WER、SpeechMOS、MCD、STOI 和情感一致性共 7 项公开指标。
第二种:用 RVCBench 的数据评测模型(图 9)。先用 rvcbench prompts 导出所选评测集的参考音频和文本;再用自己的模型(可以在任意环境中运行,也可以是 API)逐条生成语音并保存为 <id>.wav;最后用 rvcbench score 按统一协议打分,得到包含分任务得分、覆盖率和置信区间的 submission.json。同一条命令传入多个输出目录,或使用 rvcbench compare,还能生成 comparison.md,把多个模型放在同一张表中比较。导出的提示同时提供 ZipVoice 和 Seed-TTS 风格的批量列表,F5-TTS、CosyVoice 等模型的原生推理脚本可以直接读取。
rvcbench prompts --suite core-v1 --output prompts/# 用你的模型逐条生成,保存为 outputs/my_model/<id>.wavrvcbench score --suite core-v1 \--generated outputs/my_model \--output results/my_model --device cuda

图 9|RVCBench 工具包的使用流程。
图源:作者根据 RVCBench 代码仓库与文档绘制。
工具包目前提供三档评测集:onboarding-v1 包含 52 条语音,用于跑通完整流程;core-v1 包含 480 条语音,覆盖论文 18 项评测中的 16 项;full-v1 包含 12,724 条语音,覆盖更大规模的评测数据(保护类任务目前由 core-v1 提供)。通过 --tasks 可以只评测中文、背景噪声等指定场景,中断后也可以用 --resume 续跑。此外,仓库还内置了 32 个语音克隆模型适配器、5 种保护方法以及去噪阶段,供保护与反制方向的研究使用。
需要说明的是,这些评测集目前仍是预览版,论文中的结果使用单独的复现协议,相应代码保留在 v1 分支;论文中的深度伪造可检测性评测和音频大模型情感裁判也暂未纳入安装包。完整说明见文档网站(https://nanboy-ronan.github.io/RVCBench/docs/)。
结语
语音克隆正在从实验室走向真实世界,而真实世界从不提供「干净测试集」。RVCBench 的价值不在于给模型排出一个简单名次,而在于把语音克隆的能力边界拆开来看:在哪些条件下它依然可靠,在哪些条件下它会失效,以及主动保护能在多大程度上阻止滥用。论文的结论也指向一个方向:未来的语音克隆系统应当把鲁棒性当作一等设计目标,在训练和评测中覆盖噪声与多说话人参考、分布外文本、跨语言与长文本生成、情感韵律传递、压缩失真以及对扰动更稳健的说话人表征。我们希望这套基准和工具能帮助研究者更早发现模型的薄弱环节,也为语音生成的安全研究提供一个可复现、可扩展的共同起点。欢迎大家使用 RVCBench 评测自己的模型,并在 GitHub 上提出问题与建议。
参考链接
[1] 论文:Jin R., Liao X., Yu H., Pandya D., Li X. RVCBench: Benchmarking the Robustness of Voice Cloning Across Modern Audio Generation Models. NeurIPS 2026. arXiv:2602.00443. https://arxiv.org/abs/2602.00443
[2] 代码与工具包:https://github.com/Nanboy-Ronan/RVCBench(PyPI:rvcbench)
[3] 项目主页:https://nanboy-ronan.github.io/RVCBench/
[4] 文档网站:https://nanboy-ronan.github.io/RVCBench/docs/
[5] 数据集(Hugging Face):https://huggingface.co/datasets/Nanboy/RVCBench
[6] 在线 Demo:https://huggingface.co/spaces/Nanboy/RVCBench

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com