一句话:能在自己电脑上跑的开源编程 MoE——总参约 40B,每个 token 只激活约 2.5B,官方给的短上下文速度:M4 Pro 超过 125 tok/s,64GB NVIDIA RTX Spark 超过 150 tok/s。
先认识一下 Recursive
Recursive(X:@Recursive_SI)是一家做“用 AI 做 AI 研究”的公司,目标是让研究流程能自我改进。CEO 是 Richard Socher——很多人可能更熟他做 AI 搜索 You.com 的那一面。
他们手里的核心系统叫 Eureka Machine:用 AI 自动提出想法、写实现、跑实验、再根据结果决定下一步试什么,相当于用自动化把模型研发闭环跑起来。这次发布的 Recursive Flint,就是 Eureka Machine 的一次实战成果。

Recursive CEO Richard Socher(图源:Recursive 官方文章)

Recursive 官方帖(引用 Richard Socher 公告,图源:X @Recursive_SI)
Recursive 官方博客
https://recursive.com/updates/introducing-recursive-flint
Hugging Face 权重(BF16)
https://huggingface.co/RecursiveSI/flint
Hugging Face INT4(Apple Silicon / MLX)
https://huggingface.co/RecursiveSI/flint-int4
Recursive 官网
https://recursive.com/
Recursive 官方帖
https://x.com/Recursive_SI/status/2112947469826896151
Flint 是什么
官方定位很清楚:面向本地硬件的 agentic 编程 MoE。博客写的是 40B 总参数、每 token 激活 2.5B;Hugging Face 模型卡更精确一点——39.8B 总参,每 token 激活约 2.5B(含输出头;仅主体约 2.2B),对外常写作 40B-A2.5B。
小团队加人加 agent,从零开始不到四个月做完。权重在 Hugging Face 以 Apache 2.0 开源;文档化上下文配置为 262,144 tokens(提示+生成共用)。博客另写支持最高 512k,编程等任务建议尽量落在 256k 以内。
Richard Socher 公告视频封面(图源:X @RichardSocher / Recursive)

Hugging Face:RecursiveSI/flint(BF16,图源:Hugging Face)
编程基准:官方数字
Hugging Face 模型卡与官方博客图表给出的 agentic 编程成绩(发布评估):
• Terminal-Bench 2.1:54.9%
• SWE-bench Pro v2:89.7%
• SWE-bench Verified:74.2%
评估设定(官方说明):temperature 1.0、top-p 0.95、top-k 20;Terminal-Bench 用 Terminus 2,SWE-bench 用 mini-swe-agent;agentic 分数为至少 5 次尝试的平均 pass@1。Terminal-Bench 把通过网页检索拿到的解算作不成功——和其他来源的报分不一定同口径。
官方说法是:在总参不足 50B 的 MoE里,Flint 在上述 agentic 编程基准上领先;同时接近 25–40B 稠密模型的编程表现,但推理快得多。
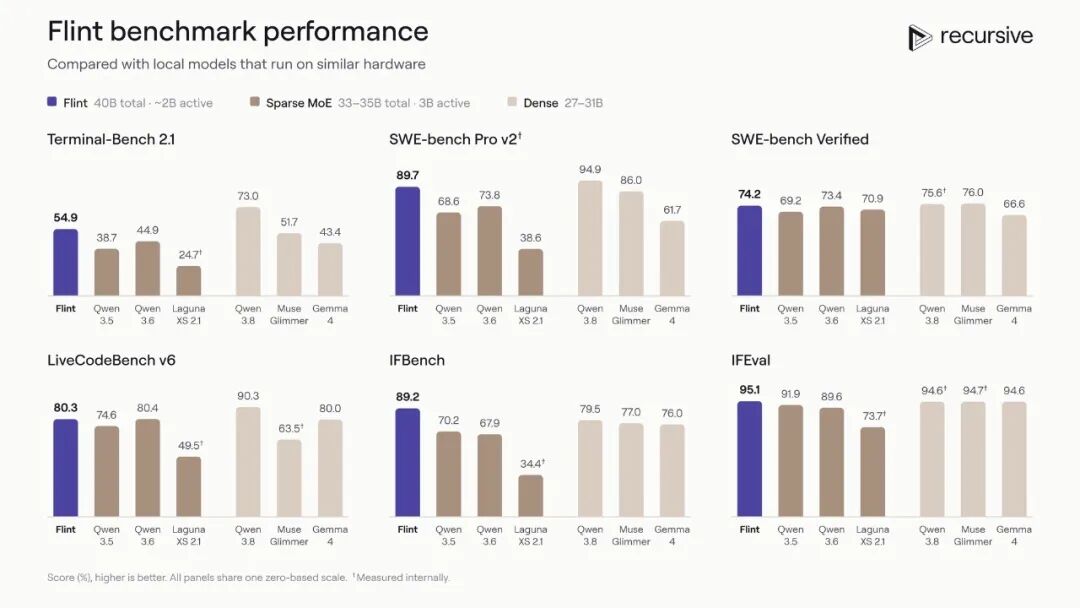
Flint 与相近硬件可跑模型的基准对比(图源:Recursive 官方文章)
本地速度:Mac 和 RTX Spark
博客写:用他们优化过的推理引擎,短上下文下 M4 Pro MacBook Pro 超过 125 tok/s,64GB NVIDIA RTX Spark 超过 150 tok/s,同类可比模型最高大约快一倍;相对拿到相近编程分的 25–40B 稠密模型,则超过五倍。
官方吞吐图更细:M4 Pro 48 GiB 上 Flint·MLX 短上下文约 131 tok/s;RTX Spark 上 Flint·NVFP4 短上下文约 156 tok/s。长上下文(到 128K 的归一化均值)会低一些,但仍明显高于同档对照。

本地推理吞吐:M4 Pro 与 RTX Spark(图源:Recursive 官方文章)

质量–速度前沿:Flint 把高分推到更高速度区(图源:Recursive 官方文章)
Eureka Machine 怎么参与造模型
Flint 被当成 Eureka Machine 的压力测试:从数据、优化器、训练配方,到架构搜索、量化、内核,几乎整条造模栈都有它参与。
• 架构:从约 35B 总参 / 3B 激活的基线出发搜专家配置,落到现在的 40B / 2.5B 激活
• 量化:连 lm_head 也压到 4 bit,再加离线蒸馏;官方称最终 NVFP4 相对 16-bit 在基准上差距约 0.7 分以内
• 内核:为 Apple Silicon 和 RTX Spark 做低比特投影、MoE、注意力等专用核;M4/M5 上还有融合整段 decode 的 Metal megakernel
Recursive 官方配图(图源:Recursive 官方文章)
怎么跑
• 权重:Hugging Face RecursiveSI/flint(BF16)与 RecursiveSI/flint-int4(约 22.6 GB,MLX INT4,主要面向 Apple Silicon)
• 协议:Apache 2.0
• 官方提到可接 llama.cpp、Ollama、Unsloth、LM Studio、vLLM、SGLang;另有轻量引擎 rec,面向 M4 Pro / M5 Pro·Max 优化
• BF16 侧提供 SGLang 服务套件;Transformers 建模代码尚未随仓提供
• 官方提醒:复杂任务宜拆小、给明确指令;结果仍需人工审代码
说明:文中数字均来自 Recursive 官方博客与 Hugging Face 模型卡;图片均为官方文章 / 官方帖 / HF 预览图,非 AI 生成。
相关链接
Recursive 官方博客
https://recursive.com/updates/introducing-recursive-flint
Hugging Face 权重(BF16)
https://huggingface.co/RecursiveSI/flint
Hugging Face INT4(Apple Silicon / MLX)
https://huggingface.co/RecursiveSI/flint-int4
Recursive 官网
https://recursive.com/
Recursive 官方帖
https://x.com/Recursive_SI/status/2112947469826896151