英伟达(NVIDIA)是全球最大的 AI 芯片公司,GPU 撑起了今天大部分大模型的训练和推理。这几年它也在自己做开源模型,统一叫 Nemotron(“尼莫传”)系列,特点是权重、训练数据、训练配方一起放出来。
10 月 23 日晚(北京时间 23:41 左右),英伟达 AI 官方账号发布了这个系列里最小的一款:Nemotron 3.5 Bolt E4B。一句话概括:量化后大约 4GB,普通电脑、边缘设备上就能本地跑,主打本地语音助手、互动角色和机器人。
Hugging Face 模型地址:
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB
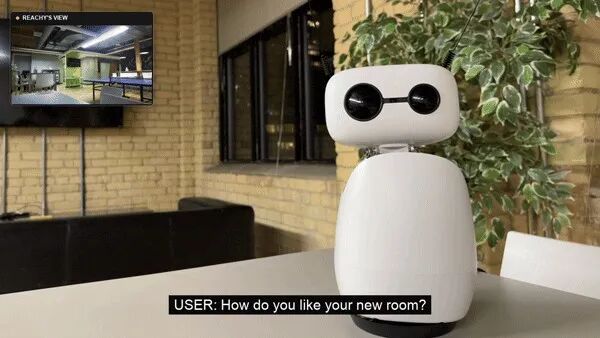
官方演示:Reachy Mini 小机器人跑着 Bolt E4B 和人对话(截自 Hugging Face 模型卡动图)
它是什么
据 Hugging Face 模型卡,Bolt E4B 是英伟达在谷歌开源模型 Gemma 4 E4B 的基础上继续后训练出来的。总参数 80 亿,有效参数 40 亿,所谓“有效”,指推理时真正参与计算的规模接近一个 40 亿参数的模型,所以又快又省显存。
英伟达一次放出两个主要版本:一个是全精度的 BF16 版,适合继续微调、做研究;另一个是 4 位量化的 Q4_K_M 格式(GGUF 文件),这就是标题里约 4GB 的那个,可以用 llama.cpp 这类工具直接跑。上下文长度输入、输出各最多 6.4 万 token。
模型卡写明,它的输入输出都是文本。英伟达强调的改进方向是:多轮工具调用、听懂指令、贴着给定材料回答不乱编,这些正是语音助手和机器人最需要的能力。
两个开关:想不想“思考”、要不要说短话
第一个开关是思考模式。打开后模型先推理再回答,适合算题、规划;关掉则直接回答,响应更快。模型卡还提到可以在运行时控制“思考预算”,限制它想多久。
第二个开关叫对话模式。打开后,模型回答会更简短、少用列表加粗之类的排版,更像人说话,适合接在语音合成后面念出来。两个开关可以和工具调用叠加使用。
成绩怎么样

横轴是首字延迟(越靠左越快),纵轴是代表性基准平均分。图源:Hugging Face 模型卡
英伟达给的这张图里,4GB 版 Bolt E4B 平均分 70.2,首字延迟三百毫秒左右;同尺寸的原版 Gemma 4 E4B 是 63.2,阿里 Qwen 3.5 4B 是 59.1。比它分高的 Gemma 4 26B-A4B(72.8)体积和延迟都大得多。
以多轮对话难度较高的 MultiChallenge 测试为例,模型卡显示 4GB 量化版得分 55.60,原版 Gemma 4 E4B 量化版 39.36;全精度版 53.10,对应 Gemma 4 E4B 为 42.08。角色扮演(RoleBench 自定义版 71.21 对 60.51)、指令层级(IHEval 82.40 对 66.61)提升也比较明显。
另外,第三方评测机构 Scale Labs 在推特上给出的 MultiChallenge 成绩是 56.03%,Gemma 4 E4B 为 43.2%,口径和模型卡略有不同,供参考。
当然它也不是样样第一。按模型卡,在 Tau2-Bench、长文本 RULER 和 LongBench v2 等项目上,Qwen 3.5 4B 仍明显领先,说明它的优势集中在对话、角色和指令遵循上。
能在哪儿跑
模型卡列出的测试硬件,从数据中心的 H100、GB200,到桌面的 GeForce RTX 5090、DGX Spark,再到机器人常用的 Jetson Orin、Jetson Thor 都有。英伟达官方推文演示的就是 Reachy Mini 桌面机器人。
开源社区跟进也很快。Unsloth 第一时间放出了自己的 GGUF 版本,称 6GB 内存即可运行,并支持视觉输入;需要注意的是,英伟达官方模型卡标注的输入输出均为文本,视觉能力是 Unsloth 基于底座模型提供的说法,以其说明为准。
开放到什么程度
这次用的是 OpenMDW-1.1 许可,可商用。除了权重,英伟达还在 Hugging Face 上公开了后训练数据集,并发布了技术报告,说明训练怎么做。因为底座来自 Gemma 4,底座部分仍遵循 Apache 2.0 许可。
对想做本地 AI 硬件的团队来说,这意味着拿一个 4GB 级别的模型,就能搭出会聊天、会调工具、回答短而自然的设备助手,而且整条链路可以自己复现和改。
相关链接
Hugging Face 模型(4GB 量化版):
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB
Hugging Face 模型(BF16 全精度版):
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-BF16
英伟达官方推文:
https://x.com/NVIDIAAI/status/2113657112408785153
技术博客:
https://research.nvidia.com/labs/nemotron/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB/
技术报告 PDF:
https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB-Technical-Report.pdf
Unsloth GGUF 推文:
https://x.com/UnslothAI/status/2113658964365971681
Scale Labs 评测推文:
https://x.com/ScaleAILabs/status/2113659092019605662