点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
GenSfM的核心思想可概括为:不再由前馈重建器先行估计相机与可见几何、再由3D生成器补全不可见区域,而是将原生3D扩散模型本身作为联合推理引擎,使形状与各视角相机位姿在同一多模态序列中联合去噪。

1. 问题:重建与生成各自只解决了一半
从少量未标定视图恢复物体3D结构与相机运动是计算机视觉的经典问题,稀疏视角则进一步暴露了现有方法的局限。
经典SfM/MVS能够给出与输入图像一致的可见几何与相机位姿,但无法恢复未观测区域;在以物体为中心的稀疏视角设置下,大片表面缺乏纹理与重叠支撑,几何范式随之失效。原生3D生成(TRELLIS、TripoSR、Hunyuan3D等)擅长生成完整形状,隐藏几何可从大规模3D先验中推断,但其不处理相机位姿问题;直接用于未标定稀疏视图时,可能生成视觉合理但空间失配的几何。“先重建、再生成”的级联方案(ReconViaGen等)由前馈重建器提供位姿与可见几何,再由3D生成器补全隐藏区域,但两阶段分离优化,重建骨干的误差会传播至生成结果,难以形成对全部输入视图均自洽的单一3D假设。
GenSfM选择反转该流程:将原生3D扩散先验作为联合推理的主引擎,而非事后补全的辅助模块。
 图1:给定多视图输入,GenSfM在统一3D空间中恢复物体形状与相机位姿。扩散Transformer通过迭代的结构与位姿去噪模拟端到端SFM过程;去噪后的相机(蓝色)与真值位姿(红色)精确对齐,恢复的3D结构给出整体物体表示。
2. 方法:单一多模态DiT联合去噪形状与相机
GenSfM建立在两个原生3D组件之上:TRELLIS提供两阶段骨干与条件流匹配(CFM)目标,CUPID提供3D原生单图像位姿token化。其关键操作是将CUPID的单视图位姿表示扩展至多视图,并将形状潜在与各视图位姿潜在置于同一扩散Transformer的联合自注意力中。
2.1 多视图位姿的紧凑Token化
对每个视图,每个活跃体素投影至,得到UV体积。共享位姿VAE将压缩为,其中。与CUPID在通道维拼接形状与位姿、仅支持单视图不同,GenSfM将形状潜在置于序列前端,后接所有视图的位姿潜在,构成统一序列。取而非CUPID的,每个位姿的token数减少;由于UV体积对低自由度透视投影高度过参数化,精度损失可忽略。
推理时,位姿VAE将解码回UV体积,再通过Direct Linear Transform(DLT)最小二乘从逐体素对应中恢复投影矩阵:
最后由RQ分解得到内参与外参,内外参均无需预先提供。
2.2 共享自注意力:形状与位姿相互感知
共享Transformer骨干具有流特定的投影与网格对齐位置编码。可学习register token被前置至形状流,作为所有视图经自注意力通信的共享通道。CFM插值扩展至形状时间步与逐视图位姿时间步,第0层隐藏状态为:
其中为与网格上的绝对3D位置编码,为视图ID嵌入,将位姿潜在与其源视图的图像条件token绑定。每个DiT块对全部个视图的条件token执行交叉注意力,同时对整个序列执行联合自注意力。训练损失为流式条件流匹配:
图像条件方面,DINOv2语义丰富但空间粗糙,GenSfM以小型卷积金字塔提取多尺度局部特征,与DINOv2逐token通道拼接后加上视图标签嵌入,作为每个DiT块的交叉注意力键/值。
2.3 位姿感知的精细阶段:逐体素在位姿对齐投影上采样
TRELLIS的SLat阶段仅通过全局交叉注意力条件化输入图像,细粒度外观未锚定至具体体素,表面细节易模糊。粗阶段恢复后,每个活跃体素具有已知投影,可直接逐体素采样。GenSfM为每个体素构造两个互补特征:
语义特征:位姿采样的DINOv2 patch经冻结SLat编码器重新编码,置于SLat目标的同一潜在流形; 纹理特征:多尺度CNN金字塔双线性采样,提供DINOv2缺乏的低层线索。
有个视图时,每个体素具有个位姿对齐投影,特征在视图间取平均:
池化算子无参数且与视图数无关;本文模型在下训练。
 图2:GenSfM概览。粗阶段以多模态形状-位姿DiT联合去噪稀疏结构潜在与逐视图3D原生位姿token,共同恢复形状与多视图相机位姿;细阶段以逐体素位姿采样图像条件精化几何与外观。
3. 工程实现:仓库提供完整推理入口与可复现训练链路
项目主页:https://dotb1ue.github.io/GenSfm/,代码仓库https://github.com/dotb1ue/GenSfm的工程成熟度较高,从环境配置到推理、训练、评估均有明确入口。
3.1 环境安装
仓库要求Linux、NVIDIA GPU及CUDA工具链(nvcc)。默认环境为Python 3.12、PyTorch 2.9.1、CUDA 12.8,通过./setup.sh --new-env --basic --spconv --mipgaussian --nvdiffrast创建gensfm环境,并建议显式设置注意力后端为PyTorch SDPA(ATTN_BACKEND=sdpa),避免依赖额外注意力包。--new-env仅用于新建环境;已有兼容PyTorch/CUDA的环境可省略该参数。
3.2 快速推理
仓库自带五组四视图示例(海绵宝宝毛绒、金属头像、花园侏儒、花卉茶壶、布艺小车),覆盖合成渲染与真实照片。运行:
python example_multi_image.py \
  --input-dir assets/example/wagon \
  --pretrained dotblue/GenSfm \
  --output-dir outputs/wagon
首次运行从Hugging Face下载约5.8 GB预训练模型及DINOv2编码器。--steps控制两阶段去噪步数,--seed默认值为1;--pretrained也接受已下载的本地bundle目录,--revision可指定Hugging Face版本。
使用自有图像时,准备同一刚性物体的2–4个视图,推荐四视图覆盖不同侧面,提供透明背景的RGBA前景遮罩,保留完整物体、孔洞与细薄部件;RGB照片可加--remove-background以rembg生成遮罩,杂乱背景下需人工检查遮罩质量。--images保留用户给定的顺序,--input-dir则按文件名顺序加载目录内全部受支持图像。
3.3 Python API
在导入pipeline前需设置与CLI相同的注意力环境变量:
from trellis.pipelines import GenSfMPipeline

pipeline = GenSfMPipeline.from_pretrained("dotblue/GenSfm").cuda()
result = pipeline.run(
    [f"assets/example/wagon/{i:02d}.png" for i in range(4)],
    seed=1,
)
mesh = result["mesh"][0]
gaussians = result["gaussian"][0]
extrinsics, intrinsics = result["extrinsics"], result["intrinsics"]
pipeline.run直接返回网格、3D高斯与预测相机;若需保存为文件,CLI会额外导出带纹理GLB、PLY与重投影图像。
3.4 输出格式
mesh.glb | |
gaussian.ply | |
cameras.json | |
input-XX.pnginput-rgba-XX.png | |
reprojection-XX.png | |
run.json |
相机外参为模型Z-up坐标系下的OpenCV world-to-camera矩阵;内参为归一化矩阵,包含倾斜与主点偏移,分别对应模型裁剪与EXIF方向源图。GLB使用(x, z, -y)而非模型坐标(x, y, z),投影导出网格时需应用cameras.json中的data_to_mesh变换。
3.5 训练与评估
训练数据准备按DATASET.md完成:下载数据、渲染视图、体素化形状、编码训练目标。UV目标编码需要一个训练好的UV编码器,该编码器不包含在推理bundle中。两阶段训练相互独立,分别对应以下配置:
位姿VAE: uv_vae_conv3d_4l8_fp16.json联合形状-相机生成(Stage 1): suv_flow_imgmv4vis_dit_L_16l8_p4l8_fp16.json位姿感知几何与外观(Stage 2): slat_flow_imgmv4_dit_L_64l8p2_fp16-convnextvisuallatentcond.json
Stage 1从microsoft/TRELLIS-image-large的两个上游去噪器初始化,Stage 2独立训练。评估需安装与PyTorch/CUDA兼容的PyTorch3D,然后执行. ./setup.sh --eval,python eval.py --help给出数据集评估参数。使用自定义checkpoint时,--stage1与--stage2分别指向两阶段的denoiser.pt;完整训练续跑需要原始训练状态。
3.6 推理与训练关键超参
文章给出了关键设置:粗阶段采用25步flow-Euler采样,分类器无关引导强度7.5,作用于,引导时间重缩放因子3.0;细阶段同样25步,CFG强度3.0,条件为恢复的相机与式(7)的逐体素位姿采样特征。位姿VAE在8块H200上训练1M步,批大小4/GPU;
粗阶段形状-位姿DiT在8块H200上微调1M步,全局批大小64;细阶段SLat DiT在4块H200上独立微调1M步,全局批大小32。粗阶段每个训练实例从物体的24个渲染视图中均匀采样个条件视图,图像围绕alpha-mask包围盒按紧度裁剪并重采样至;
DiT操作于4096个形状token、256个位姿token和128个共享register token,交叉注意力覆盖个图像条件token。每个训练步以概率0.8共享形状与位姿时间步,以概率0.2为每个流独立采样时间步。
4. 实验结果:PSNR提升3.2–4.5 dB,Chamfer距离降低约64%–74%,位姿Acc@5°超过96%
论文在Toys4k(合成)与GSO(真实扫描)上评估,每个数据集400个物体、两组不重叠4视图集合,共800个实例。所有方法在各自最匹配的对齐协议下评估,GenSfM在每种适用协议下重新评估。
对比前馈重建:在输入视图点图LSQ对齐下,GenSfM在Toys4k上达到 PSNR、 SSIM、 LPIPS、 CD-med、 F@0.01、 F@0.05,全面超过FreeSplatter、LucidFusion与ReconViaGen;GSO上PSNR 、CD-med 。前馈方法会将预测几何与预测位姿之间的不一致复合,而原生3D生成模型可在扩散过程中将其精化。
对比3D生成:在相似ICP对齐下,GenSfM在Toys4k上 PSNR、 SSIM、 CD-med、 F@0.01,GSO上 PSNR、 F@0.01,领先SAM 3D、TRELLIS-S、TRELLIS-M与ReconViaGen。两个强多视图基线——TRELLIS-M的随机逐步视图条件与ReconViaGen的“重建+生成精化”——仍显著落后,表明增益源于联合形状-位姿去噪,而非后期视图采样。摘要中特别指出,在Toys4k上相对TRELLIS-M,F@0.01从提升至。
位姿预测:预测内参下,GenSfM在Toys4k上RRE 、Acc@5° 、Acc@15° 、RTE 、RFOV ;GSO上RRE 、Acc@5° 、RFOV 。已知内参时Acc@5°升至(Toys4k)与(GSO)。VGGT在Toys4k上RRE 、Acc@5°仅、RFOV ,外参尚可但变化FOV下内参恢复误差显著;GenSfM将RFOV控制在以内,同时Acc@5°饱和。
作者给出的核心数据:在四视角未标定输入下,相比多视角基线TRELLIS-M,新视角PSNR提升3.2–4.5 dB,Chamfer距离中位数降低约**64%–74%**。这与论文摘要中“CD降低”为同一组数字的两种表达:,。
表4:GenSfM在预测内参与已知内参下均显著领先FreeSplatter、ReconViaGen与VGGT;Acc@5°超过96%,RRE处于–量级,RFOV低于。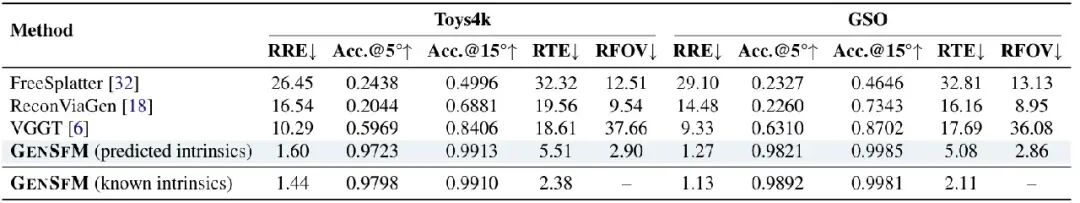
5. 消融:各组件贡献
表5:全交叉注意力实现跨视图信息共享,改善所有指标;视觉特征条件化锐化光度保真度与位姿精度,几何增益较小;共享register token对位姿精度与最严格F@0.01阈值贡献最大;Stage 2的原生多视图训练精化光度保真度,此时3D几何已饱和。
Stage 2的decoder替换不改变粗阶段原始相机,但会移动几何对齐的位姿指标,因其相似变换拟合依赖最终点图。定性消融亦印证:表面细节逐步锐化,完整模型最接近真值。
6. 局限与结论
GenSfM将原生3D扩散模型从“事后补全模块”重新定位为“联合稀疏视图结构与运动恢复的主推理机制”,消除了对外部前馈重建骨干的依赖。三个设计使该形式可处理:压缩至紧凑token网格的UV体积位姿潜在、将形状与逐视图位姿置于单一自注意力的统一多模态序列、在位姿对齐投影上逐体素采样特征的位姿感知精细阶段。无需外部位姿估计器、无需事后优化、无需已知内参。
局限亦明确:结果限于以物体为中心的输入;扩展至更多视图、场景级输入与分割更松的真实拍摄是后续方向。分布偏移下较大位姿或标定误差可能使细阶段特征配准错误,降低局部精化,但粗阶段3D先验仍保持全局补全。模型继承TRELLIS骨干的物体分布与分辨率限制,扩展底层生成器应能直接改善稀疏视图恢复。
论文已被NeurIPS 2026接收,项目页提供合成与实拍案例,代码与模型均已公开。
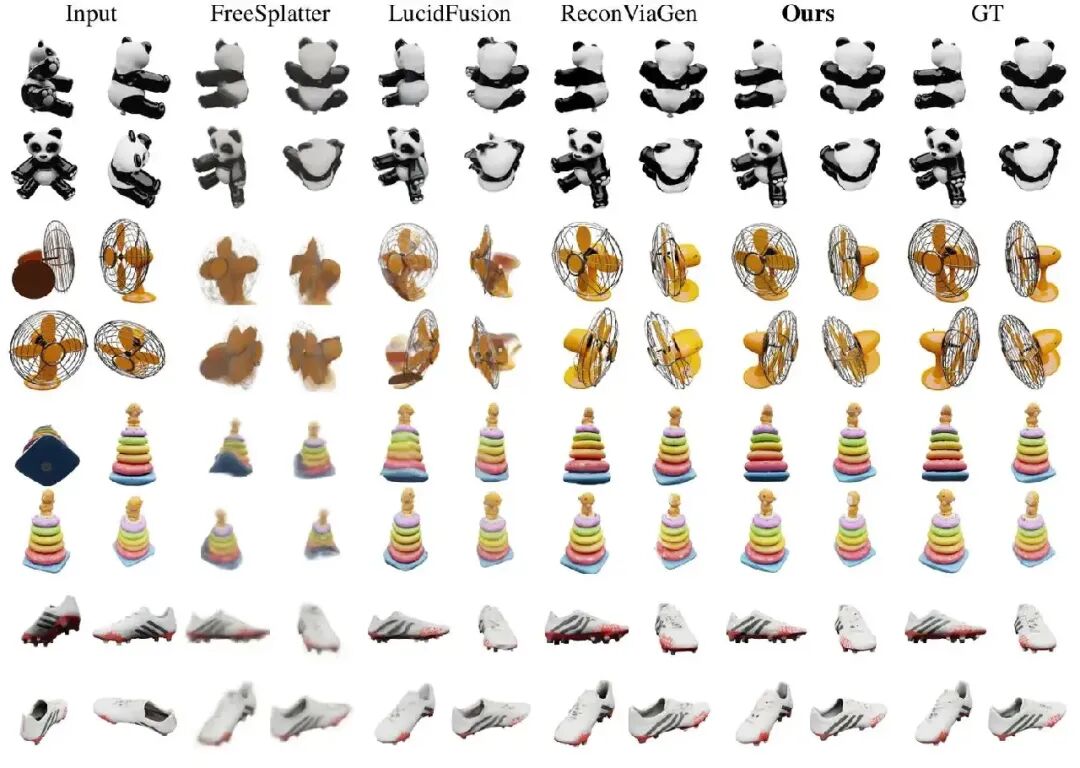 图3:与前馈重建方法的定性比较(Toys4k上两行,GSO下两行)。所有非输入列在输入视图点图LSQ对齐后,于真值相机帧中渲染同一留出新视图。
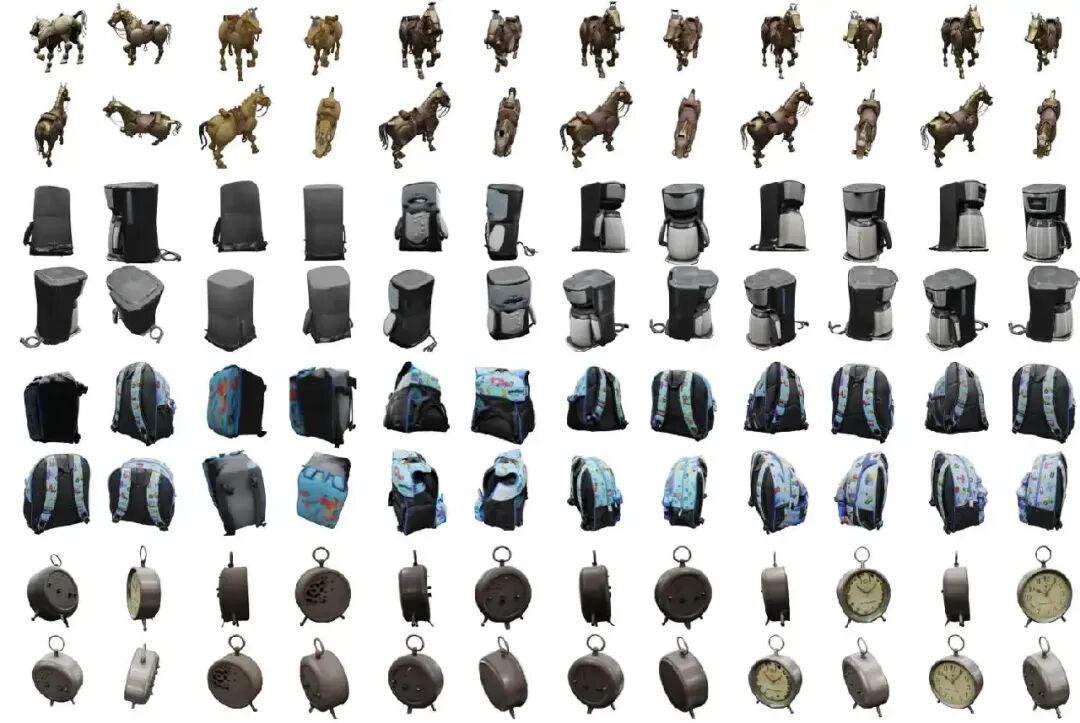 图4:与3D生成方法的定性比较(Toys4k顶行,GSO下三行)。所有非输入列在相似ICP对齐后,于真值相机帧中渲染同一留出新视图。
7. 引用
@inproceedings{duan2026gensfm,
  title = {Generative Structure from Motion with Native {3D} Diffusion},
  author = {Duan, Haobin and Huang, Binbin and Xiang, Mochu and Zhao, Yiqun and Zhao, Zibo and Ma, Yi and Gao, Shenghua},
  booktitle = {Advances in Neural Information Processing Systems},
  year = {2026},
  eprint = {2610.35522},
  archivePrefix = {arXiv},
  primaryClass = {cs.CV},
  url = {https://arxiv.org/abs/2610.35522}
}
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。