点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
太长不看版:小鹏机器人提出 Capek 0.5,以"执行中心"能力分类法(空间推理/时序理解/动作引导/状态验证)训练专用专家再用 TIES+MOPD 合并为单一模型;2B 与 35B-A3B 两个尺寸在协议匹配的 Qwen 基线上分别提升 30/34 与 28/34 个基准行。
标题:Capek 0.5: An Execution-Centric Vision-Language Model for Embodied Intelligence
作者:Ying Chen, Weizhen Li, Zhe Hu, Zhenjiang Li, Rui Jiang, Zhifeng Gu, Lihuang Fang, Jiangping Liu, Lei Yi, Jie Chen
机构:XPENG ROBOTICS
论文:https://arxiv.org/abs/2608.06756
导读
视觉-语言模型正日益成为具身智能体的推理核心。机器人执行本质上是迭代式的:每个动作都会重塑场景与物理状态,不断刷新需要被感知、推理与验证的内容。满足这些需求的能力在监督信号、预测格式与验证准则上各不相同。现有方法通常针对孤立的、任务特定的目标来发展这些能力,留下它们应如何围绕"执行"整体进行组织与整合的开放问题。
我们提出 Capek 0.5,一个围绕"执行中心"能力分类法构建的具身视觉-语言模型。该分类法不是按数据集或任务来组织训练,而是根据各项能力在整个执行过程中的功能角色对其进行分组,包含四个能力族:空间推理(Spatial Reasoning)、时序理解(Temporal Understanding)、动作引导(Action Guidance)与状态验证(State Verification)。每种能力先由专用专家通过带有可验证奖励的强化学习从共享骨干中获取,随后通过权重空间合并(weight-space merging)与路由的策略空间蒸馏(routed policy-space distillation)整合为单一推理时模型。
我们以 2B 与 35B-A3B 两个规模实例化 Capek 0.5,并从三个互补视角评估:综合性基准套件(含新增的状态验证基准 Capek-StateBench)、从专用专家到统一模型的能力保持受控研究,以及在仿真具身环境中的闭环评估。Capek 0.5 在其初始化基础上改善了绝大多数匹配的基准行,并在单一 checkpoint 中保留了全部四种专用能力。
效果展示

▲ 跨能力域的平均性能。结果由 Table 2 在五个域(Spatial Reasoning、Temporal Understanding、Action Guidance、State Verification 等)内取平均得到。
引言
视觉-语言预训练提供了强大的感知与语言先验 ,使视觉-语言模型(VLM)能够支撑语义规划、视觉推理,以及面向下游机器人控制的、基于语言的接口 。近期的机器人中心模型进一步以互补能力扩展这一基础,例如可供性定位(affordance grounding)、轨迹预测、时序理解,以及物理基础的规划 ,将 VLM 定位为能够感知、推理并指挥动作的"具身大脑",用于能力不断增强的具身智能体 。
然而,当前模型仍面临挑战,因为机器人执行本质上是迭代式的:每个动作都会改变场景与物理状态,不断刷新后续决策所需的证据。在整个执行循环中,VLM 必须反复对空间上下文进行推理、随时间解读事件、将动作锚定到环境中,并判断物理谓词是否成立、任务目标是否已经达成。因此,有效的机器人执行依赖于保持可解释、可验证的中间预测,使每一步决策都能可靠地指导下一步。现有的后训练流水线通常围绕单个任务、数据集或基准特定的目标来组织。即便此类监督被混合进单个模型,异构的输出结构与打分规则也使得我们难以判断究竟获取了哪些执行能力,以及它们在整合后是否仍被保留。
在本工作中,我们提出 Capek 0.5,一个用于机器人感知与推理的统一具身 VLM。Capek 0.5 不是仅围绕单个任务或数据集来组织后训练,而是采用一个"执行中心"的能力分类法,根据各项能力在机器人执行全过程中的功能角色对其进行分组。该分类法提供了一个通用框架,用于训练和评估那些当机器人在动态环境中感知、行动并验证进展时被反复调用的能力。具体而言,它包含四个能力族:空间推理(Spatial Reasoning)捕捉场景几何与实体间关系;时序理解(Temporal Understanding)对事件进展建模并识别相关变化何时发生;动作引导(Action Guidance)锚定任务相关实体与可供性,并产出图像空间中的点、区域与有序轨迹;状态验证(State Verification)判断视觉支持的物理谓词是否成立,以及任务目标是否已经达成。图 2 展示了这四种能力如何随着执行推进,在一个家务操作片段中反复出现。
然而,在单一模型内统一这一分类法并非易事:四种能力在监督信号与输出格式上差异巨大,涵盖结构化关系、时序定位、几何定位与视觉基础的谓词。这种异构目标使得用单一、无差别的配方进行联合后训练,容易在能力之间产生优化干扰 。为应对这一挑战,我们将能力获取与能力整合分离开来。四个专家都从同一骨干检查点出发,使用能力对齐的数据与目标。随后用 TIES 合并专家检查点以初始化统一学生模型,并在学生生成的前缀上通过路由的多教师在线策略蒸馏(MOPD) 进一步巩固。
我们以 Qwen3.6-35B-A3B 与 Qwen3.5-2B 为基础,实例化两个模型规模:Capek 0.5-35B-A3B 与 Capek 0.5-2B。我们从三个互补视角评估 Capek 0.5。第一,通过在综合性基准套件(涵盖通用视觉-语言理解,以及空间、时序、动作引导与状态推理)上将两条模型轨道与规模匹配的基线对比,评估通用与具身推理能力。第二,我们开展一项受控的整合分析,对比预训练骨干(即 Qwen3.6-35B-A3B)、四个独立专家,以及 TIES、仅 MOPD、TIES+MOPD 变体,以衡量能力保持与整合效果。第三,超越孤立基准,我们在仿真具身环境(包括 EmbodiedBench 与 VIGIL )中评估 Capek 0.5,考察多样化推理能力在任务执行过程中如何组合。这三个视角分别评估广义具身推理、专家到统一模型的能力保持,以及闭环中的能力组合。

主要贡献
执行中心的能力分类法。 我们引入一个包含空间推理、时序理解、动作引导与状态验证的执行中心能力分类法,并配以类型化、可验证的输出格式,以及同源的能力专家,用以度量的能力获取与保持。 统一的具身推理模型族 Capek 0.5。 我们提出包含 Capek 0.5-2B 与 Capek 0.5-35B-A3B 两条轨道的统一具身推理模型族,通过 TIES 初始化并接路由式 MOPD,将能力专家整合为单一推理时模型。 多层次评估。 我们提供跨基准套件(含新增的物理/任务状态验证基准 Capek-StateBench)、受控能力保持分析,以及仿真闭环环境的多层次评估,可分别分析能力获取、整合与组合;相对协议匹配的 Qwen 初始化,35B-A3B 与 2B 分别提升 28/34 与 30/34 个匹配基准行。
方法
Capek 0.5 的核心思路是一句话:用"执行中心"的能力分类法组织后训练,先让四个同源专家各自习得一种执行能力,再用权重合并 + 策略蒸馏整合成单一推理时模型,从而兼顾"能力从哪来"的可审计性与"推理时只有一个模型"的简洁性。
(a)统一的多模态接口与双规模骨干。 两条轨道均基于 Qwen 视觉-语言系列(35B-A3B 为 MoE,每次推理仅激活约 3B;2B 为稠密模型),采用标准 ViT–LLM 结构,暴露相同的自回归接口、遵循相同的后训练配方。所有任务都被建模为文本生成、无需任务特定解码头:点 / 框 / 轨迹以归一化坐标输出,时序跨度以起止时间输出,状态判断以结构化字段输出——这种统一的、可解析的输出格式是后续可验证奖励与能力审计的前提。
(b)执行中心的四类能力。 训练数据按"在执行循环中被反复调用"的功能角色组织为四族:空间推理(场景几何与实体关系)、时序理解(事件进展与变化时刻)、动作引导(锚定实体 / 可供性,产出点、区域与有序轨迹)、状态验证(判断物理谓词是否成立、目标是否达成)。同一族内的多种输出格式(指向、可供性定位、轨迹预测)作为互补形式,而非独立专家分支。
(c)从专家到统一:为何"先获取、后整合"。 四族能力在监督信号与输出格式上差异巨大,用单一无差别配方联合训练易产生优化干扰。因此把"能力获取"与"能力整合"分离:四个专家从同一骨干检查点出发,用各自原生监督与 GRPO(带可验证奖励)独立后训练,得到参数兼容的检查点;随后用 TIES 合并任务向量以初始化统一学生,再用路由式 MOPD(routed Multi-teacher On-Policy Distillation)在学生生成的前缀上,由对应专家作为教师巩固行为。专家路由只在训练期使用,推理时仅用单一自回归检查点。

▲ 执行中心的能力视图。一个 BEHAVIOR-1K 家务操作轨迹展示了空间、时序、引导与状态四类需求如何在一个"观测–推理–动作"循环中反复出现并相互重叠,而非形成互斥的阶段。

▲ 能力专门化与整合。四个专家从共享骨干获取互补的、面向执行的能力;TIES 合并它们的任务向量,路由式 MOPD 进一步巩固为统一模型。
笔者理解。 Capek 0.5 的巧思在于把"一个全能 VLM"拆成"四个可审计的专家 + 一个整合后的统一模型",既不牺牲多能力的专业性,又避免推理期维护多套系统的开销。TIES 负责把专家能力"装进"统一学生,MOPD 再针对学生实际生成的前缀做定向蒸馏,路由机制保证每个样本只向最相关的专家学习——这比简单平均权重或纯联合训练更能保住长尾能力。对工程落地的启示是:当任务能力异构且难统一监督时,"分而治之 + 受控整合"往往比端到端一把梭更稳。
实验结果
我们从"公开基准对比、受控能力保持分析、仿真闭环"三层面评估 Capek 0.5,这里保留最具代表性的结果与消融。
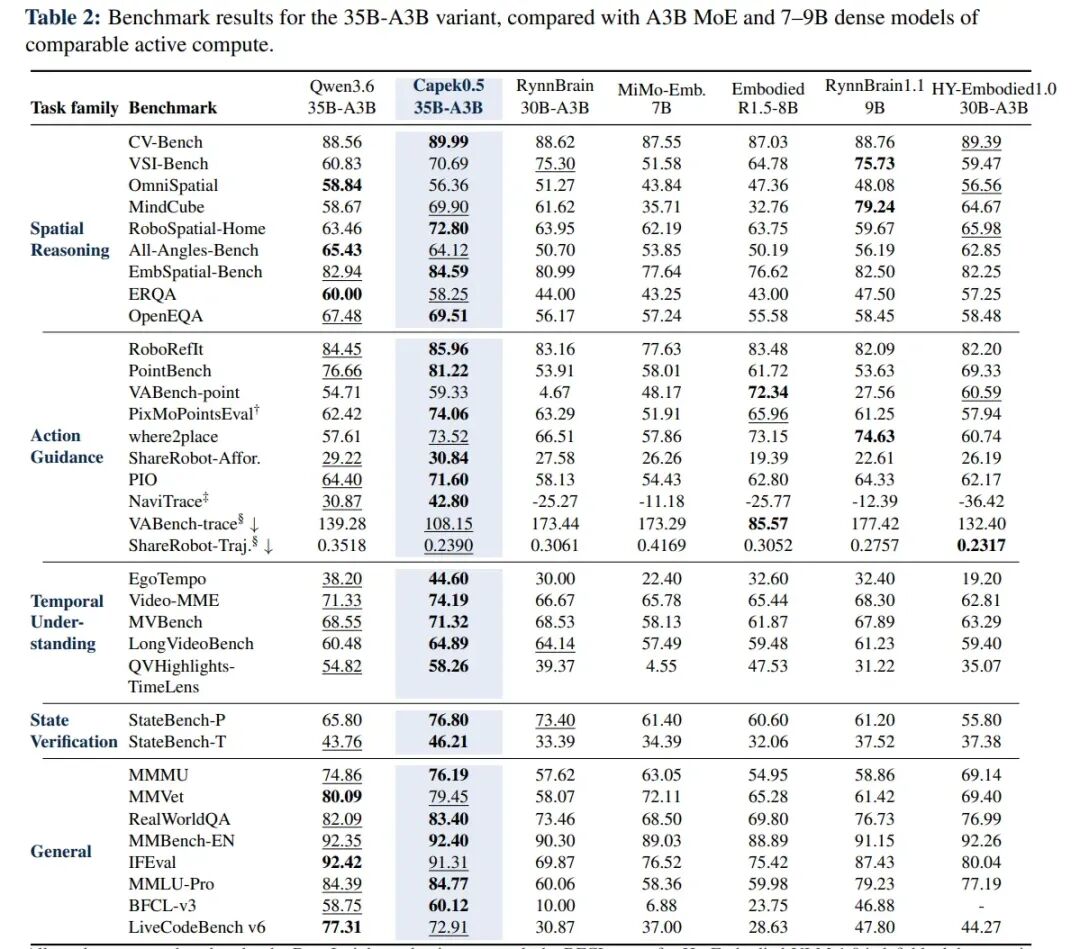
▲ 35B-A3B 主轨道基准结果,与活跃计算量相当的 A3B MoE 及 7–9B 稠密模型对比(含 Qwen3.6、Capek 0.5、RynnBrain、MiMo-Emb.、Embodied RynnB 等)。

▲ 2B 主轨道基准结果,与参数至多 4B 的模型对比(含 Qwen3.5、Capek 0.5、RynnBrain1.1、RoboBrain 等)。
主基准(Table 2 / Table 3)。 相对协议匹配的 Qwen 初始化,Capek 0.5-35B-A3B 与 Capek 0.5-2B 分别改善了 28/34 与 30/34 个匹配基准行,在通用视觉-语言理解与空间、时序、动作引导、状态验证四类具身能力上均显著提升;2B 小模型同样稳定受益,验证了同一构建可跨容量区间迁移。

▲ 在能力特定的 35B-A3B 基准套件上的能力专门化与整合。所有变体均从同一 Qwen3.6-35B-A3B 检查点初始化。
受控整合分析(Table 4)。 四个专家在八个代表性基准上均较共享起点显著提升(如 MindCube +12.85、VSI-Bench +10.16、EgoTempo +12.60、StateBench-P +14.20,VABench-trace RMSE 降 38.85)。对比整合路线:TIES+MOPD 取得最佳整体折中——在 MindCube、VABench-trace、StateBench-P 上拿第一、其余五项均列第二,相对仅用 MOPD 在 8 项中改善 7 项;而单独 TIES 或单独 MOPD 都存在能力偏置与回退,证明"先获取、后整合"的分离设计必要。
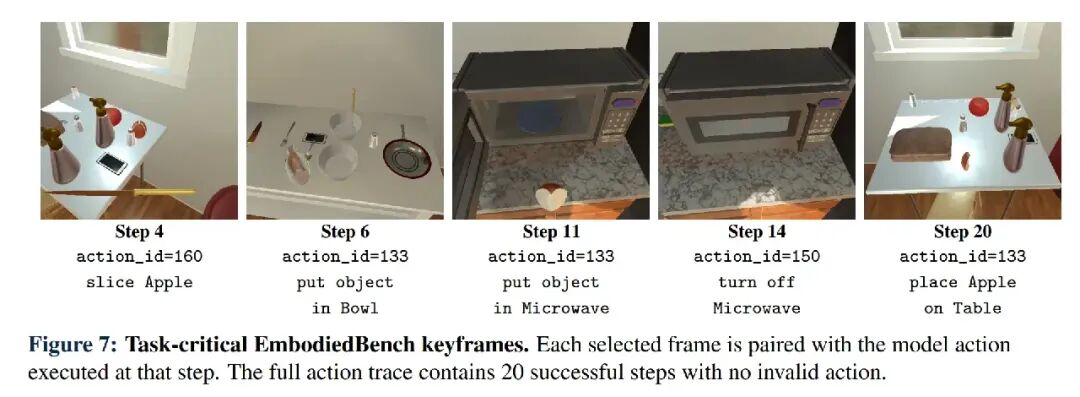
▲ 任务关键的 EmbodiedBench 关键帧。每个被选取的帧都配有在该步执行的模型动作;完整动作轨迹含 20 个成功步骤且无噪声干扰。
闭环定性。 在严格留出、未参与训练的 EmbodiedBench(EB-HAB / EB-ALF,各 300 个多步片段)上,Capek 0.5-35B-A3B 的平均成功率从 Qwen3.6 的 46.0 / 50.7 提升到 63.0 / 55.3,说明四类能力能在任务执行中被有效组合。
总结 & 未来工作
我们提出了 Capek 0.5,一个面向执行中心具身推理的统一视觉-语言模型。其后训练配方从共享检查点衍生出空间推理、时序理解、动作引导与状态验证四个专家,将每个专家的训练匹配到其原生监督信号与输出契约,并通过权重空间合并接路由式策略空间蒸馏,把它们的行为整合为单一推理时模型。该设计以执行循环中反复出现的证据需求作为组织原则,既不施加僵化的阶段式分解,也不把 VLM 当作低层控制器。
我们从三个互补层面评估了这一设计:2B 与 35B-A3B 两条轨道的公开基准对比、从专家到统一模型的受控能力保持研究,以及仿真具身环境中的闭环评估。这些评估共同串联起广义具身能力、专家到统一的保持,以及交互式任务执行中的能力组合。
展望未来,我们旨在把 Capek 0.5 从一个统一的具身推理器,扩展为一个通过工具进行感知、编排与行动的智能体式具身大脑:用于获取任务相关证据的感知工具、作为长程分解与恢复的程序化编排层的可执行代码,以及暴露机器人技能、把低层控制留给专用策略的动作工具。在这种设定下,工具调用成为执行循环中的一等公民动作,模型必须决定何时、调用哪些工具,把调用组合成可执行工作流,解释反馈,并在结果偏离预期时重新规划。我们计划通过新的专家获取这些能力,并在本报告确立的、可追溯的"专家到统一"协议下对其进行整合,评估也将扩展到更长程的交互式任务与物理机器人场景。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。