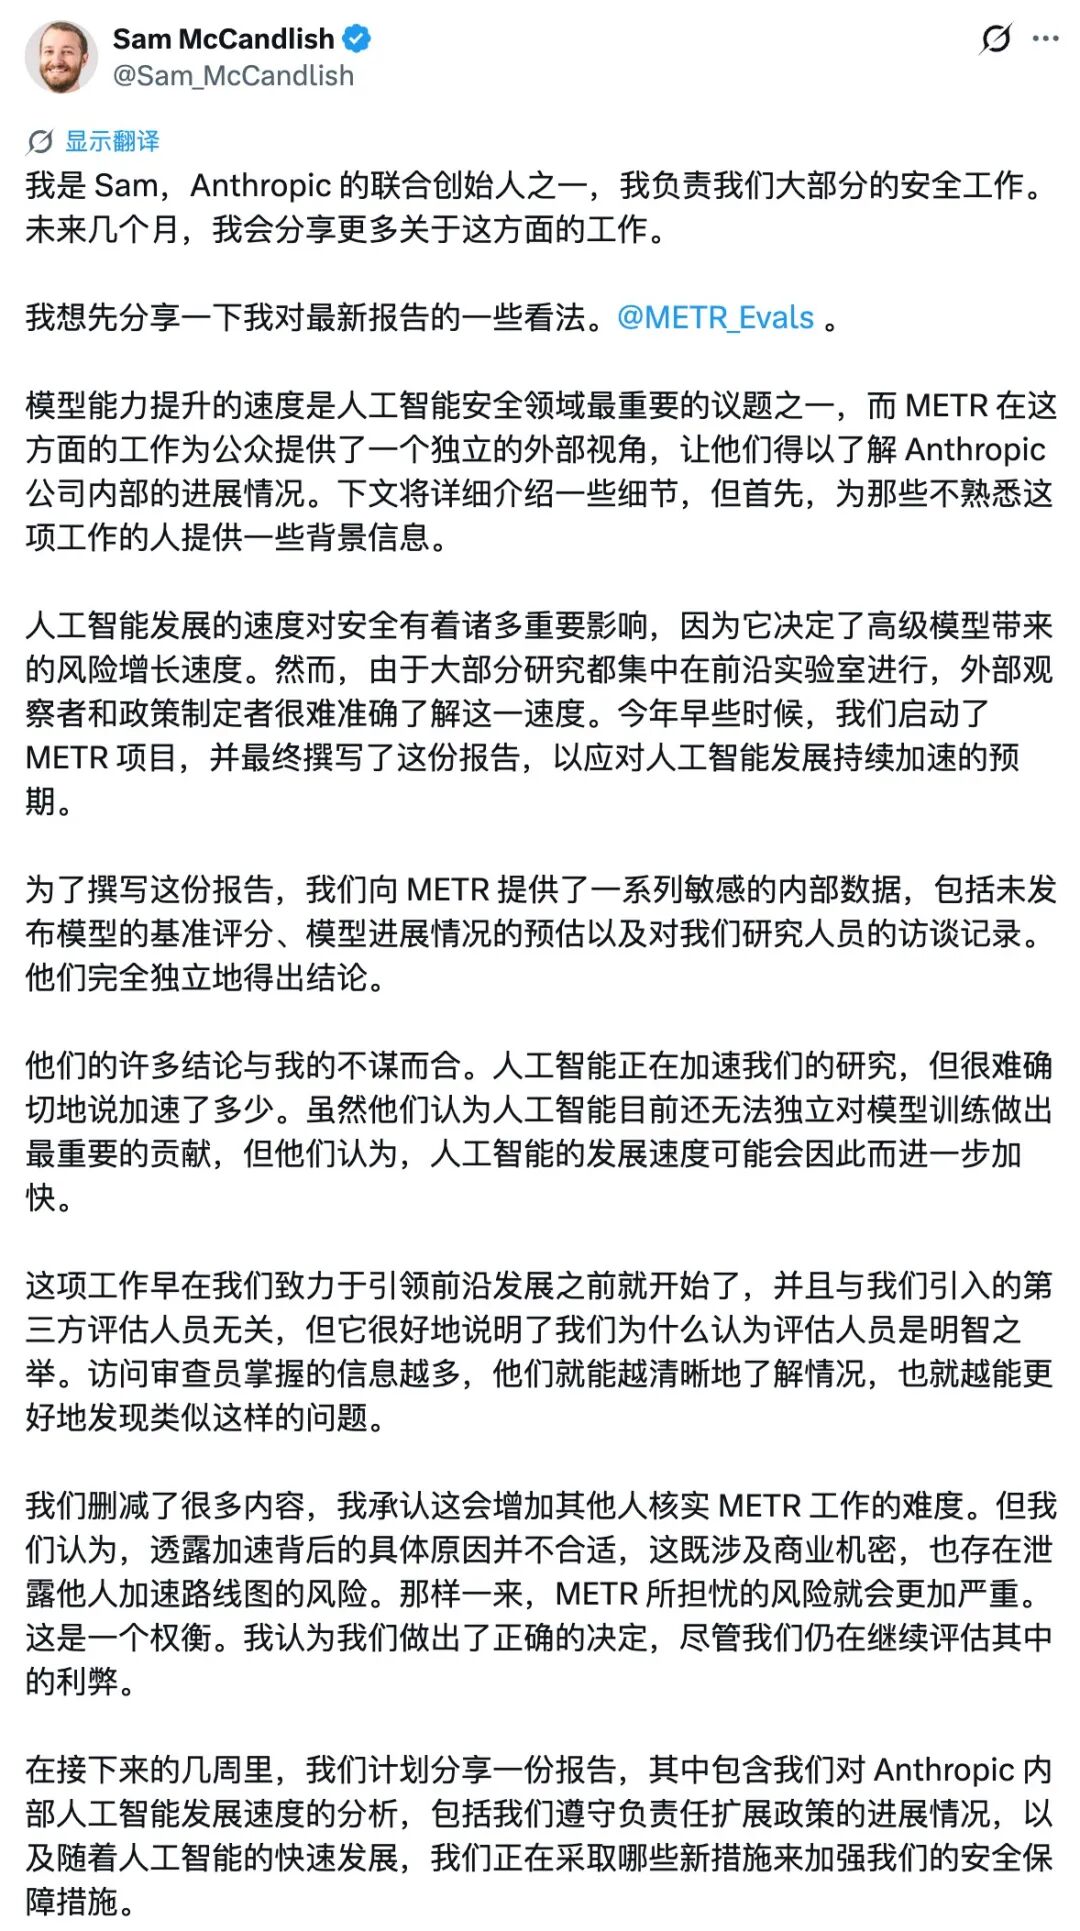
AI 自己加速研发自己,终于有了第一份动真格的第三方摸底报告。就在刚刚,独立评估机构 METR 甩出了一份重磅调查报告,首次把 Anthropic 内部怎么用 AI 搞研发的家底给掀开了一角。图|官方博客🔗 https://metr.org/blog/2026-11-05-anthropic-ai-rd-acceleration-assessment/结论相当唬人。从去年 10 月到现在,Anthropic 模型能力的进化速度直接翻了近一倍,相当于只用过去 1 年时间,硬生生干完了以前 2 年的研发进度!而且这波提速里,大概有八成功劳,全靠他们内部员工高强度拿 Claude 给下一代 Claude 打工。上下滑动查看更多内容更有意思的是,在 METR 驻场查了 11 周、交出一份上百页的完整报告后,Anthropic 居然动用一票否决权,把里面最核心的证据和未来模型预测全给涂黑打码了。。。至于打码的理由嘛……官方原话是,怕这些机密数据流出去,不小心帮隔壁友商也给加速了(doge)。
一年干完两年的活,还不靠堆算力
事情是这样的。从今年 8 月 12 日到 10 月 29 日,METR 派出评估团队正式进驻 Anthropic,开启了一场为期 11 周的高权限审查。在两个多月里,评估人员拿着 Anthropic 提供的工作设备和免费 Token,调阅了从预训练、强化学习、各领域训练算力到内部模型跑分的一手资料。几款从未对外公开的内部模型,也顺势浮出了水面。原来在大家熟知的公开模型之外,Anthropic 手里还捏着三个今年刚训完的内部版本,代号分别是 7 月训完的 Model 2、8 到 9 月训完的 Model 3,以及 9 到 10 月刚刚出炉的 Model 4。把这些内部模型拉到 Anthropic 自家的能力指数 AECI 上一测,一条极其陡峭的折线图直接跳了出来。在 2025 年 10 月之前,他们模型能力的增长斜率大概是每年 15 分,属于稳步爬坡。结果从去年 10 月 7 日这个拐点开始,斜率突然拔高到了每年 29 分,直接飙升到了历史水平的 1.9 倍。到最新的内部旗舰 Model 4,更是在全部 15 项地狱级内部基准测试里,把把得分超过 50%,强到连 METR 的评估员都开始发愁,说现有的题库已经快不够 Model 4 刷了。消息刚出来的时候,估计很多人第一反应都是,A 社是不是偷偷多买了 GPU,靠大力出奇迹把分数给堆上去的?但 METR 在核查了内部算力账本后,给出了一个非常明确的排除项。这次提速,并不是靠加快训练算力的扩张堆出来的。虽然具体各环节的算力账本被 Anthropic 给打码隐去了,但评估团队反复核实后确认,训练算力的增长速度压根没变。真正让研发进度原地起飞的,就是 AI 自己。
拿 AI 狂刷实验,写代码不再是瓶颈
为了搞清楚 Anthropic 研究员平时到底怎么压榨自家模型,评估团队深度访谈了约 15 位一线核心研究员,并调取了内部 Slack 的效率调研记录。结果你猜怎么着?在 Anthropic 内部的 Slack 效率调查中,员工们对 2026 年 10 月最强内部模型给出的平均提效估计,居然达到了惊人的 12 倍。。好家伙,难怪平时给咱们普通订阅用户的额度抠抠搜搜,合着好东西全留着在内部自己猛猛蹬了是吧 o(╥﹏╥)o。当然了,顺手点个投票难免有点水分,相比之下,一线研究员在深度访谈里吐露的工作变化要扎实得多。有位研究员直接摊牌,说以前大家有个新点子,光写代码搭实验就得耗上一两天,很多人嫌麻烦干脆就不试了。现在倒好,有了 Mythos Preview 配上内部的智能体脚手架,写代码本身已经不再是阻碍了。平时开会汇报实验结果,大伙儿连 PPT 都不做了,直接甩一个智能体运行记录的链接出来,一次同时往脚手架里狂塞 10 个想法,哪个跑通了就用哪个。另一位研究员更是凡尔赛,说自己现在的产出起码翻了三倍,感觉每天上班就像身后突然多了好几个博士后和研究生在免费打杂。不过,这帮挑剔的顶级研究员在捧自家新模型的时候,也没忘了把前几代模型拉出来鞭尸。有人在访谈里毫不留情地吐槽,说在 Opus 4.5 之前,Claude 在自主写代码这块基本就是个摆设,到 Opus 4.6 才勉强能写上两笔,直到今年 4 月的 Mythos Preview 和 7 月的内部 Model 2 出来,才真正迎来了质变拐点。至于外界最关心的全自动 AI 研发,报告指出,目前核心训练环节主要还是靠 AI 给人类打辅助,尚未实现完全自主的重大突破,但部分管线已经出现了明显的自动化苗头。并且从算法、训练算力、实验算力到数据储备,评估团队在未来 12 个月内并没有看到任何会明显拖慢这波增长的硬性瓶颈。
满屏马赛克的「透明报告」
尽管报告最终得出了接近 2 倍加速的判断,但 METR 全篇都在坦诚强调评估背后的不确定性。按照双方的合同,Anthropic 拥有对所有非公开信息的单方面涂黑权,而 METR 唯一保留的倔强,就是可以在报告里公开喊话,告诉大家「这里被涂黑了」。于是,我们就在这份公开报告里看到了一副极其滑稽的画面。中间过程指标?涂黑。算法效率提升估算?涂黑。预训练和强化学习各环节的 AI 贡献拆解?涂黑。就连下一代神秘新模型的预测跑分,以及原本合同里写好要查一查「A 社到底把多少算力分给了安全、多少分给了刷榜」,也在评估中途被 Anthropic 一纸通知直接取消了。。。METR 在报告开头幽幽地倒了一肚子苦水,说虽然我们拿到了远超预期的内部资料,但最能支撑核心结论的大部分关键证据全被 A 社给抹掉了,导致公众根本没法自己看证据下判断,只能干瞪眼信我们的主观结论。甚至在报告末尾的利益冲突披露里,METR 还自爆了两个有趣的八卦。一是评测组里有位老哥,刚进场那会儿居然正在跟 Anthropic 谈入职 Offer,手里甚至还捏着前东家也就是 A 社死对头的期权,吓得团队赶紧安排另一个毫无瓜葛的同事把他写的每一行字都重新查了一遍(后来这老哥把 Offer 给拒了)。二是 METR 自己也承认,为了拿到内部资料、处理海量访谈和画图,他们这次绝大部分的数据分析工作,其实也是用 Anthropic 免费提供的 Claude 跑出来的。以至于他们还得在报告里专门写上一节,一本正经地论证「Claude 会不会在帮我们分析数据时偷偷美化自己,联合东家把我们给忽悠了」。。。一边请第三方进门做独立安全摸底,一边把最猛的底牌全给捂得严严实实,生怕隔壁 OpenAI 抄了作业。不过想想前几天 Claude Code 四员大将刚集体跑路、二号位 Cat Wu 直接带着满脑子秘籍投奔了 OpenAI,A 社这波防贼一样的疯狂打码,好像突然就变得合理起来了(bushi。至于报告中那款在 15 项基准测试里全部拿到超过 50% 成绩的 Model 4,外界目前仍然无法亲自体验。更吊人胃口的是,METR 已经看到了 Anthropic 对未来模型能力的预测,但相关结果同样被列入了不允许公开的机密信息。看来,Anthropic 内部的 Claude,确实还有不少没有摆到公众面前的底牌。我们正在招募伙伴📮 简历投递邮箱hr@ifanr.com✉️ 邮件标题「姓名+岗位名称」(请随简历附上项目/作品或相关链接)