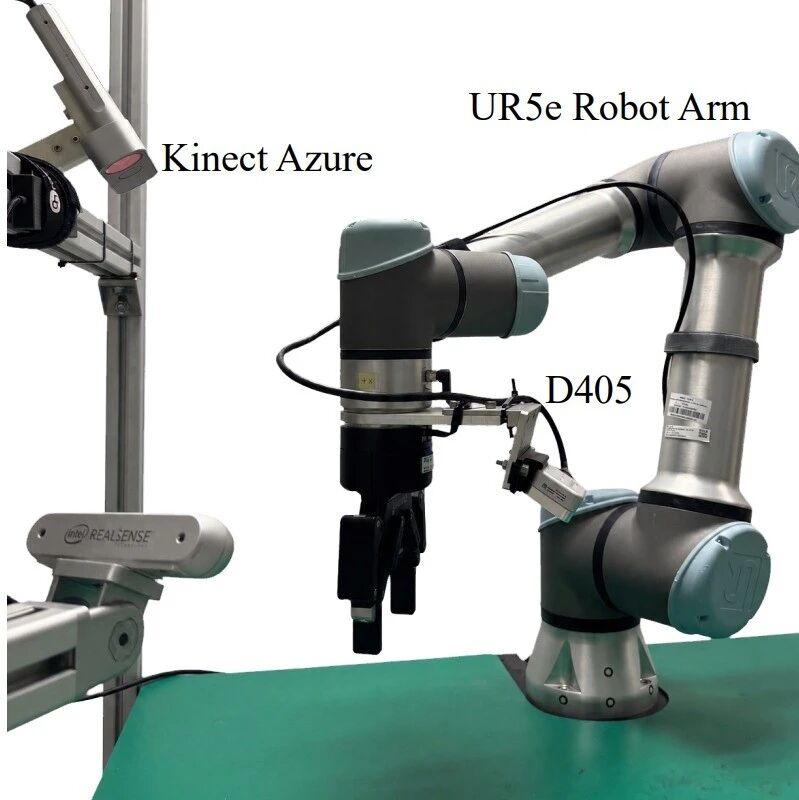
机器人伸手去抓桌上的果蔬,研究人员却把目标挪到了另一处。它还能重新找准位置,完成抓取、双手交接,再把物体放进碗里吗?
目标的位置变了,机械臂也得跟着调整。要完成这样的操作,模型需要判断物体与夹爪之间的距离和方向,并据此生成新的动作。

香港科技大学(广州)等机构的联合研究团队提出了 SLA(Spatial-Language-Action,空间—语言—动作模型):它以已有的视觉语言动作模型(VLA)π0.5 为基础,通过三维空间监督,让模型在学习操作示范时,同时学习物体、夹爪和环境之间的空间关系。
训练分两阶段:先用大规模机器人数据做“持续预训练”,再针对具体任务训练。这篇工作的关键,是在两个阶段都加入空间监督,让模型接触更多操作数据时,也能持续学习其中的三维空间关系。
在前面提到的目标移动测试中,SLA 完成抓取、交接和放置的成功率为 76%,π0.5 为 42%。团队还通过数据规模对照和多项真机实验,检验了这套训练方法的效果。
目前,SLA-Preview 位列 RoboDojo 真机榜单综合评分第一。
这篇工作有四个值得关注的亮点:
空间学习从持续预训练开始。 在大规模操作数据上加入三维空间监督,并在具体任务训练中继续使用。 同样增加数据,成功率提升更明显。 在仿真对照实验中,持续预训练数据从5%增至100%时,SLA 的成功率提高了23.1个百分点,未加入空间监督的对照提高了4.4个百分点。 八项真机测试,平均成功率达到83.8%。 比 π0.5 高出24个百分点,测试涵盖目标移动、桌面升降等情况。 辅助的三维模型只参与训练。 机器人执行任务时,无需再使用这部分模型及相应的辅助模块。
目前,论文、代码与模型权重均已公开,团队还提供了训练组件和真机示例数据,相关入口见文末。
01 用三维模型当“空间老师”
SLA 在训练中引入三维感知模型 OmniVGGT,为动作模型提供空间监督。
团队固定 OmniVGGT 的参数,让它从训练图像中提取包含几何结构的特征。如果数据还提供深度、相机参数等信息,也一并用于生成空间特征。只有普通彩色图像的数据,同样可以参与训练。
动作模型则同时完成两项学习:预测与示范一致的动作,以及让自身的视觉特征接近 OmniVGGT 提供的空间特征。后一项训练,就是论文中的“空间对齐”。
空间监督作用于模型内部的视觉特征,让它在学习动作时,更充分地保留与位置、距离和几何结构有关的信息。

将这套方法用到大规模数据上,还需要处理不同数据来源之间的差异。团队整理了六个公开数据源,统一其中的末端执行器状态、动作表示和坐标约定,使不同机器人的操作数据能够共同用于训练。
不同场景的图像差异,也会影响模型内部各层特征的作用。SLA 根据当前特征,动态组合多个层的视觉信息来接受空间监督,避免始终依赖某一个固定层。
对于部分训练样本,团队还会屏蔽整段机器人状态输入,同时保留图像和任务指令。这样做是为了减少模型对示范中固定状态与动作对应关系的依赖,促使它更多利用视觉线索。部署时,机器人状态仍然正常输入。
OmniVGGT、特征对齐模块和多层特征选择模块都只用于训练,机器人执行任务时无需再使用它们。
为了检查视觉特征中保留了多少空间信息,团队固定动作模型,只训练一个读取这些特征的深度预测模块。从下图可以看到,加入空间对齐后,预测出的物体轮廓和远近层次更接近参考深度图。这项分析直观展示了模型视觉特征中的场景结构。

02 为什么要把空间学习提前到持续预训练?
一段抓取示范同时记录了两件事:机械臂怎样运动,以及物体、夹爪、桌面处于怎样的相对位置。VLA 根据图像、任务指令和机器人状态学习动作。但仅靠动作预测训练,模型未必能充分学到画面中的三维结构。物体换了位置、观察角度发生变化之后,原本有效的动作也就未必适用。
团队此前的方法 Spatial Forcing,已经尝试在具体任务训练中加入空间监督。SLA 将这一步提前到了持续预训练,并在后续的任务训练中继续保留。
这个调整扩大了空间学习所能利用的数据范围。模型先在多来源的机器人数据上学习,接触不同的物体、场景、视角和机器人,再针对具体任务进行适配。三维空间信息可以在这两个阶段持续参与训练。
空间能力能否随着操作数据的增加而提升,是这篇工作重点验证的问题。
03 数据扩至20倍,为什么成功率差这么多?
同样把持续预训练数据量扩大到原来的20倍,未加入空间对齐的对照,平均成功率提高了4.4个百分点;两个训练阶段都加入空间对齐的 SLA,提升达到23.1个百分点。
这组结果来自数据规模实验。团队将持续预训练使用的数据分别设为完整数据的5%、25%、50%和100%,比较四种训练方式:两个阶段都不加入空间对齐、只在持续预训练中加入、只在具体任务训练中加入,以及两个阶段都加入。四组模型都经过持续预训练和具体任务训练,区别在于空间对齐出现在哪个阶段。
评测采用仿真操作基准 RoboTwin 2.0 的 Clean2Random 设置:用标准场景训练,再到随机变化的场景中测试,统计50项任务的平均成功率。
随着数据从5%增加到100%,未加入空间对齐的对照,成功率从 43.8%升至48.2%;两个阶段都加入空间对齐的 SLA,则从 49.2%升至72.3%。

只在一个阶段加入空间对齐,也能改善结果。使用完整数据时,只在具体任务训练中加入,成功率为57.1%;只在持续预训练中加入,为63.2%;两个阶段都加入,则达到72.3%。 而且,在四种数据规模下,两个阶段都加入空间对齐的结果始终最好。
这组对照表明,增加数据的同时,持续提供空间监督,能够帮助模型更充分地利用新增的操作数据。 空间关系学得怎样,也会影响机器人能从更多示范中获得多大提升。
04 目标移动、桌面升降后,机器人还能完成任务吗?
回到开头的实验:机器人伸手抓取时,研究人员将目标移走。
SLA 在这项测试中的成功率为 76%,π0.5 为 42%。这里的成功要求机器人完成抓取、双手交接和放入碗中的完整过程。
研究人员还加入了另一种干扰:把已经放进碗里的物体重新扔回桌面,让机器人再次拾取、交接并放好。SLA 的成功率为 82%,π0.5 为 52%。
这两项测试使用的策略,来自正常抓取、交接和放置的示范训练,没有额外加入对应的干扰示范。

桌面高度变化,则进一步考验机器人能否调整抓取位置。研究人员将手表放在可升降的桌面上,在机器人抓取过程中降低桌面,再将它升起。手表与夹爪之间的高度随之改变,机器人需要及时调整机械臂的位置,才能完成抓取。 训练数据中包含手表抓取,但没有桌面升降的示范。在这项动态测试中,SLA 的成功率为78%,π0.5为44%。在另一项改变桌面固定高度的测试中,两者分别为84%和68%。

测试还包含对新物体和任务指令的适应。研究人员在桌面上放置黑色胶带和胡萝卜,要求机器人只操作指定的胶带。这两种物体都没有出现在对应的任务训练中。SLA 的成功率为 80%,π0.5 为 60%。
综合八项真机测试,SLA 的平均成功率达到83.8%,π0.5为59.8%,提高24个百分点。 每种方法在每项测试中统计50次物体操作;一次任务涉及多个物体时,每个物体分别计分。这些测试覆盖了双臂协作、空间变化、动态干扰、少量示范下的跨机器人适配,以及按照指令选择物体等能力。

团队还在多组公开基准上进行了评测。SLA 在机器人操作泛化基准 LIBERO-Plus 上的总体成功率为 87.4%。
在覆盖24项厨房操作任务的 RoboCasa-Panda 测试中,SLA 每项任务使用50条示范进行后训练,平均成功率达到68.4%,为论文所列比较方法中的最高值。这组实验进一步检验了模型在任务示范较少时的适配能力。
在覆盖三种机器人构型的 RoboDojo-Real 真机测试中,单个策略的总体成功率为 33.9%,高于 π0.5 的 12.8%。
05 让操作数据同时成为空间学习的数据
抓取、搬运和放置的示范里,本就记录着丰富的空间信息。SLA 将这些信息纳入明确的训练目标,从持续预训练开始学习,并在具体任务训练中继续强化。
这篇工作给出的证据很具体:同样扩大数据规模,加入空间对齐后,成功率提升更明显;面对目标移动、桌面升降等变化,机器人也能完成更多任务。
让机器人从更多示范中学会动作,也让它从这些示范中学会判断空间关系,是 SLA 展示的一条可行路径。当现场发生变化,这些能力能够帮助模型根据新的位置关系调整动作,继续完成手头的工作。
论文、代码与模型权重已公开,欢迎阅读原文、查看实验演示,并进一步交流。
arXiv :2611.08373
项目主页
embodiedsla.github.io
代码仓库
github.com/OpenHelix-Team/Spatial-Forcing
Hugging Face 论文页
papers/2611.08373
模型权重与相关资源
huggingface.co/collections/haofuly/sla-collection
-END-
点击下方卡片,关注【Xbotics具身智能实验室】
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀