公众号记得加星标⭐️,第一时间看推送不会错过。
Zen 6究竟有哪些变化?相比Zen 5,AMD新一代CPU在微架构层面做了哪些调整?Zen 6与Zen 6c为什么要采用不同的设计思路?
近日,Chips and Cheese在AMD In-Depth活动期间采访了AMD Zen架构最初的设计师Mike Clark,围绕Zen 6的架构演进、执行单元、缓存、分支预测以及AI计算等话题进行了交流。
Mike Clark在AMD已经工作了33年,长期参与CPU核心设计。这次采访没有停留在产品规格层面,而是深入到了处理器内部的设计取舍,也透露了AMD对下一代CPU发展方向的一些思考。
Zen 6与Zen 6c:高频设计与高密度设计的重新定位
谈到Zen 6和Zen 6c,Mike Clark首先解释了AMD为什么继续保留两种不同的核心设计。
从Zen 4开始,AMD逐渐形成了两套核心架构路线。过去,密度更高的核心主要是为了节省芯片面积,但在Zen 6这一代,AMD希望进一步挖掘高密度设计的性能潜力,而不只是增加核心数量。
Mike Clark表示,AMD现在将过去的经典核心设计视为高频率设计,而高密度核心则被赋予了更高的性能定位。
其中,Zen 6c采用了每核心4MB L3缓存的配置,一个CCD集成32个核心,L3缓存总容量达到128MB。Mike Clark特别强调,这种设计拥有非常高的IPC表现。
这也意味着,Zen 6c不再只是传统意义上为了提高核心密度而进行的精简设计。
在调度器方面,Zen 6c也进行了一系列扩充。Mike Clark解释,AMD希望Zen 6和Zen 6c在软件层面保持相似的使用体验,让针对一种架构进行的优化,同样能够适用于另一种架构。
但由于Zen 6c的目标工作频率相对较低,它有更多空间增加内部队列容量。例如浮点调度器,以及核心内部其他一些队列,都进行了扩充,以进一步提高IPC,并改善SMT环境下的资源利用效率。
前端架构:让双解码发挥更大作用
Zen 5引入了双基础块取指设计,能够同时获取两个基本块。这是此前架构的一项重要变化。
但Mike Clark指出,在运行指令规模较大的工作负载时,处理器可能需要同时从L1指令缓存和操作缓存获取指令,如何协调两路指令流并不简单。
因此,Zen 6对前端进行了大量优化,重点是提高指令交付效率,同时降低功耗。
这项工作并不是简单地增加前端带宽,而是让Zen 5引入的新架构能够更有效地发挥作用,减少不必要的功耗消耗。
整数乘法单元:从三个减少到两个
Zen 6还有一项比较有意思的变化:整数乘法单元从Zen 5的三个减少到了两个。
为什么新一代处理器反而减少了执行单元?
Mike Clark解释,这与AMD对调度器架构的调整有关。
Zen 5采用了更加统一的调度器设计,为了让调度器更容易管理,执行单元需要保持较高的一致性。当时增加第三个乘法器相对容易,也没有给整体设计带来太多复杂性。
但在Zen 6中,AMD认为,要进一步扩展架构,需要重新采用分布式调度器,让不同的调度器负责向ALU分配任务。
与此同时,AMD发现Zen 5增加第三个乘法器后,并没有带来明显的性能收益。因此,为了优化芯片面积和调度器设计,最终决定回到两个乘法器。
这一调整也体现出AMD在Zen 6设计中的一个思路:并不是所有执行单元都需要增加,关键在于实际性能收益与芯片资源投入之间的平衡。
AI计算:Zen 6增加了两个VNNI单元
这次采访中,AI计算是另一个值得关注的话题。
Mike Clark透露,Zen 6增加了两个VNNI单元。AMD之所以作出这一调整,与AI推理工作负载的发展有关。
他坦言,Zen 6是一个开发周期很长的项目,在最初设计时,团队并没有按照今天所说的Agentic AI来定义这颗CPU。当时甚至还没有多少人使用Agentic AI这个概念。
但AMD一直认为,CPU在AI计算体系中有自己的位置,包括任务编排、数据类型处理以及运行规模较小的模型。
随着AI推理的发展,AMD意识到需要增加更多VNNI计算能力。虽然当时项目已经进入较后期阶段,芯片布局也基本确定,但设计团队最终还是设法增加了两个VNNI计算单元。
Mike Clark对此表示,这是一项非常成功的调整。
他也特别强调,CPU并不是要与GPU竞争,AMD并不认为CPU需要取代GPU,而是希望CPU在AI计算体系中承担好自己的角色。
向量加载能力进一步增强
在向量计算方面,Zen 6也解决了Zen 5存在的一项限制。
Mike Clark介绍,Zen 5虽然已经具备相应的内部连线资源,但加载单元一次只能执行两次向量加载。
Zen 6则进一步优化了这些资源的使用方式,支持256位向量加载。
他解释,AMD此前已经具备支持两次512位加载的1024条内部连线,但如果要将这些资源拆分使用,而不是作为一个连续整体使用,设计复杂度就会增加。
这一功能原本也是AMD希望在Zen 5中实现的,只是当时由于架构变化较多,最终留给了Zen 6团队完成。
L2缓存带宽与分支预测继续优化
除了执行单元,AMD还对缓存带宽和分支预测进行了优化。
在Zen 5中,L2缓存有时无法持续达到每周期64字节的读取速度。Mike Clark解释,问题之一在于预取操作过多,部分命中L2缓存的预取请求占用了缓存带宽,影响了实际数据读取。
Zen 6针对这一问题进行了调整,使预取请求能够与实际数据请求更好地并行工作,减少两者之间的冲突,最终实现每周期64字节的读取能力。
分支预测方面,AMD则希望在不明显增加预测器规模的情况下,提高预测效率。
Mike Clark表示,AMD对TAGE分支预测表进行了优化,重点在于改善预测表的组织方式,提高资源利用效率。
与此同时,团队也一直在努力降低分支预测错误后的恢复时间。因为无论分支预测器多么准确,都不可能完全避免预测错误,真正重要的是预测失败后,处理器能够多快恢复正常执行。
值得注意的是,Mike Clark还透露,AMD在分支预测优化过程中已经开始利用AI辅助探索和优化。分支预测涉及大量算法和参数组合,AI能够帮助团队寻找更有效的设计方案。
更大的L3缓存,也带来了新的延迟挑战
随着Zen 6c将一个CCD的核心数量增加到32个,L3缓存的拓扑结构也随之发生变化。
Mike Clark承认,随着缓存结构容量扩大,内部物理距离也会增加。虽然先进工艺能够缩小部分结构,但物理距离增长的问题仍然无法完全避免。
AMD一方面通过内部设计手段维持L3 Mesh的带宽,另一方面在CPU核心内部增加队列容量,以应对更高的访问延迟。
对于具体实现方式,他表示其中涉及一些AMD不愿公开的内部设计细节。
此外,谈到Verano引入LPDDR5X内存时,Mike Clark表示,AMD在核心设计阶段一直非常关注每个核心能够获得的内存带宽,并确保CCD与IOD之间拥有足够的带宽。由于此前已经为MRDIMM提供了充足的带宽,因此更换内存技术并没有对核心架构设计产生重大影响。
写在最后
从Mike Clark的这次采访可以看到,Zen 6的升级并不是简单增加执行单元、扩大缓存或者提高频率,而是涉及处理器内部多个环节的重新权衡。
有些地方增加了资源,例如Zen 6c的调度器和内部队列,以及Zen 6新增的VNNI单元;有些地方则减少了资源,例如整数乘法单元从三个回到两个。前端指令交付、L2缓存带宽、向量加载和分支预测,也都进行了针对性的优化。
尤其值得关注的是AMD对CPU在AI时代定位的思考。Mike Clark明确表示,CPU不会取代GPU,但在任务编排、数据处理和小模型运行方面,仍然具有重要价值。
Zen 6的设计周期早于Agentic AI概念的广泛兴起,但AMD仍然根据AI推理的发展趋势,在项目后期调整了设计,增加VNNI计算单元。
这或许也是新一代CPU架构演进的一个重要方向:在GPU承担大规模并行计算的同时,CPU也需要不断调整自身架构,以适应AI计算带来的新需求。
附:AMD Zen 6解读
从宏观角度来看,Zen 6 是 Zen 5 的自然演进,核心中扩展了许多面向对象(OoO)结构并进行了迭代改进。
然而,深入研究后会发现并非如此,AMD 对核心的多个部分进行了大幅重构,这让我想起了 Zen 1 到 Zen 2 的变化。

从宏观层面来看,AMD 对整数调度所做的更改最为突出,回归到类似于 Zen 3 和 Zen 4 的布局。
分支预测
Zen 5 拥有我们测试过的所有核心中最好的方向预测器,而 Zen 6 似乎在此基础上进行了改进。
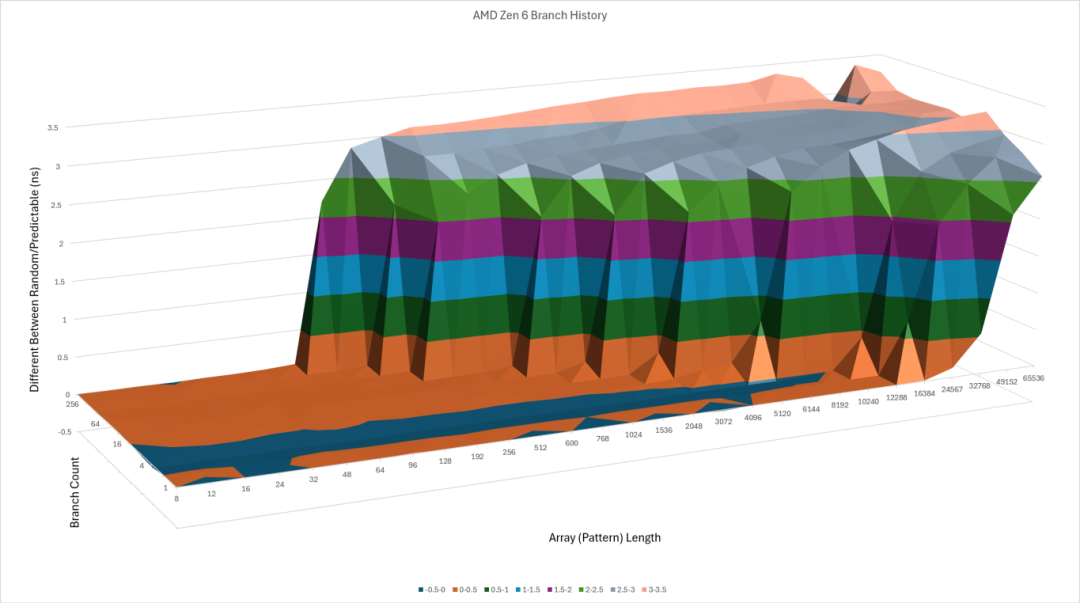

我们观察到的最大区别在于方向预测器过载后的情况。两个核心几乎都在相同的位置遇到瓶颈,一旦超过瓶颈,预测器就只能随机猜测数据,因此每个分支的执行时间主要反映了核心从错误猜测中恢复所需的时间。
在 Zen 5 上,每个分支的额外时间约为 3.5 到 4 纳秒,而在 Zen 6 上约为 3 到 3.5 纳秒,这意味着 Zen 6 每次分支预测错误所付出的代价更低,这表明与 Zen 5 相比,AMD 降低了分支预测错误造成的延迟。
Zen 6 还提高了核心在每个周期执行 2 个分支的能力,Zen 6 能够在 L1 指令缓存中每个周期执行 2 个分支。

当引脚数量超过 L1i 时,除 64B 测试外,其余 BTB 的每个周期都只有一个分支;而 64B 测试在 L2 BTB 中每个分支则有 4 个周期。
与 Zen 5 相比,Zen 6 的 BTB 似乎更注重提高 BTB 的速度,而不是增加容量。
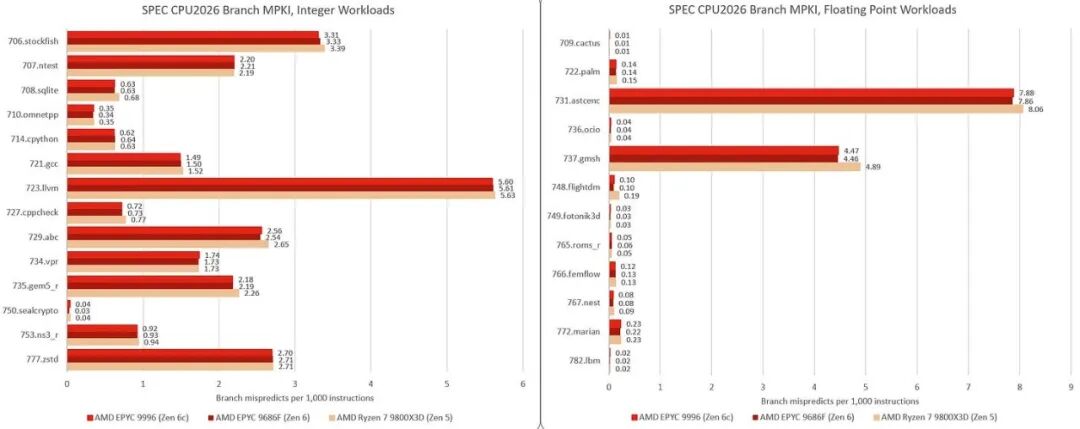
Zen 6 的分支预测单元的准确度与 Zen 5 的非常相似,而且速度更快,考虑到 Zen 5 的分支预测器已经非常准确,这是一件好事。
指令获取
Zen 6 沿用了 Zen 5 引入的双解码集群方案,但与 Zen 5 中单个线程只能有效使用单个解码集群不同,现在 Zen 6 中单个线程可以使用两个解码集群。

除了 L1i 之外,Zen 6 在指令方面与 Zen 5 的行为非常相似。
执行引擎
Zen 6 的执行引擎总体上与 Zen 5 非常相似,但有一些重要的区别需要注意。

在整数运算方面,Zen 6 恢复了 Zen 4 的 NOP 指令配对机制,每个周期最多可执行 16 个 NOP 指令。Zen 6 在简单整数指令的吞吐量方面也比 Zen 5 更接近理论峰值,在相同的六个 ALU 下,每个周期可执行 5.96 次 64 位加法运算,而 Zen 5 为 5.25 次。
AMD已将整数乘法单元的数量从三个减少到两个,PDEP和PEXT的吞吐量也从每周期三条指令减少到两条。AMD表示,Zen 5的第三个整数乘法单元的面积成本过高,得不偿失。

在向量运算方面,浮点单元保持不变,Zen 6 仍然每个周期处理两个 512 位 FADD、FMUL 或 FMA 指令。变化在于 VNNI 指令,Zen 6 将 VNNI 单元的数量从两个增加到四个,我们的 512 位 VNNI 测试结果显示,每个周期的指令数从 1.99 条增加到 3.88 条,Zen 6c 与之相当。VNNI 指令可用于计算量化推理的内循环等操作,也可用于视频编解码器中的视频滤波器。
另一个值得注意的变化是,Zen 5 每个周期已经可以执行四次操作,但我们的测试表明,无论加载的是 256 位还是 512 位数据,其中只有两次是向量加载。Zen 6 将两个核心的 256 位加载次数提升到每个周期四次,而 512 位加载次数保持不变,因此两种宽度的数据加载次数现在都达到了每个周期 128 字节。这一点至关重要,因为大多数已发布的向量代码仍然面向 AVX1/2 指令集。
乱序引擎:Zen 6 和 Zen 6c 的分裂
过去,经典核心和密集核心在架构上的区别,实际上在功能上完全相同,最大的区别在于CCD上的核心数量和每个核心的L3缓存容量。但Zen 6架构改变了这一切。
从核心内部开始,这些变化发生在微操作调度之后,并且似乎在加载队列之后结束。

Zen 6 和 Zen 6c 的主要区别在于其乱序执行结构的容量。Zen 6c 的多个乱序执行结构容量更大,使其能够同时处理更多工作并承受更高的延迟。重排序缓冲区从 576 项增加到 640 项,整数寄存器文件从 288 项增加到 352 项,向量调度器从 138 项增加到 180 项,加载队列从 280 项增加到 330 项。

这些差异表明AMD对这两种设计进行了专门优化。Zen 6似乎更适合高频,而Zen 6c则更能容忍相对较高的内存延迟。

Zen 6 和 Zen 6c 分别采用 12 核和 32 核 CCD,但两者每个核心都提供 4 MB 的 L3 缓存。这使得 12 核 CCD 拥有 48 MB 的 L3 缓存,而 32 核 CCD 拥有 128 MB 的 L3 缓存。


L3 延迟从 Zen 5 的约 47 个时钟周期增加到 Zen 6 的 55 个时钟周期,再到 Zen 6c 的 66 个时钟周期。更大的缓存和更多的网格停止点可能是造成延迟增加的原因。以纳秒为单位,Zen 6 更高的时钟频率掩盖了大部分延迟增加,其延迟为 10.7 纳秒,而基于 Zen 5 的 EPYC 9355P 的延迟为 10.3 纳秒;Zen 6c 较低的时钟频率和更大的 CCX 使其延迟达到 16.4 纳秒。


接下来我们来看看带宽方面,Zen 6 修复了 Zen 5 中 L2 缓存带宽表现异常的问题。在 Zen 5 中,核心在 L2 缓存的大部分容量下,每个时钟周期只能读取大约 42 字节;而在 Zen 6 中,读取路径现在可以稳定地提供每个时钟周期 64 字节的带宽。缓存层次结构的其他部分在每个时钟周期的带宽基本保持不变。
装载/存储
存储到加载转发似乎与 Zen 5 相同,而 Zen 6 和 Zen 6c 的行为也在此重新统一。

从同一地址加载 32 位数据与执行 64 位存储操作几乎零延迟,这使得 Zen 6 架构每个周期可以处理两对相关的存储-加载操作。完全包含在存储操作中的加载操作无论是否对齐,都能在 7 个周期内完成;而部分重叠的加载操作则需要 14 个周期,与 Zen 5 架构相同。
SPEC CPU 2026 性能
EPYC 9686F 在我们预估的 SPEC CPU 2026 单线程性能测试结果中名列前茅。它的整数运算速度与 AMD 上一代最高端客户端 CPU Ryzen 9 9950X3D2 大致相当,而浮点运算速度则更胜一筹。在相同的 4.1 GHz 频率下,尽管 X3D 架构的 9950X3D2 拥有更大的 L3 缓存,但 9686F 的整数运算速度仍比 9950X3D2 高出约 4%,浮点运算速度则高出约 11%。

EPYC 9996 的性能也毫不逊色。尽管运行频率更低,核心数量却是上一代 EPYC 9575F 的四倍,但其单线程性能与后者大致相当。此外,它的整数运算性能也略胜 NVIDIA Vera 一筹,浮点运算性能更是领先 Vera 约 20%。

EPYC 9686F 在几乎所有子测试中都领先,在两个测试套件中都比 EPYC 9996 高出约 18%。它的整数运算得分为 6.20,而 EPYC 9996 为 5.25;它的浮点运算得分为 10.6,而 EPYC 9996 为 8.99。其中,它在 714.cpython、766.femflow 和 772.marian 这几个子测试中领先幅度最大。
与基于 Zen 5 架构的 EPYC 9575F 相比,9996 在整数运算中得分 5.25,而 EPYC 9575F 为 5.13;在浮点运算中得分 8.99,而 EPYC 9575F 为 9.01,但 9996 的运行频率却低了约 900 MHz。在 721.gcc 和 765.roms 这两项子测试中,9996 的表现也略胜 9686F 一筹,而 9686F 更高的时钟频率在这两项测试中并没有带来任何优势。

对两款 Zen 6 芯片的流水线插槽进行自顶向下分析,可以揭示 9686F 领先优势的来源。在核心密集型子测试中,它们的整数速率性能曲线几乎完全相同。在 750.sealcrypto、710.omnetpp、735.gem5 和 753.ns3 测试中,两款芯片的退役插槽占比几乎相同,差异不到一个百分点。
内存密集型子测试显示出更大的差距。从 EPYC 9996 升级到 EPYC 9686F 后,后端内存停顿在 729.abc 测试中占流水线插槽的比例从 37.9% 上升到 50.0%,在 723.llvm 测试中从 19.0% 上升到 34.1%,在 708.sqlite 测试中从 24.8% 上升到 33.2%。相应地,弃用插槽的比例下降。Zen 6c 较低的时钟频率和更大的共享 L3 缓存或许可以解释其较低的内存停顿比例。
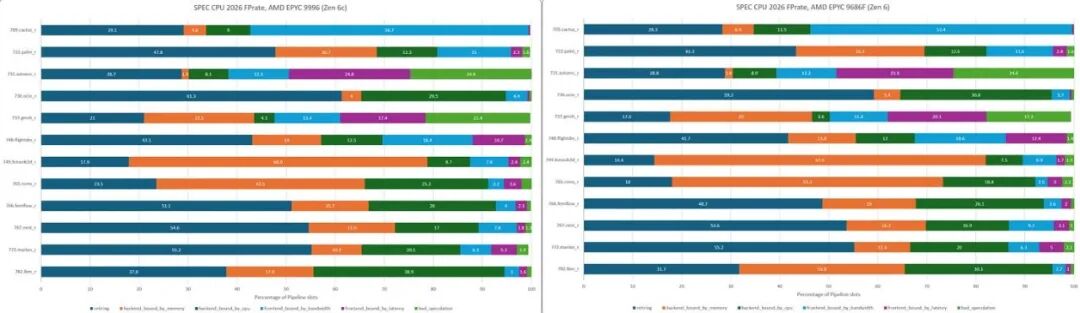
大多数子测试的浮点运算性能曲线看起来相似。731.astcenc、772.marian 和 767.nest 的退役份额相差大约一个百分点或更少,而 709.cactus 在两个芯片上都有超过一半的插槽因前端带宽不足而停滞不前。
在内存密集型子测试中,性能差距再次显现。从 EPYC 9996 升级到 EPYC 9686F 后,在 765.roms 测试中,后端内存占用率从 42.5% 上升到 55.3%;在 749.fotonik3d 测试中,从 60.9% 上升到 67.6%;在 782.lbm 测试中,从 17.8% 上升到 33.8%。在这些测试中,9686F 的更高主频优势也体现得最为明显:在 765.roms 测试中,它落后于 9996;在 749.fotonik3d 测试中,两者基本持平;而在 782.lbm 测试中,尽管 9686F 的主频高出约 29%,其性能仅领先约 11%。

将 9686F 的频率提升至 4.1 GHz 以匹配 9996 的性能后,时钟频率优势消失,整体情况发生逆转:在该频率下,9686F 的得分分别为 4.92 和 8.64,这意味着 Zen 6c 在整数运算和浮点运算方面分别领先约 6.7% 和 4%。在相同的时钟频率下,Zen 6 和 Zen 6c 在核心密集型整数子测试中表现几乎相同。在 750.sealcrypto 测试中,EPYC 9686F 的流水线插槽使用率占总使用率的 67.3%,而 EPYC 9996 则为 67.6%。在相同时钟频率下,两款芯片在多个浮点运算子测试中的表现也十分相似。在 709.cactus 测试中,两款芯片超过一半的流水线插槽都因前端带宽而停滞。在 722.palm 和 766.femflow 测试中,它们的流水线插槽使用率相差约两个百分点。
9686F 的流水线插槽在内存访问上的阻塞比例仍然较高。在 765.roms 中,后端内存阻塞占比为 50.3%,而 9996 为 42.5%;在 782.lbm 中,9686F 为 24.9%,而 9996 为 17.8%;在 749.fotonik3d 中,9686F 为 63.3%,而 9996 为 60.9%。Zen 6c 的 128 MB L3 缓存可能比 Zen 6 的 48 MB 缓存处理了更多此类请求,从而减少了对主内存的访问。
最明显的区别在于前端延迟停顿,在代码库较大的子测试中,9686F 的前端延迟停顿占比更高。在 727.cppcheck 测试中,9686F 的前端延迟停顿占比为 35.2%,而 9996 为 16.6%;在 721.gcc 测试中,9686F 的前端延迟停顿占比为 25.8%,而 9996 为 10.0%。在时钟频率相同且两款处理器使用相同前端的情况下,这些停顿很可能反映了缓存和内存层次结构的差异。
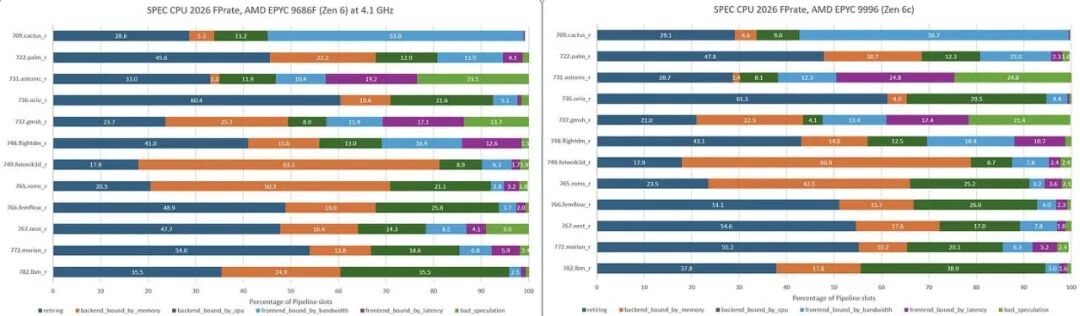
在匹配时钟频率下,两款芯片在多个子测试中的浮点运算性能曲线也十分相似。在 709.cactus 测试中,两款芯片超过一半的流水线槽位都因前端带宽而停滞。在 722.palm 和 766.femflow 测试中,它们的流水线槽位退出率相差约两个百分点。
9686F 的流水线插槽在内存访问上的阻塞比例仍然较高。在 765.roms 中,后端内存阻塞占比为 50.3%,而 9996 为 42.5%;在 782.lbm 中,9686F 为 24.9%,而 9996 为 17.8%;在 749.fotonik3d 中,9686F 为 63.3%,而 9996 为 60.9%。Zen 6c 的 128 MB L3 缓存可能比 Zen 6 的 48 MB 缓存处理了更多此类请求,从而减少了对主内存的访问。
结语
Zen 6 系列架构在多方面都超越了其前代产品。升级后的前端允许单个线程同时使用两个解码器,而更快的分支预测器则使其对预测失败的容错性更高。所有这些都与更大的 OoO 结构相结合,从而更好地隐藏内存停顿。所有这些改进共同带来了相较于 Zen 5 的代际提升。
不过,我认为更有趣的变化在于 Zen 6 和 Zen 6c 之间的区别。经典核心和高密度核心在乱序执行引擎内部有所不同,Zen 6 似乎更适合高时钟频率,而 Zen 6c 则提供了更强的延迟吸收能力。它们共享的基础架构依然清晰可见,但这些差异使得选择哪一款更多地取决于具体的工作负载特性。
性能测试结果同样令人鼓舞。根据 SPEC CPU 2026 单线程测试的预估分数,EPYC 9686F 在整数运算方面领先基于 Zen 5 架构的 EPYC 9575F 约 21%,在浮点运算方面领先约 18%。EPYC 9996 的性能与 9575F 大致相当,尽管其运行频率低了约 900 MHz,但对于这两种核心设计而言,这都是非常出色的成绩。
AMD过去对经典核心与高密度核心之争的解答是采用两种不同密度的相同核心,但Zen 6架构现在变成了两种核心,每种核心都针对其运行环境进行优化设计。这让我不禁好奇AMD在Zen 7架构中会如何布局,我们会看到基于同一基本核心设计的更精细化划分,还是会看到更大幅度的差异化设计。
(来源:Chips and Cheese)
*免责声明:本文由作者原创。文章内容系作者个人观点,半导体行业观察转载仅为了传达一种不同的观点,不代表半导体行业观察对该观点赞同或支持,如果有任何异议,欢迎联系半导体行业观察。
END
今天是《半导体行业观察》为您分享的第4591期内容,欢迎关注。
推荐阅读
★
★
★
★
★
★
★
★

加星标⭐️第一时间看推送~