今天,李飞飞创业公司 World Labs 发布了新一代世界模型 Atlas。其中一个示例是它生成的画面:李飞飞在办公室里叠衣服,效果极为真实。
李飞飞本人也开玩笑转发说:「我们办公室里确实真的在叠衣服!」
那么,Altas 究竟是什么?又是如何让数字世界的李飞飞分身如此拟真地叠衣服的?
一个模型,四种模态
World Labs 把 Atlas 称作 omni model(全模态模型),从零开始预训练,原生处理文本、图像、视频和 3D 四种数据。
官方 𝕏 上的表述是「世界上第一个能以像素级相机控制生成图像与视频帧、并将其重建为 3D 的多模态世界模型」。
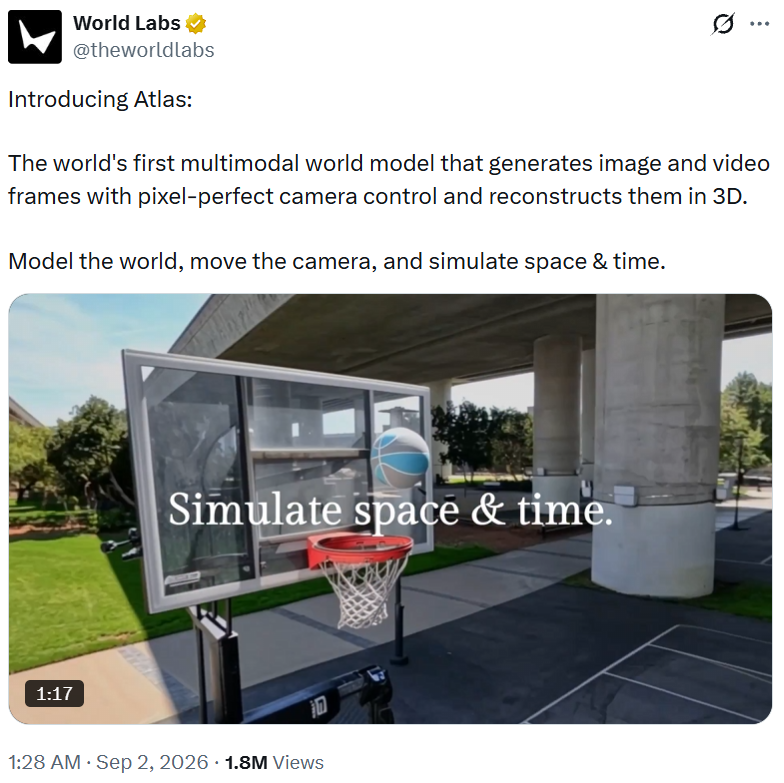
这里,我们可以看到 Atlas 的四大能力:
相机可控生成,从一到六张参考图出发,按用户指定的机位和角度生成新视角,最高输出 1440p、时长最长 1 分钟的视频。
空间重建,从一张到几十张输入图重建真实场景,既输出新视角的图像帧,也输出点云和 3D 高斯泼溅这样的显式 3D 结果。
时空模拟,从输入视频中同时建模空间与时间,用于视频重构图和机器人的 Real-to-Sim 流程。
图像生成,包括文生图和 360 度全景图。
Atlas 目前不开源,仅向少数合作伙伴开放早期访问申请,后续将驱动 Marble 及 World Labs 的其他产品。
核心设计:空间上下文
Atlas 最核心的设计,World Labs 称之为空间上下文(spatial context)。
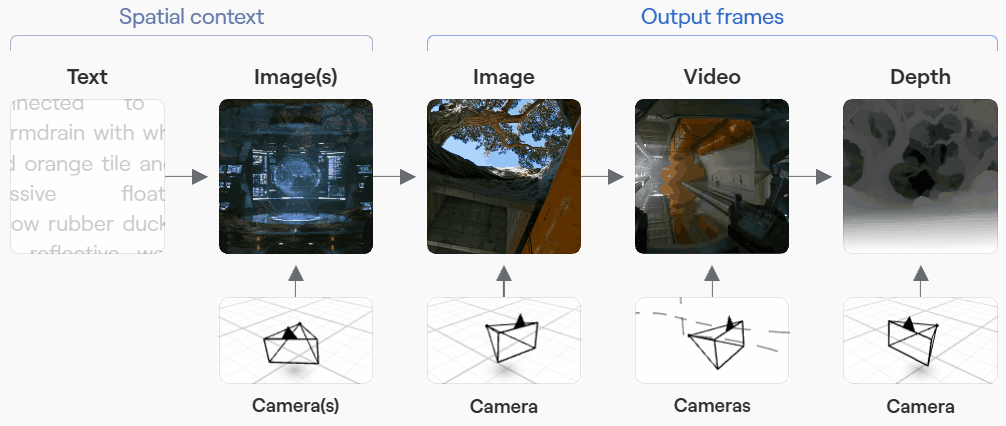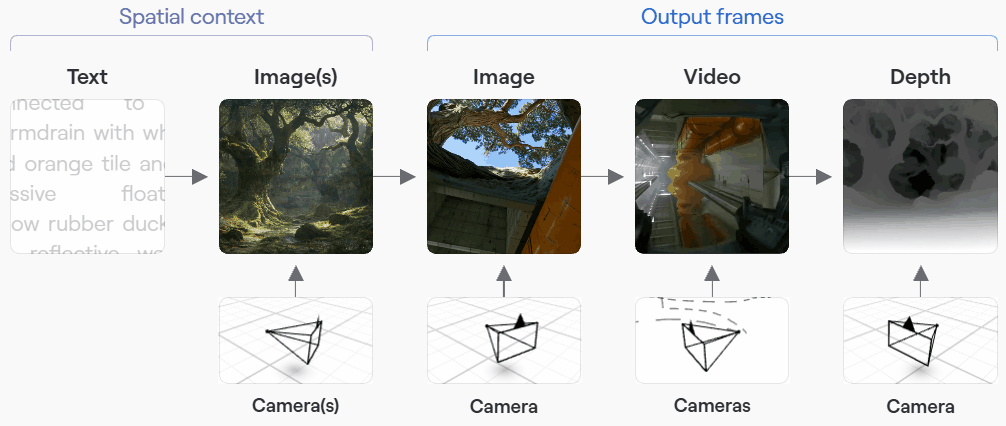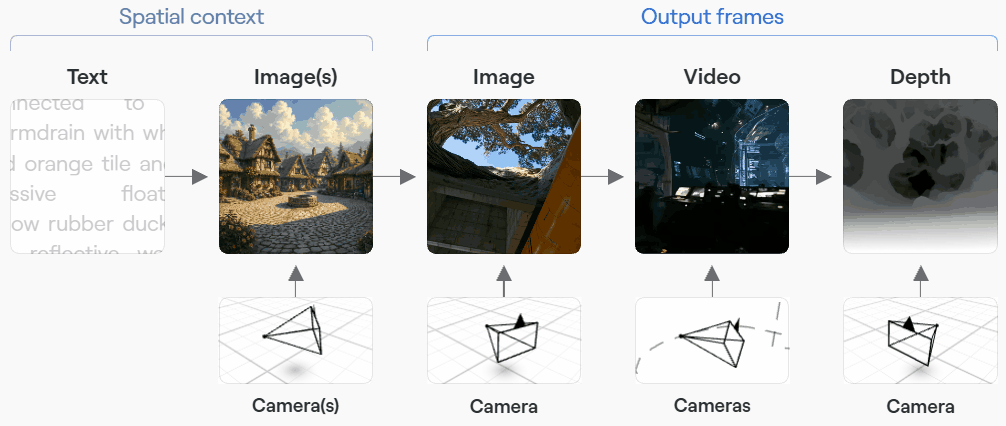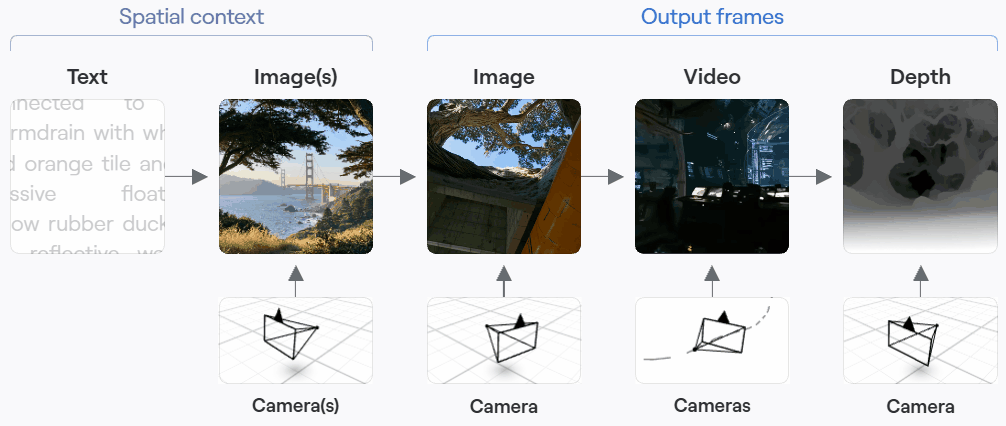
Atlas 是一种多模态自回归扩散 Transformer。其输入在三维空间中进行 grounded,以形成空间上下文,并基于该上下文生成多模态输出。
类比一下大语言模型:LLM 把输入编码成 context,再基于 context 生成后续 token。Atlas 的流程相同,区别在于,进入 context 的每一张图像都被锚定在三维空间中的一个具体位置——它带着相机位姿一起进来。
这个改动带来的直接后果是相机不再靠文字描述。过去让视频模型「向左推轨」「升降镜头」,只能把这些电影术语写进提示词里,模型理解到什么程度是个黑箱。Atlas 把相机几何做成了原生输入类型。
World Labs 表示这能让创作者「坐进导演椅,而不是在拉老虎机的拉杆」。
更有意思的是对上下文的编排。你可以往空间上下文里放两张毫不相关的参考图,并指定它们在三维空间中的相对位置,Atlas 会生成一个在两者之间平滑过渡的世界:它自己想象出门廊、走道和转角。
博客里给出了一个例子,把一张站点图片和一张地面图片拼在一起,模型补出了中间从来不存在的空间。

架构与成绩
架构上,Atlas 是一个多模态自回归扩散 Transformer,里面有多个关键词:
多模态指它原生处理文本、图像、相机位姿和深度图,视频被表示为图像序列;
自回归指输出逐个元素生成,每个任务只是一种不同的序列排列;
扩散部分采用 rectified flow,靠逐步去噪生成结果;
Transformer 骨干则保证了对现代硬件的适配。
World Labs 强调这是 LLM 和视频模型两条技术线的混合体,因此能同时吃到 KV 缓存、分离式部署这类 LLM 侧的推理优化,以及扩散蒸馏、CFG、VAE 改进这类视频侧的算法进展。
评测给出两块。相机可控生成上,World Labs 用单张输入图配一到三段电影化的运镜指令,交由第三方人类评分者盲选。结果是 Atlas 对 MiniMax H3 的胜率 75%,对 Gemini Omni Flash 81%,对阿里 HappyHorse 1.1 86%,对 FLUX 3 93%,对字节 Seedance 2.5 94%,且运镜轨迹越复杂优势越大。

需要注意,World Labs 在博客里自己写明:对比的其他模型不接受相机位姿作为原生输入,因此运镜只能通过文本提示描述。换句话说,75% 到 94% 这个区间衡量的,很大程度上是「原生相机接口」对「文本描述运镜」的差距,而不是纯粹的画面生成质量差距。因此,World Labs 并不是说「Atlas 的视频生成能力全面碾压上述模型」。
3D 重建部分。在稀疏视角重建任务上,Atlas 的平均误差(AbsRel×10⁻³)为 25.3,优于 Pi3X(posed)的 28.7、π³ 的 34.7、VGGT-Ω 1B 的 36.4、Depth Anything 3 的 39.3 和 MapAnything 的 47.7。World Labs 称所有基线结果均由自己复现以保证评测协议一致。需要注意的是,这里的对比对象被明确限定为「最好的开源专用重建模型」,而且 Atlas 并非在每一个数据集上都排第一。

至于 scaling,World Labs 的表述停留在定性层面:训练过程中做了一系列递增规模的模型,每提升一档算力都解锁了新能力。他们尚未公布参数量、训练数据规模、scaling 曲线,也没有推理成本和延迟数据。
看得越多,想象越少
World Labs 官方博客给出了大量示例,整体来看,输入图越多,Atlas 的想象成分越少。
只给一张照片时,模型会大量填补它没看到的部分。博客中的花园例子里,单张地面照片能生成一个航拍视角,花园本身还原准确,其余全靠想象。加入第二张小屋照片后,小屋出现了,但左侧的房子仍是编的。加到第三张,整个场景才对上。
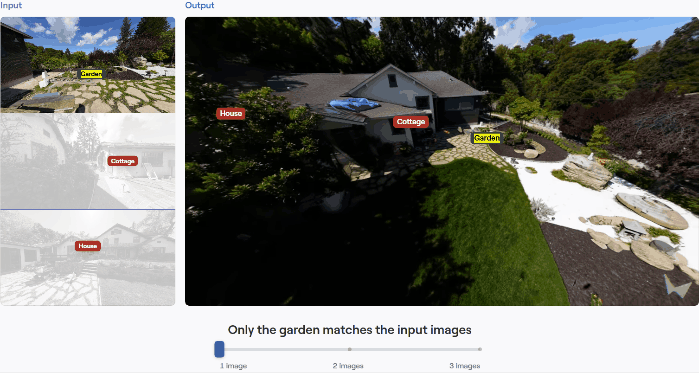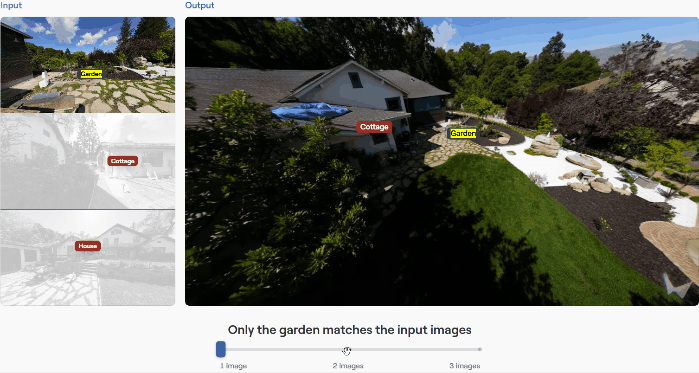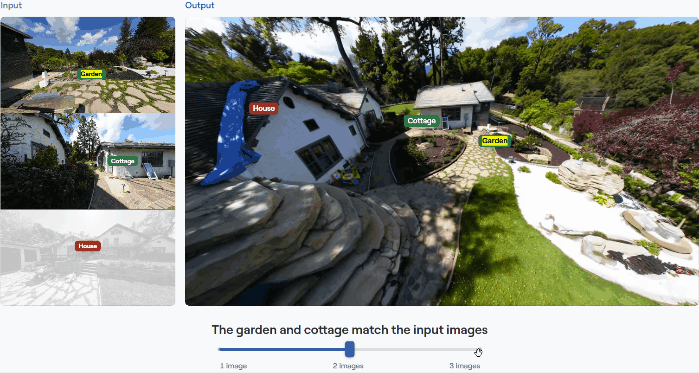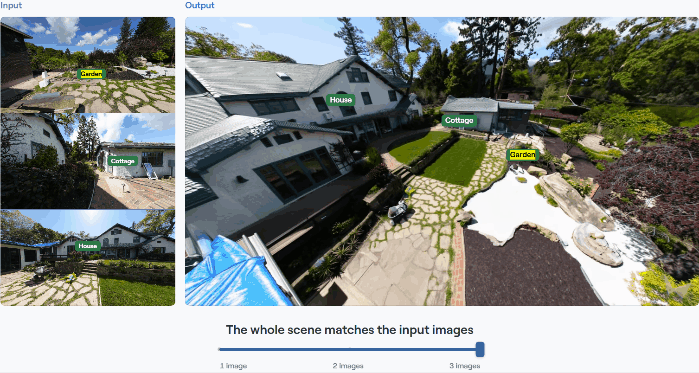
World Labs 说 Atlas 通常在两三张图时就能给出忠实重建,同时也能吃下超过一百张输入图。
比如斯坦福主方庭那个例子:只用 2 到 25 张地面拍摄的照片,Atlas 就能生成远高于校园上空的航拍飞行路径。

博客中可交互浏览的高斯泼溅场景,来自 30 张输入图。
更多示例
Atlas 还能做「子弹时间」的时空模拟。World Labs 表示,用三到五台普通相机拍摄的素材,Atlas 就能冻结时间并重新构图,从原本不可能的角度回看同一个瞬间。这些镜头没有专业摄影师,也没有专用设备。按博客的说法,是几位工程师和研究员用手机、三脚架和背包里装得下的夹具拍的。
机器人是另一条线。这也是 World Labs 今年 7 月收购仿真公司 SceniX 之后,战略方向第一次以模型形态落地。
World Labs 给出的做法是:用手机视频扫描两个大型环境,每个环境取 24 帧做重建,然后模拟不同形态的机器人沿不同路径行走,由 Atlas 生成机器人机身相机在每一步应该看到的 RGB 和深度数据。
这里的关键是世界和机器人对世界的观测来自同一个模型。传统 Real-to-Sim 流程里,环境重建和传感器渲染往往是两套系统,误差在接缝处累积。操作任务上,World Labs 称 Atlas 还能捕捉刚体、铰接体和可变形物体的交互,并支持替换物体、改变位置、调整光照和背景来批量生成变体。
最后再展示一下 3D 世界与图像生成的示例:
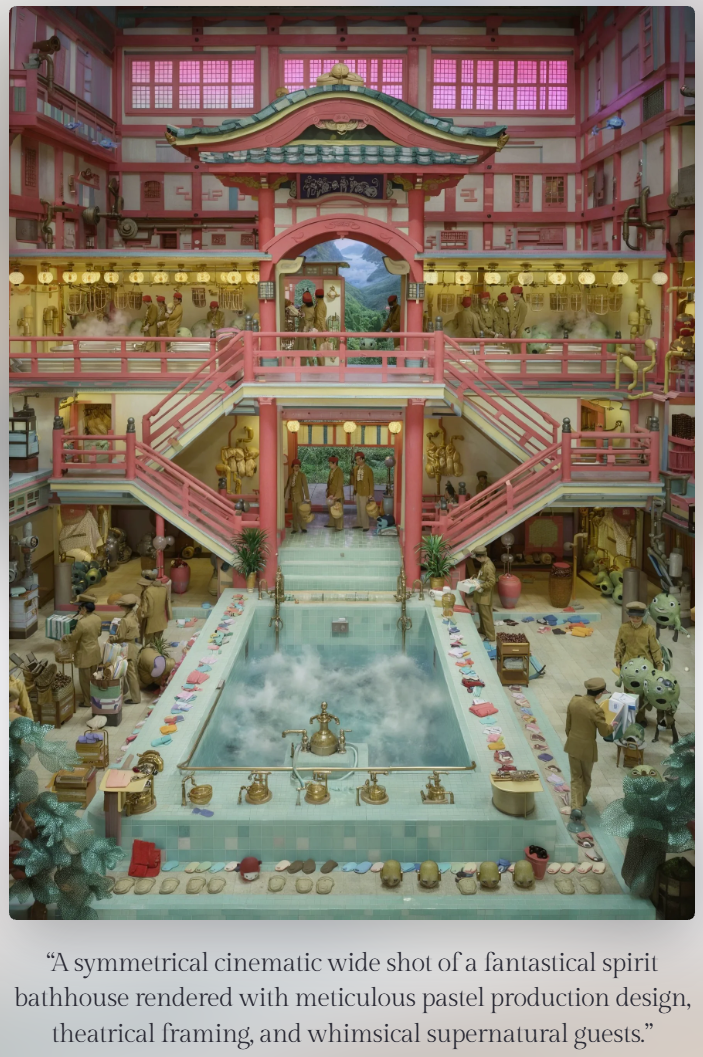


结语
把 Atlas 放回时间线里看,World Labs 的节奏相当密集。2024 年 9 月带着 2.3 亿美元融资走出隐身模式,2025 年 11 月推出首款产品 Marble,2026 年 1 月开放 World API,2 月完成 10 亿美元新融资,投资方包括英伟达、AMD、Autodesk、Fidelity 等,估值约 50 亿美元,7 月收购 SceniX,9 月发布 Atlas。
这条路径有一个清晰的转向:从「生成好看的世界」转向「生成够用的世界」。
Marble 服务的主要是影视特效、游戏和建筑可视化,视觉逼真就够了;而机器人训练要的是物理上站得住的场景,以及能被传感器读取的深度与观测。Atlas 把重建、生成和仿真收进同一个模型,让我们看到了「世界模型除了做内容,还能做什么」。
更多详情和示例,请访问原博客:
https://www.worldlabs.ai/blog/atlas

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com