点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:3D视觉硬件汇总!涵盖科研级和产品级!包括3D相机、机械臂抓取软件、手持扫描仪、无人车/机等!
一、当3D重建遇上“鱼眼”与“全景”:一个被默认忽略的假设
如果你用过Insta360或GoPro,一定体会过鱼眼镜头带来的视觉冲击——那种近乎无限的视野,仿佛把整个世界都塞进了一张照片里。但如果你的目的是从这些照片中重建3D场景,事情就变得棘手了。
现有几乎所有学习式多视图几何方法——从DUSt3R、VGGT到π³——都建立在一个默认假设之上:输入图像是经过校正的针孔相机图像。这意味着,如果你想用这些方法处理鱼眼或360°影像,必须先运行相机标定和去畸变流程,把图像“掰直”再送入网络。
问题在于,这个过程不仅引入额外的工程复杂度,还会因为去畸变过程中的信息损失而降低几何保真度。更麻烦的是,对于360°相机,一张全景图去畸变后会变成6个立方体贴图——37张全景图就变成222张透视图像,计算成本瞬间爆炸。项目页面提供的对比图直观展示了这一点:37张球面图像经过Cubemap变换后变为222张,而Wid3R可直接处理原图,效率优势明显。
有没有一种方法,能直接“吃”进畸变图像,不标定、不去畸变,就完成高质量3D重建?
这正是Wid3R要回答的问题。这项由马里兰大学和NAVER LABS合作完成的工作,被接收为ECCV 2026。它是首个支持鱼眼和360°影像的多帧前馈式3D重建网络,在Zip-NeRF鱼眼数据集上AUC@30°提升高达 +33.67 ,在Stanford2D3D 360°数据集上提升高达 +77.33。项目页面同时提供了Gradio演示和预训练模型,支持从图像集合直接重建彩色3D点云并导出为GLB。


二、背景:为什么现有方法搞不定广角影像?
2.1 传统SfM的局限
运动恢复结构(SfM)是计算机视觉中的基础问题,传统流程包括关键点检测、特征匹配、双视图几何估计、增量式三角化与光束法平差。虽然GLOMAP等全局优化方法提升了鲁棒性,DetectorFreeSfM展示了无检测器匹配在纹理贫乏环境中的优势,IM360将SfM扩展到球面相机,但大多数方法仍假设输入是校正后的针孔图像。
2.2 前馈式3D重建的进展与盲区
前馈式重建模型(如DUSt3R、Spann3R、FLARE、VGGT、π³)可以直接从图像估计场景级3D结构,无需测试时优化。Metric3D引入规范相机变换,MoGe提出仿射不变点云估计,π³通过置换等变架构减少视图顺序敏感性。然而,这些方法仍假设无畸变的透视图像和针孔相机模型,在广角影像上性能显著下降。
2.3 广角相机模型的标定困境
相机标定是恢复3D结构的关键步骤,但显式相机建模对数据采集条件敏感,复杂相机模型(Kannala-Brandt、Mei、Double Sphere等)的标定过程容易引入额外误差和不稳定性。因此,绕过显式标定、直接在网络内部建模畸变成为更具吸引力的方向。
三、Wid3R核心方法:射线空间中的相机条件化
3.1 问题定义
给定 张RGB图像 ,每张图像 ,Wid3R网络 将多视图图像序列映射为统一的3D几何表示:
其中 是相机模型token, 是相机位姿, 是每个图像位置的射线束, 是沿射线的径向距离, 是不确定性。相机模型token作为几何预测的输入条件,使网络无需显式标定即可从广角图像中稳健重建。
3.2 逐视图局部几何重建
广角图像提供大范围场景覆盖,但连续视图间视觉重叠有限。Wid3R采用置换等变网络设计,将场景几何表示在每个视图的局部坐标系中。每个点云 在自身相机坐标系中表达,通过单一最优尺度因子 对齐所有预测点云:
点云损失定义为:

3.3 射线基前馈式3D重建
所有现有前馈式方法使用点云作为输出表示,这限制了跨相机模型的泛化能力。Wid3R基于UniK3D,用球谐函数在射线束公式中表示不同相机模型,在极角 和方位角 与3D笛卡尔方向之间建立双射映射。角度模块预测球谐系数:
径向模块估计径向距离 和不确定性 。射线损失采用非对称公式:
径向损失和不确定性损失为:
位姿损失使用相对旋转和翻译误差的加权平均:
其中旋转损失为测地距离,翻译损失使用Huber损失,并将最优尺度 应用于预测的相对翻译。

3.4 训练策略与数据增强
总损失为各损失项的加权和:
权重设置为 ,,,,。
训练数据集包括TartanAirV2、ASE、Hypersim、KITTI-360、360Loc、Matterport3D、ScanNet++、EDEN、VKITTI,覆盖针孔、鱼眼和360°三类相机,其中5个合成数据集和4个真实数据集。

相机增强策略:将针孔图像转换为鱼眼模型,先反投影深度图得到点云,再重投影到随机采样的畸变相机模型,使用softmax splatting保留细节。对ERP图像,随机采样方位角和仰角进行旋转增强。
训练细节:Adam优化器,初始学习率 ,指数衰减,输入图像调整为 ,初始化π³编码器、特征聚合模块和位姿头,端到端训练。

四、实验验证:从位姿到点云到大规模定位
4.1 位姿估计:从“勉强可用”到“精准可靠”

在FIORD鱼眼数据集上,Wid3R的AUC@30°达到 100.0/93.38/68.20(RRA/RTA/AUC),VGGT为82.34/84.01/44.63,π³为85.48/87.42/48.35。在Stanford2D3D 360°数据集上,Wid3R的AUC@30°达到 94.05/93.29/79.93,而VGGT仅为19.30/33.14/2.60,π³仅为19.94/31.99/2.06。从2.6到79.9的AUC提升,意味着在360°场景下现有方法几乎完全失效,而Wid3R实现了从“不可用”到“高度可用”的质变。


4.2 点云估计:精度提升近一个数量级
在ScanNet++上,Wid3R的Acc.从VGGT的0.135降至 0.018(降低约7.5倍),Comp.从0.068降至 0.012,N.C.从0.704提升至 0.803。在Stanford2D3D上,Acc.从VGGT的0.327降至 0.094,提升约3.5倍。

Matterport3D单目深度估计定量对比。尽管Wid3R设计用于多视图,但在单视图360°深度估计上达到与SOTA相当的性能。

4.3 大规模定位:3秒完成传统方法需要数小时的工作
Matterport3D数据集大规模定位性能。Wid3R的AUC@5°达到 51.02(Scene1),而基于COLMAP的SfM方法(如Spherical COLMAP + GLOMAP)需要数小时,Wid3R仅需 约3秒。IM360虽然精度接近,但依赖密集匹配EDM,计算瓶颈显著。

五、消融实验:相机token、数据组成与帧数的影响
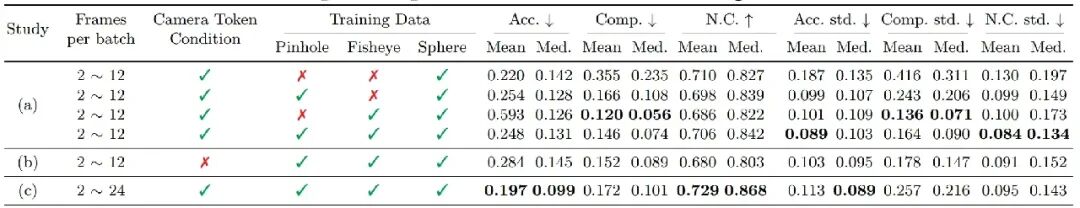
Stanford2D3D 360°设置下的消融研究。分析相机模型token、训练数据组成(针孔、鱼眼、360)和每批帧数对点云估计指标的影响。
关键发现:
联合训练不同相机模型的数据可以提升360°相机的性能,即使360°数据本身很少(不到总数据的1%),通过共享网络参数接触其他相机类型的数据,也能有效缓解过拟合并降低方差。 相机模型token作为提示词一致地提升性能,显式编码相机配置的好处得到验证。 增加每批帧数(最多24帧)可以提升Acc.和N.C. ,表明更大的多视图批次让模型学习更丰富的多视图注意力模式。
不同注意力方法的性能对比。Wid3R在径向模块中使用自注意力,相比交叉注意力版本在ScanNet++、Matterport3D和Stanford2D3D上均取得更优性能。

Wid3R基于UniK3D和π³,加入相机模型token并在径向模块中使用自注意力。与UniK3D使用DINO驱动角度模块和交叉注意力不同,Wid3R使用相机模型token并加载π³预训练权重加速收敛。

六、潜在应用:从全景生成到机器人感知
Wid3R在全景场景生成中的应用。文本描述生成全景图像和3D信息(全景深度和高斯泼溅),Wid3R在合成图像上测试,展示其可以通过提供几何token信息增强场景生成,改善生成图像的一致性。

对于机器人领域,Wid3R的意义更加直接。机器人广泛使用鱼眼相机来消除盲区,而现有SLAM和3D重建管线往往需要额外的标定和去畸变步骤。Wid3R让机器人直接使用原始畸变图像完成建图与定位,简化了系统设计,同时提升了在360°场景下的鲁棒性。
七、开源与使用
Wid3R的代码和预训练模型已全面开源:
项目页面:https://jdk9405.github.io/Wid3R/
代码仓库:https://github.com/jdk9405/Wid3R
论文:https://arxiv.org/pdf/2602.05321
环境配置
Wid3R使用Python 3.10、PyTorch 2.3.1、CUDA 12.1和Gradio 5.45.0:
git clone https://github.com/jdk9405/Wid3R.git
cd Wid3R
conda env create -f environments.yml
conda activate wid3r
交互式演示
Gradio应用接受图像集合,重建彩色3D点云并导出为GLB格式:
# 下载预训练权重 wid3r.bin 并放置于 pretrained_weights/
python demo_gradio.py
在Web界面中,上传有序重叠图像或选择内置的360°示例,选择匹配的相机模型(鱼眼或360°),调整采样间隔,点击重建即可在3D查看器中检查生成的点云和相机轨迹。GitHub仓库同时提供了多视图重建的示例脚本,支持批量处理。
八、局限与展望
Wid3R目前不支持动态场景建模。此外,尽管在360°场景下表现优异,360°训练数据仍然极度稀缺(不到总数据的1%)。作者计划在未来工作中引入动态内容数据集,并设计额外模块处理场景动态。项目页面还提到,Wid3R的几何token能力可以用于全景场景生成管线,提升生成场景的跨视图一致性,这是未来值得探索的方向。
本文仅做学术分享,如有侵权,请联系删文。
。


添加微信:cv3d001,备注:姓名+方向+单位,邀请入群。