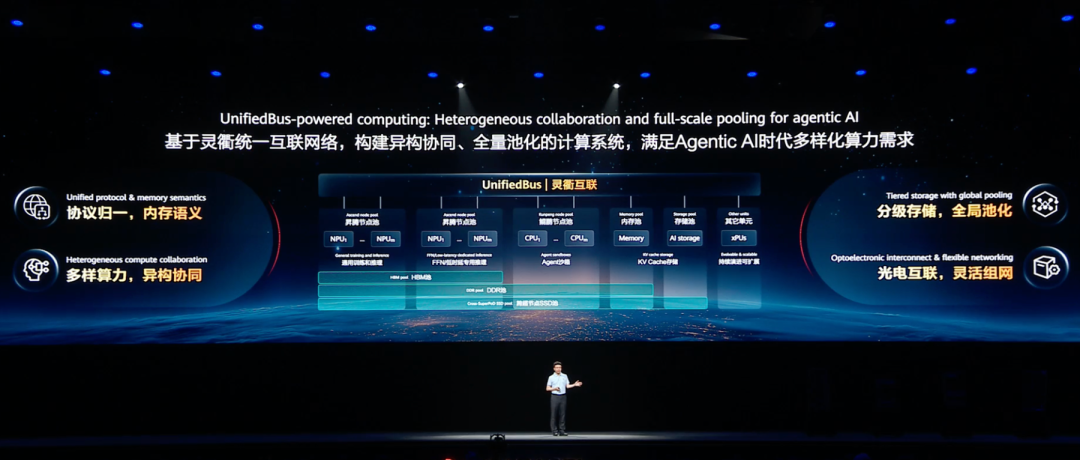
AI Agent时代,通信正在成为算力“胜负手”。现在,模型参数规模已经从万亿级走向10万亿级,未来可能进一步达到20万亿甚至50万亿;上下文长度也从几K级来到几M级,未来可能达到几十M。与此同时,人与Agent的交互频次也远高于模型。作为AI底层的计算系统,需要同步支持超大模型推理、高频次调用、多种工具使用、多层级信息传递与存储,面临诸多挑战。1、通信量平方级暴涨,10万卡MFU不足20%第一个挑战来自通信范围极速变大。数据并行域内的通信量与参数量呈近似平方关系,不可掩盖的通信时间占比成倍增加,MFU快速下降。典型MoE模型在10万卡集群上的MFU不到20%。如何打破MFU随集群规模快速下降的趋势,成为计算系统面临的第一道难关。2、一种算力喂不饱所有AI负载,异构协同与内存池化成刚需第二个挑战来自AI业务负载多样化。Prefill(预填充)与Decode(解码)呈现出不同的计算特征与访存特征,因此P、D分离,用不同算力来满足。面向未来更大模型、更低时延的推理,Decode中的Attention与FFN,由于计算与访存特征差异,用专用算力来加速可以提升效率。同时,随着Agent应用普及,CPU与NPU配比发生变化,计算系统需要异构算力协同、内存资源池化,实现动态、高效调整。3、上下文持续变长,旧互联撑不起多级缓存第三个挑战是上下文持续变长带来的存储压力。无论是训练还是推理,都必须构建层次化的多级缓存架构,包括HBM、DDR、SSD分层分级,成为必然选择。现有PCIe加RoCE网络,难以满足缓存所需要的时延与带宽需求。未来PB级的KV Cache,也需要更大的带宽、更低的时延来匹配。可以说,通信,开始成为计算系统性能的关键。它需要超强互联能力,支持异构算力高效协同和扩容;也需要打破物理极限,实现算力、内存等资源池化;还需要超大带宽和更低时延,保障计算系统的通信效率。灵衢,就是华为针对这些变化给出的架构答案。 02.一套协议打通芯片到集群灵衢四大竞争力重装算力底座