点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
一、流式重建的致命软肋:你预测得越快,错得越远
3D重建领域正在经历一场范式迁移。传统SLAM系统依赖特征匹配、三角化和后端的束调整,虽然精度可靠,但计算开销巨大;以DUSt3R和VGGT为代表的馈送式几何基础模型则用一次前向传播直接回归相机位姿和稠密几何,绕过了显式匹配和迭代优化,展现出令人瞩目的泛化能力。
但把这些模型推向流式场景时,一个根本性矛盾暴露出来:离线模型可以纵观全局再做判断,而在线系统只能基于有限的历史信息做因果决策。在动态物体、弱纹理区域或重复结构面前,有限的上下文让模型难以区分“看似相似但几何上完全不同”的观测,产生局部位姿或几何误差。这些误差在短序列上或许微不足道,但在长轨迹上会逐步累积为严重的几何畸变和尺度漂移。
现有解决思路形成了两条泾渭分明的路线。SLAM-hybrid方案如MASt3R-SLAM和VGGT-SLAM 2.0将馈送式几何先验嵌入经典建图管线,通过关键帧管理、束调整和位姿图优化反复强制全局一致性,代价是显著的迭代计算开销,削弱了馈送式推理原有的简洁性和低延迟优势。另一端的离线馈送式方法如VGGT-Long、LoGeR和Scal3R通过联合处理完整序列或重叠时间块来获取长程几何上下文,性能强劲但依赖非因果计算,无法用于严格在线场景。
近期涌现的流式重建模型LingBot-Map和HorizonStream试图在效率与精度之间寻找平衡点,维护紧凑的几何上下文实现高效在线推理。但它们本质上仍继承了一个结构性缺陷:增量位姿估计受限于有限的观测上下文,在动态物体、几何退化、弱纹理和重复结构面前依然脆弱。这些歧义引入局部几何不一致,破坏稠密点云质量;长时间累积后,局部位姿误差逐步演化为严重的尺度漂移。

SURE-Map的核心论点简洁而深刻:可靠的流式重建要求几何基础模型不仅能预测,还要能自我纠错。论文围绕两个互补的自校正机制展开。
二、跨视图几何不确定性:不问“这个深度准不准”,问“这对位姿-深度能不能对上”
传统馈送式3D基础模型中的置信度预测——无论是DUSt3R、VGGT还是MASt3R——本质上反映的是单视图几何预测的可靠性。这些模型通过负对数似然回归损失学习逐像素深度或点云置信度,用于过滤不可靠的几何预测。但论文指出了一个被忽视的问题:这些分数的原始量级在不同场景之间不可比,且它们衡量的只是“单个视图的深度预测是否可信”,而非“两个视图之间的像素对应关系在几何上是否一致”。
SURE-Map的做法完全不同。它设计了一个跨视图几何不确定性头,输入是两帧连续图像的几何token图 ,输出一个跨视图几何不确定性图 ,其中 和 分别表示水平和垂直方向的log方差图。这些方差参数化了一个对角协方差矩阵:
关键洞察在于监督信号的选择。论文不依赖任何标注的深度真值或点云真值,而是利用位姿-深度诱导光流与真值光流之间的残差来训练不确定性头。给定当前帧像素 ,用预测的深度 和相对位姿将其反投影到3D空间,再投影到上一帧,得到诱导的逆向光流 。该光流与真值光流之间的残差 通过NLL损失进行监督:
其中Mahalanobis项鼓励网络对光流残差大的像素赋予更高的不确定性,而log-determinant项惩罚“摆烂式”的大不确定性估计。训练完成后,这个不确定性头在推理时直接输出不确定性图,无需显式预测光流场。
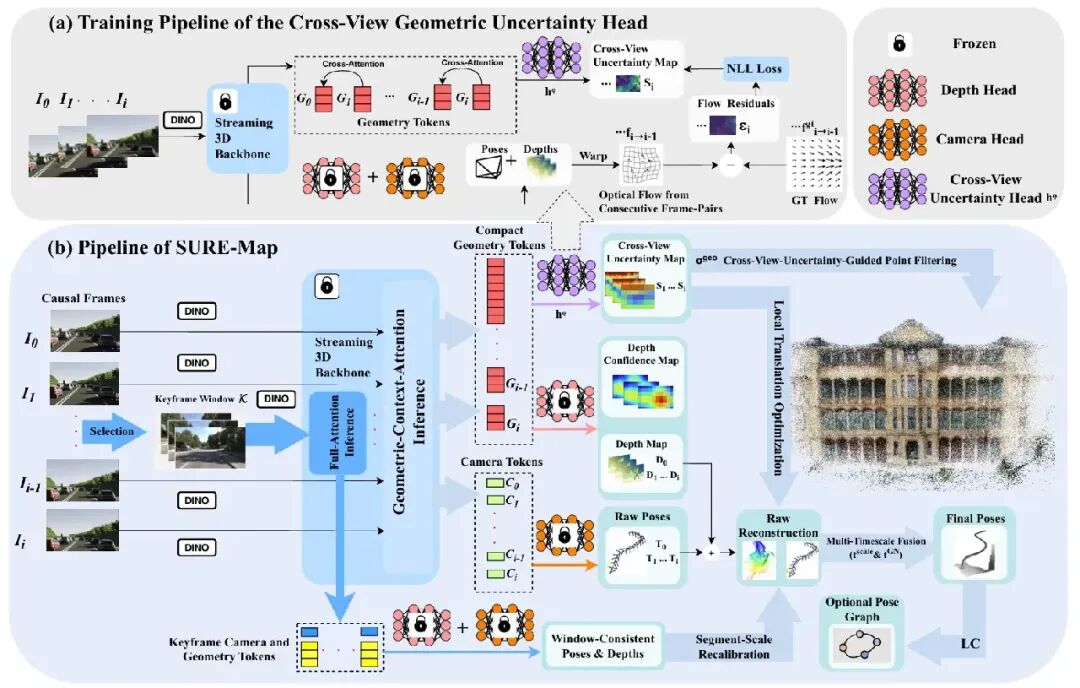
图2 (a) 跨视图几何不确定性头由位姿-深度诱导光流与真值光流之间的差异监督。(b) 流式重建中,不确定性引导稠密点过滤和局部平移优化;多时间尺度自校正将快速连续帧推理与稀疏关键帧窗口推理耦合,后者周期性地重校准轨迹尺度。
这种跨视图不确定性捕获的是隐式数据关联的可靠性——即流式模型所依赖的、未显式输出但实际使用的像素级对应关系是否可信。论文强调了一个反直觉的设计选择:保持旋转固定以优化平移,因为如果让旋转也参与优化,尺度或对应残差会反过来诱导旋转误差,而旋转误差在长序列上是乘法累积的,危害远大于平移误差的加法累积。
三、多时间尺度自校正:用“长记忆”校准“短记忆”的尺度
跨视图不确定性解决了单帧层面的局部误差检测和过滤问题,但论文清醒地认识到:局部校正无法阻止尺度误差在长轨迹上缓慢累积。在单目SLAM中,这种漂移通常通过回环检测和全局位姿图优化来纠正,但这需要重访和迭代优化。SURE-Map提出了一个更优雅的方案——多时间尺度自校正。
其核心思想是利用一个被论文称为“有利性质”的现象:稠密深度估计主要受图像外观驱动,在相同有限上下文下倾向于维持更稳定的局部尺度。这意味着如果能让模型在更长的时序窗口上做一次“全局性”推理,得到的深度和位姿可以为连续帧推理提供可靠的尺度参考。
具体实现上,SURE-Map维护一个固定大小的滑动关键帧窗口。关键帧按固定步长插入,当最新关键帧之间的位姿-深度诱导光流幅度超过预设阈值时,触发新关键帧插入。周期性地,模型在当前窗口上运行全注意力推理:
得到的深度图 与连续帧推理得到的深度图 通过逆深度拟合对齐,求解尺度因子 :
随后,通过比较关键帧窗口内的相对平移长度与流式相对平移长度,中位数估计出段尺度线索 。最终的平移估计在尺度重校准结果与局部高斯-牛顿优化结果之间进行加权融合:
其中 平衡了来自关键帧窗口的长程几何证据和来自连续帧的局部校正。值得注意的是,所有旋转估计始终保持来自流式模型的原始预测,不被优化过程修改,以避免旋转误差的乘法累积。
这种设计的精妙之处在于:连续帧推理使用几何上下文注意力保证因果更新的效率,而关键帧窗口推理使用全注意力获取丰富的跨帧几何依赖。两者不是简单的冗余,而是在时间尺度上互补——前者提供高频的局部校正,后者提供低频的全局尺度校准。
四、实验结果:长轨迹基准上的系统性改进
SURE-Map在五个基准上进行了全面评估:长轨迹位姿精度在KITTI、VBR和Oxford Spires上测试,稠密重建质量在Neural RGB-D和7-Scenes上评估。

表1 列出了KITTI上各序列的ATE-RMSE(米),红色标注最佳结果,蓝色标注次佳。SURE-Map(仅流式,不含回环)在11个序列中的10个上取得最佳成绩,平均ATE-RMSE为17.24m,相比基线LingBot-Map的24.00m降低了28.2%。加入回环后进一步降至15.17m。

表2 汇总了三个长轨迹基准的平均ATE-RMSE。SURE-Map在KITTI上从LingBot-Map的24.00降至17.24m,Oxford Spires上从5.11降至4.74m,VBR上从31.37降至28.58m。加入回环后分别进一步优化至15.17、4.63和22.12m。

表3 展示了稠密重建结果(Accuracy、Completeness、F1分数)。在NRGBD上,不使用不确定性过滤时SURE-Map取得0.074的Accuracy,过滤后提升至0.067;Completeness为0.035,F1分数为66.20。在7-Scenes上,不使用过滤时Accuracy为0.035,过滤后为0.033;Completeness为0.045,F1分数为81.93。与StreamVGGT、InfiniteVGGT、Stream3R、CUT3R、TTT3R、WIn3R和LingBot-Map相比,SURE-Map在两个数据集上均取得最高的F1分数。


效率方面,论文报告SURE-Map在相同流式设置下每帧增加15-30ms开销。在KITTI序列04上,吞吐量从LingBot-Map的11.68 FPS降至9.17 FPS。虽然帧率有所下降,但仍保持了流式推理的效率水平。这个权衡是合理的:每帧增加不到30毫秒,换来的是ATE-RMSE 28.2% 的改善。
五、消融实验:两项机制如何各司其职
表4 展示了逐项消融结果。移除回环后,SURE-Map在Oxford Spires、KITTI和VBR上的ATE-RMSE分别为4.74、17.24和28.58m。进一步移除不确定性加权优化(仅保留尺度重校准),三个基准分别退化至4.91、17.57和29.96m。再移除尺度重校准(仅保留基础流式推理),退化至5.11、24.00和31.37m。这清晰地表明:尺度重校准和不确定性加权优化提供了互补的改进——前者解决长程尺度漂移,后者解决局部位姿误差。

表5和图5对比了点云过滤策略。在NRGBD上,使用深度置信度过滤时CD从0.051恶化至0.084,Completeness从0.035恶化至0.113,F1从66.20降至65.00;而在7-Scenes上,深度置信度过滤的CD从0.039恶化至0.051,F1从81.93降至80.90。相比之下,不使用任何过滤虽然CD保持不变或略有改善(NRGBD上0.052,7-Scenes上0.039),但F1分别降至65.10和81.77。这说明学习到的几何不确定性能够在不牺牲结构完整性的前提下拒绝不可靠点,而深度置信度过滤则丢弃了过多有效点。


六、在流式重建版图中的位置
SURE-Map的定位需要放在流式3D重建的演进脉络中理解。VGGT将几何基础模型从成对输入扩展到多视图联合预测,但它设计用于离线处理,全注意力的二次复杂度在长序列上不可承受。StreamVGGT引入因果注意力和KV缓存实现流式推理,但KV缓存随序列线性增长。HorizonStream通过“证据影响核”将几何传播分解为通道级衰减线性注意力,训练时仅用48帧片段就能泛化到超过10,000帧,但论文中SURE-Map的对比表明其在KITTI上仍受困于尺度漂移。LingBot-Map以紧凑的几何上下文和大规模长序列训练改善长程一致性,在约20 FPS下支持超过10,000帧的序列,SURE-Map正是构建在LingBot-Map之上的——冻结其骨干网络,仅训练不确定性头。
从更宏观的视角看,SURE-Map代表了一种与SLAM-hybrid方案截然不同的思路。MASt3R-SLAM和VGGT-SLAM 2.0将学习到的几何先验嵌入经典SLAM管线,通过后端优化反复强制全局一致性。SURE-Map则选择了一条更轻量的路径:不引入显式束调整或位姿图优化,而是在推理阶段通过不确定性感知的局部校正和周期性的尺度重校准来实现自纠错。这使得它既保留了馈送式推理的简洁性,又获得了接近优化方法的全局一致性。
七、从代码到实验:完整复现路径
论文标题:SURE-Map: Self-Correcting Streaming Geometric Foundation Models
作者:Mingkai Liu,Hao Zhao(清华大学),Xingxing Zuo
机构:Mohamed bin Zayed University of Artificial Intelligence(MBZUAI),北京大学,清华大学
项目主页:https://mingkai-liu.github.io/projects/sure-map/
代码仓库:https://github.com/RCL-Robotics/SURE-map
GitHub仓库提供了从环境配置到各基准评估的完整脚本。环境搭建方面,仓库要求Python 3.10和CUDA 12.8,依次执行conda环境创建、PyTorch安装、项目安装以及FlashInfer安装。FlashInfer是SURE-Map流式推理的关键依赖,它提供了分页KV缓存注意力机制,支撑连续帧推理的高效因果更新。
git clone https://github.com/RCL-Robotics/SURE-map.git SURE-Map
cd SURE-Map
conda create -n SURE-Map python=3.10 -y
conda activate SURE-Map
pip install torch==2.8.0 torchvision==0.23.0 --index-url https://download.pytorch.org/whl/cu128
pip install -e .
pip install --index-url https://pypi.org/simple flashinfer-python
模型检查点方面,SURE-Map设计用于VGGT风格的几何基础模型。仓库提供了训练好的跨视图几何不确定性头检查点(checkpoints/uncertainty.pt),骨干网络则使用LingBot-Map的预训练权重,从Hugging Face仓库下载后放置到对应路径即可。
训练仅针对不确定性头,骨干网络保持冻结。TartanAir v1数据集从官方网站下载解压后,通过--tartanair_root参数指定路径。仓库中特别说明了一个实现细节:论文使用逆向光流符号,而TartanAir提供的是前向光流,因此训练时反转帧序,使光流源帧始终作为跨注意力查询,从而将不确定性预测与监督的光流残差对齐。训练在8张GPU上分布式执行,使用8-24帧的片段,分辨率518×392,总步数20k,NLL损失的--beta_nll权重设为0.5。训练完成后检查点保存到training/outputs/flow_sigma_tartanair/ckpts/目录下。
评估数据集覆盖了论文中报告的全部五个基准。Oxford Spires需要下载相机图像、标定文件和真值轨迹,仓库提供了一个预处理脚本,以3840帧为上限进行图像校正并导出相机到世界的真值位姿。KITTI Odometry需要下载彩色图像、标定和位姿三个压缩包,解压到同一父目录后,设置配置文件中的数据集根路径。VBR使用Hugging Face上处理好的版本。7-Scenes和Neural RGB-D则保持原始解压格式,数据集加载器直接兼容。
每个基准都有对应的端到端评估命令。KITTI上运行online/run_kitti.py,输出TUM格式的轨迹文件和包含每序列及平均ATE-RMSE的summary.json,可与论文Table I和Table II逐项对照。Oxford Spires和VBR分别运行online/run_oxford.py和online/run_vbr.py,输出格式一致。稠密重建评估在benchmark目录下进行,NRGBD默认过滤20%最高不确定性点,7-Scenes由于场景较干净仅过滤10%。仓库还额外提供了DTU数据集上的评估结果,论文中未报告,但可以作为补充参考。
写在最后
SURE-Map的核心贡献不在于提出一个全新的骨干网络架构,而在于为已有的流式几何基础模型装备了自我纠错的能力。跨视图几何不确定性用位姿-深度诱导光流与真值光流的一致性作为监督信号,让模型能够识别自身隐式数据关联中的不可靠区域;多时间尺度自校正则在快速因果推理与长程全局推理之间建立了周期性校准机制,用后者为前者提供尺度锚点。
这套框架的通用性值得关注——它不绑定于特定的骨干网络,任何支持几何token输出的流式重建模型都可以接入不确定性头和尺度重校准模块。结合GitHub仓库提供的完整工具链,从环境搭建到数据集准备再到各基准评估,研究者和工程师可以快速复现论文中的全部实验,并在此基础上探索更广泛的流式重建应用场景。在长轨迹三维重建这个核心挑战面前,这种“轻量级自校正”的思路或许比追求更大更强的端到端模型更具工程可持续性。
本文仅做学术分享,如有侵权,请联系删文。
。



扫码添加微信,备注:姓名+方向+单位,邀请入群。