9月22日杭州云栖大会,阿里把它摆上台面。网上很多人盯着“性能三倍”尖叫,我倒觉得,真正值得坐下来看的,不是三倍,而是阿里终于把AI算力从“买卡竞赛”拖进了“系统战争”。

真武V900发布现场:3X、216GB、1200GB/s、FP8/FP4被放在同一张大屏上。图源:电子工程专辑/云栖大会公开报道
我做芯片培训这些年,最怕学员问一句:“老师,这颗芯片是不是吊打谁谁谁?”我一般先泼冷水:发布会上的参数,像相亲简历,都挑好看的说。真武V900目前公开信息主要是阿里官方口径,独立跑分、客户大规模训练曲线、能效曲线、良率、故障率、供给节奏,还没完全摊开。可即便如此,这颗芯片仍然值得认真拆,因为它背后的思路变了。
一、别只看见三倍,要看见“显存、互联、精度、量产”被一起抬上桌
真武V900最抓眼球的是几个数:相对真武M890性能提升到三倍,216GB显存,片间互联带宽1200GB/s,原生支持FP8、FP4,面向高精度训练、低精度和超低精度推理,2027年第一季度量产并进入阿里云数据中心规模化部署。要是放在五年前,这很像一张标准PPT:大显存、高带宽、低精度、训推一体。可到了2026年,大模型把硬件问题拧成了一股绳:单卡算力只是门票,显存容量决定模型能不能塞进去,显存带宽决定喂不喂得饱,片间互联决定千卡是不是一坨散沙,精度弹性决定同样一颗芯片能不能在训练和推理之间来回切。

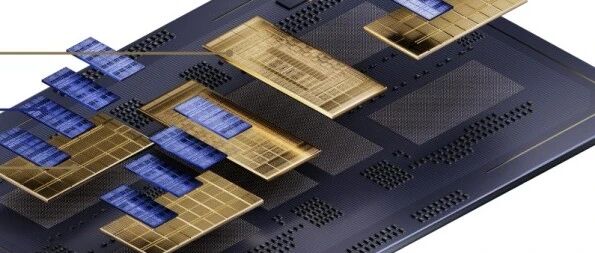
真武V900芯片近景。图源:新浪财经转引发布会公开图
所以,我对“三倍”的理解不是“跑分三倍”,而是阿里试图把AI加速器的四个痛点一起打包:第一,模型越来越胖,216GB显存是在抢“大参数、长上下文、多模态”的入场券;第二,MoE和稀疏化让有效算力越来越依赖内存系统,带宽比峰值算力更诚实;第三,推理成本压到骨头里,FP8/FP4不是锦上添花,是商业化生死线;第四,量产时间写在2027年一季度,等于告诉市场:别只看发布,看交付。
这句话可能不中听:AI芯片早就过了“堆一个漂亮峰值”就能吓住人的年代。现在客户会问得很细——你跑Qwen、跑主流开源模型,tokenizer、attention、MoE路由、KV cache、通信库、容错、断点续训,哪一环掉链子,三倍就变成三分之一。真武V900如果真能把这些环节在阿里云里跑顺,它的意义就不是“发布了一颗芯”,而是“阿里给自己的云造了一台发动机”。
二、真正的杀招:上千颗V900像一颗芯片一样工作
这次我更关注ICN Switch。平头哥说,真武V900通过自研ICN Switch互联芯片连接后,超节点具备原生内存语义和内存统一编址能力,可实现千卡全带宽高速互联;用他们现场的话说,上千颗真武V900能像一颗“超级芯片”一样协同工作。新一代磐久超节点又把V900、ICN Switch、磐脉智能网卡、镇岳SSD主控芯片放进同一台服务器,再配合阿里云网络架构,把单一AI集群往50万卡这个量级去扩。

从磐脉、倚天、真武到ICN Switch、镇岳,阿里把AI基础设施摆成了一张家族图。图源:凤凰网科技转引发布会公开图
这件事对做系统的人来说,刺激很大。过去很多国产AI芯片喜欢讲单卡,客户买回来却发现:卡不错,网不行;网不错,存储不行;存储不错,调度不行;调度不错,模型一上强度,通信库先崩。AI集群不是乐高积木,不是把最好的零件堆一起就自动变成跑车。尤其大模型训练,最怕的是“局部很快、整体很慢”:单卡峰值漂亮,all-reduce一拥塞,GPU/加速卡就在那儿等,电费哗哗烧,时间一秒一秒漏。
ICN Switch这类互联芯片的价值,在于把“连接”从配套件变成主角。 Native memory semantics、统一编址这些东西,说起来抽象,翻译成人话就是:让程序员少像拼八爪鱼一样管内存,让集群更像一台有大内存的机器。做到了,千卡才算一台机器;做不到,千卡只是千个脾气古怪的盒子。阿里现在把V900、互联芯片、智能网卡、SSD主控和超节点服务器捆在一起,摆明了不想只卖“卡”,要卖“确定性”。
这也解释了为什么超节点最近这么热。大模型进入Agent和递归式自我改进阶段后,训练不再是一次性跑完就交卷,而是模型生成数据、筛选数据、再训练、再评估的循环。循环越快,越像一台机器智能流水线。流水线的瓶颈常常不在最亮的那个零件,而在传送带。ICN Switch和超节点,就是阿里修传送带的方式。
三、阿里为什么必须自己干?因为模型已经追到芯片脚下了
真武V900不是孤立出现的。往前看,阿里说过自研M890 AI超节点已具备支撑2万亿参数大模型推理的能力;往后看,Qwen团队还在推进模型架构和数据优化,方向直指5T—10T参数规模的全新模型。吴泳铭在大会上的表达也很直白:未来三年,阿里将全力投入AI基础设施建设,推动芯片、模型和云这三大核心基石的协同进化,目标到2032年阿里云运营的全球数据中心规模超过20GW。
这段话可以翻译成产业语言:模型越大,越会反过来“设计”硬件;硬件越懂模型,越能把每一焦耳电、每一比特带宽、每一次内存访问换成Token。以前的逻辑是云厂商买芯片、芯片厂商追通用市场;现在的逻辑是模型公司自己长出一颗芯,云把芯片变成服务,模型再把服务吃回去。闭环一旦跑通,成本曲线会非常吓人。
我做培训时总爱举一个粗浅例子:推理成本就像水龙头,模型是水流,芯片是阀门,云是管道。只拧阀门,不修路,水压一大到处漏;只修路,不造阀门,水再多也放不快。阿里现在是自己造阀门、自己修管道、自己决定水往哪儿流。这个打法重,烧钱,周期长,可一旦形成,就不是某个单点参数能轻易撼动的。
当然,也别把“协同进化”听成玄学。它落到工程上,是一堆很硬的问题:编译器能不能自动把模型图切成适合V900的算子;通信库能不能在千卡规模下保持可预测的延迟;显存一致性和容错怎么做;异构集群里CPU、加速卡、网卡、SSD怎么少互相拖累;客户私有化部署时,运维工具链是不是也要跟着换。发布会可以点燃情绪,量产只能靠这些脏活累活。
再补一层背景:2026年的AI芯片竞争,已经不只是“谁峰值高”,而是“谁能在真实负载里把利用率做高”。训练看 MFU,推理看每Token成本,集群看有效吞吐,云上看SLA。很多参数在PPT里很漂亮,一进业务就露馅:并发一高,KV cache爆了;长上下文一开,显存碎片来了;MoE一上,通信占比飙了;checkpoint一写,存储又顶不住。真武V900把216GB显存和1200GB/s片间互联放在一起,显然不是摆拍,是在回应这些具体疼痛。
这也是我说它“换打法”的原因。单颗芯片时代,厂商爱讲制程、TOPS、HBM容量;超节点时代,讲的是把计算、内存、网络、存储做成一个可编排的整体。你可以把它想成从“卖发动机”变成“卖整套赛车动力总成”。发动机当然重要,但没有变速箱、悬架、轮胎、热管理和 telemetry,发动机只能在台架上吼。
对采购方来说,接下来要换一套问题清单。别再只问“峰值多少、显存多少”,要问:在你们的模型上,prefill和decode怎么分配;长上下文下KV cache怎么管理;千卡扩展效率曲线在哪个节点开始掉;故障域怎么切;断点续训损失多少时间;混合精度从FP8切到FP4,精度损失谁兜底;同样的业务从旧平台迁过来,多少算子能复用,多少要重写。能把这些问题答细的团队,才接近量产;答不上来的,发布会再燃也只是烟花。
从更长的周期看,AI芯片还会出现一个新指标:Token工厂良率。不是晶圆良率,而是“稳定产出可用Token”的能力。它会同时惩罚硬件、编译器、集群调度和模型工程。未来评价真武V900,不该只看一颗芯,而要看一座数据中心能不能像印钞机一样,持续、低噪、可控地印出智能。
四、别急着封神:真武V900的考题在发布会之后
我还是要泼第二盆冷水。现在就说“真武V900改写全球格局”,太早。第一,量产节点在2027年一季度,中间隔着HBM供给、先进封装、良率爬坡、板卡可靠性、液冷和供电配套;第二,生态迁移是最难啃的骨头,客户不是不支持国产,而是支持不起一次核心训练翻车;第三,AI芯片竞争已经从“能不能做”变成“敢不敢押”,敢不敢押取决于工具链、算子覆盖、稳定性、运维体系,还有长期供货承诺。

芯片只是开始,板卡、互联、整机、机房才是交付。图源:搜狐科技转引发布会公开图
对标海外巨头,真正的壁垒也不只是某颗加速器,而是CUDA生态、网络、库、框架、开发者习惯和十几年沉积的Know-how。国产芯片可以靠云厂商自研需求先跑起来,这一步很关键;但从“自己用”到“别人大规模用”,中间有一条鸿沟。很多团队卡在“实验室里很好,客户机房很吵”:温度一高降频,多卡一扩抖动,长稳一跑掉卡,业务方第二天就会把你从供应商名单里划掉。
所以我对真武V900的判断是:它未必立刻改写全球座次,但很可能先改写阿里自己的成本结构。先在自己体内跑顺,再向外部输出,这条路比“发布会吊打一切”靠谱。真武系列此前已有出货和行业客户积累,财新此前报道提到真武系列累计出货56万片,云栖大会现场口径又称已服务650余家企业客户——无论按哪个口径看,它都不是PPT公司,关键是V900能不能把前代经验变成下一代口碑。
还有一个容易被忽略的变量:能耗。20GW数据中心不是口号,是电网、土地、液冷、资本开支和碳排的综合工程。未来AI芯片的竞争,一定会从“每瓦性能”滑向“每Token成本、每Token延迟、每Token碳排”。谁能把这一串指标讲清楚、做到位,谁才有资格谈规模化。真武V900要证明自己,不该只开一场发布会,而该开一场“.Token成本解剖课”。
五、给从业者的信号:只会画模块的人,会越来越难
如果做芯片,还在只盯RTL、时序、某一个模块PPA,接下来会越来越难受。真武V900这类产品释放的信号很清楚:未来更值钱的能力,是系统架构、Chiplet与先进封装、HBM和NoC协同、片间互联协议、编译器与算子库、集群网络、存储通路、液冷供电、模型—硬件联合设计,以及推理TCO优化。换句话说,芯片设计正在从“画一颗好芯”,变成“设计一台会生产智能的机器”。
我给学员的建议也改了。以前学数字IC,把Verilog、UVM、STA、低功耗吃透,已经能吃饭;以后还得懂点体系结构,懂点并行计算,懂点AI模型到底怎么跑,懂点通信和存储,懂点云原生运维。不是让每个人都变全栈,而是要知道自己那块模块在整机里为什么值钱。做互联的,要知道all-reduce为什么痛;做SRAM的,要知道KV cache为什么吃容量;做功耗的,要知道推理业务为什么对每毫瓦都抠;做DFT的,要知道超节点里一颗芯片挂了不能拖垮整张训练图。
对培训机构来说,课程表也该换血了。只讲传统SoC流程不够了,要把Chiplet、UCIe、HBM、NoC、CXL/内存语义互联、AI编译器、算子性能分析、集群调度、液冷数据中心这些东西系统塞进去。学生未来进公司,面对的不再是“一颗芯片流片成功就举杯”,而是“千卡集群连续跑三十天,业务方肯不肯签字”。这个标准,比任何口号都残酷,也比任何口号都更接近真实产业。
如果再把镜头拉远,真武V900也是一面镜子。它照出国产AI算力的三条路:一条是紧追通用GPU,正面硬刚生态;一条是绑定云和大模型,用确定性场景养规模;还有一条是沉到行业,做智驾、机器人、科研、金融这些愿意为稳定付溢价的场景。三条路都可能活,但活法完全不同。最怕的是嘴上走第二条,身体还在第一条,交付按第三条报价,最后把团队拖进泥里。
所以,热闹归热闹,工程归工程。真武V900最该留下的,不是“中国最强”这四个字,而是一套可复核的方法论:把模型需求翻译成硬件指标,把硬件指标翻译成系统架构,把系统架构翻译成客户账单。谁能把这条链路打通,谁就不怕名字被叫错;谁打不通,叫成“真500V900”也没用。
最后给公众号前的同行一句实话:写这类稿子,尽量少用“碾压”“封神”“一夜变天”。芯片行业最反感动词,因为流片会教训每一个动词。我们可以热血,但热血要落在可验证的地方——量产时间、规模部署、客户负载、成本曲线、长稳运行。真武V900值不值得追,不靠情绪,靠下一轮实打实的集群数据。
还可以从一个更冷的角度看:AI芯片正在变成“重资产行业的轻资产入口”。听起来矛盾,但逻辑很顺。芯片本身越来越贵,HBM、先进封装、验证、机台、长稳测试都重;可一旦做成云实例,客户买到的是按Token、按卡时、按SLA计费的算力,不必关心地下机房多吵。真武V900如果真被阿里云规模消化,它就不是传统意义的“卖芯片”,而是把重资产封装成可调用的智能产能。这个模式的门槛在于规模,规模不够,折旧会吃掉一切;规模够了,软件栈和调度又会变成新的护城河。
因此,未来两三年看平头哥,不要只盯发布会,要盯四个“率”:量产爬坡的良率,客户上量后的留存率,关键负载的迁移率,以及故障后的恢复率。前两个决定它能不能活,后两个决定它能不能被信任。AI时代最稀缺的不是一颗参数炸裂的芯,而是让客户敢把核心生产任务押上来的确定性。确定性这东西,报价单里看不见,机房日志里全是。
对读者里的工程师,我也想把话说软一点:不必因为一颗芯片发布就焦虑到重新做人,但也不能假装行业没变。变化不是从V900开始,只是V900把它拍在了大屏上。以前做一颗好芯就能赢,现在要做对一张账单:芯片成本、机柜成本、电力成本、网络成本、运维成本、机会成本,全都要进同一张表。能在这张表里找到优化点的人,未来不会缺位置。
结尾:名字被叫错没关系,打法不能错
“真5V900”这个误传,反而挺妙。网友不在乎它叫V900还是5V900,大家在等的是:国产AI芯片到底能不能从单点突破,走到系统成型。真武V900给出的回答,不是一颗芯片单挑全世界,而是芯片、互联、网卡、存储、超节点、云和模型一起上牌桌。这个打法更重,也更像真正的工业战。
接下来一年,别只问“V900跑分多少”。多问三句:第一,2027年一季度量产,良率和交付跟不跟得上;第二,千卡到万卡再到更大规模,通信和容错是不是稳定;第三,客户把核心负载迁过去以后,Token成本到底降没降。发布会点燃的是情绪,量产回答的是命运。
阿里已经把牌打出去了。对手不会站着看,产业链也不会等人。对做芯片的人来说,这既是压力,也是最好的时代:潮水真的来了,而且这次不是虚火,是电、是带宽、是显存、是模型、是数据中心的钢梁铁骨。真武V900到底成不成,三年后看集群,五年后看生态,十年后看产业。现在,先让子弹飞一会儿。
END


往期精选:
请点下【♡】给小编加鸡腿