论文:WholeBodyWAM: Learning Whole-Body World Action Models with Scalable Motion Priors
作者单位:南开大学、北京人形机器人创新中心、北京理工大学、清华大学
论文地址:arXiv.2609.18197
项目主页:zbzyjya.github.io/WholeBodyWAM/
人形机器人弯腰捡起玩具,再站起身将其放进篮子——这样一个看似简单的动作,它究竟需要预测什么?
它不仅要判断玩具的位置和抓取后的场景变化,还要预测自己的身体接下来如何运动:如何弯腰、伸手、保持平衡,再从下蹲恢复站立。
天工3.0在WholeBodyWAM控制下完成下跪、拾取和收纳,展示大幅度姿态转换与双臂操作的协调能力。
过去,World Action Model(WAM,世界动作模型)主要通过预测未来视觉变化辅助机器人决策。但对于高自由度人形机器人,仅仅预测外部环境还不够,机器人自身的全身运动同样需要被预测。
然而,真实机器人示范数据采集成本高、难以跨本体复用。能否利用更易扩展的人类与异构机器人运动数据,让世界模型学会预测未来身体运动,并将这种能力迁移到真实机器人控制中?
来自北京人形和南开大学等机构的联合研究团队提出了 WholeBodyWAM(全身世界动作模型),探索了一条利用大规模人类与异构机器人运动数据学习人形机器人世界模型的新路线。
论文的核心思路是:不再完全依赖昂贵的目标机器人示范数据,而是先从海量 Whole-Body Motion (全身运动)中学习可迁移的身体动态先验,再将这种预测能力融入真实机器人的动作生成过程。
为此,研究团队构建了包含超过 4.1K 小时、119 万条运动序列、4.44 亿帧运动数据的 UniMotion-4K,并将预训练得到的 Motion Expert 与 Video Expert、Action Expert 联合建模,实现从大规模运动学习到真实人形机器人全身控制的迁移。
依托北京人形机器人创新中心「具身天工」平台的天工 3.0 全尺寸人形机器人,WholeBodyWAM 在六项真实世界全身操作任务中取得了 72.2% 的平均归一化任务得分。随着 Motion Pretraining 运动预训练数据规模扩大,模型的未来运动预测与下游真机控制表现持续改善,并在目标机器人数据效率、任务泛化和推理效率方面展现出相应收益。
Whole-Body Motion,能否成为人形机器人基础模型的一条新 Scaling 路线?

01 从预测未来场景,到预测未来身体
近年来,World Action Model(WAM,世界动作模型)逐渐成为具身智能领域的重要研究方向。与直接根据当前观测生成动作的策略模型相比,WAM 通过建模未来动态,让机器人在动作生成过程中能够利用对未来状态的预测信息。
现有不少研究主要围绕未来视觉展开,通过预测未来视频或视觉表征,帮助机器人理解动作执行后外部环境将如何变化。但当机器人从固定机械臂走向全尺寸人形机器人时,仅关注外部场景的变化,难以完整描述机器人执行任务时面临的状态演化。
例如,机器人从地面拾取玩具时,不仅需要判断物体的位置,还要协调躯干前倾、腿部姿态、手臂伸展以及抓取后的站立恢复。如果任务进一步涉及携带物体行走,身体姿态、移动和双臂操作之间的协调关系就更加复杂。
这些行为并不是几个孤立的动作,而是一个连续演化的 Whole-Body Motion 全身运动过程。
WholeBodyWAM 的核心洞察在于:对于人形机器人,自身的身体状态同样是不断演化的世界状态中与控制密切相关的一部分。
因此,除了预测外部环境的变化,人形机器人的世界模型还需要显式学习未来身体状态的演化,让全身运动预测成为动作生成的重要信息来源。
而这种预测能力,并不一定只能从目标机器人自身的操作示范中获得。
互联网上大量的人类活动视频、结构化 3D 人体运动数据,以及其他人形机器人平台积累的运动轨迹,都包含着丰富的姿态转换、上下肢协调和连续运动信息。虽然这些数据无法直接作为目标机器人的控制指令,但可以为学习身体运动规律提供预测监督。
WholeBodyWAM 希望利用的,正是这些比目标机器人 Action 数据更加容易扩展的 Motion 数据资源。
通过先学习未来身体运动,再将运动先验迁移到目标机器人控制,模型有机会在接触目标机器人之前,就从大规模人类与异构机器人数据中获得预测性的身体运动知识。
02 4K+ 小时 Motion 预训练,如何迁移到真实人形机器人?
为了实现大规模跨本体 Motion Pretraining,研究团队首先构建了运动数据集 UniMotion-4K,并依托北京人形机器人创新中心「具身天工」平台的天工 3.0 ,探索如何将大规模运动数据中学到的身体动态先验迁移到真实人形机器人的全身操作控制中。
UniMotion-4K 整合了互联网人类视频、结构化 3D 人体运动以及异构人形机器人运动等多个来源,包含 HowTo100M、EgoDex、AMASS、Motion-X、BONES-SEED、HIW-500 等运动资源,最终形成超过 4.1K 小时的 Whole-Body Motion 数据。
然而,不同数据源采用的身体模型、关节定义和状态表示并不一致。即使是相似的身体运动,在不同机器人上也可能对应完全不同的动作指令,无法直接放进某一台目标机器人的控制空间中统一训练。
为此,WholeBodyWAM 将不同来源的运动数据统一到共享的 63D Motion Space。
这一表示由 21 个关节的局部旋转构成,使人类与异构机器人运动能够在统一表示下提供预测监督,让模型先学习身体姿态与关节协调的时序规律,而不必将所有数据转换成目标机器人的可执行动作。
在此基础上,WholeBodyWAM 采用两阶段训练框架,将大规模运动先验学习与目标机器人控制学习连接起来。

第一阶段:从大规模 Motion 中学习未来身体运动。
模型根据过去一段全身运动和语言指令,预测未来的 Whole-Body Motion。这一阶段不需要目标机器人的动作标签或真实操作示范,而是直接利用人类与异构机器人运动数据学习可迁移的 Predictive Motion Prior。
换句话说,模型首先学习的不是“某一台机器人应该输出什么控制指令”,而是“给定当前身体状态和任务条件,身体接下来可能如何运动”。
这种预训练方式,使不同来源的运动资源能够在目标机器人后训练之前得到充分利用。
第二阶段:将预训练得到的 Motion Prior 融入真实机器人控制。
WholeBodyWAM 将 Video Expert、Motion Expert 和 Action Expert 联合起来:Video Expert 建模未来场景动态,Motion Expert 预测未来全身运动,Action Expert 则生成目标机器人可执行的动作。
三个 Expert 通过 Mixture-of-Transformers(MoT)Attention 进行信息交互,让预测性的视觉与身体运动信息共同参与动作生成。
这意味着,Motion Expert 不只是一个独立的运动预测模块,其在大规模预训练中学到的身体动态知识,还能够直接用于辅助下游控制。
值得注意的是,WholeBodyWAM 虽然在训练阶段保留了未来视觉预测监督,但在真实机器人部署时,并不需要完整生成和解码未来 RGB 视频。
模型可以根据当前视觉观测、身体运动历史和语言指令,直接预测未来 Whole-Body Motion 与 Action Chunk。
这种设计让模型在保留未来预测能力的同时,避免了完整视频生成带来的额外在线计算开销,也为后续人形机器人的闭环移动操作提供了更加高效的动作生成方式。
03 从 0 到 4K+ 小时,Motion Scaling 能否真正转化为机器人能力?
对于 WholeBodyWAM 而言,增加一个 Motion Expert 并不是研究的最终目标。
更关键的问题在于:随着 Motion Pretraining 数据规模扩大,模型能否获得更好的未来运动预测能力,并进一步提升真实人形机器人的控制表现?
为了验证这一点,研究团队依托北京人形机器人创新中心「具身天工」平台的天工 3.0 全尺寸人形机器人,开展了六项真实世界全身操作任务测试,涵盖玩具拾取、衣物装载、枕头搬运、跪姿收纳、玩具转移和箱体搬运等场景。
这些任务需要机器人协调完成弯腰、下蹲、站立、移动与双臂操作,能够考察模型在不同全身操作场景下的控制表现。
实验结果显示,WholeBodyWAM 在六项任务上的平均归一化任务得分达到 72.2%,相比 GR00T N1.7 的 60.8%,提升了 11.4 个百分点。
作为对比,FastWAM、π0.5 和 τ0-WM 的平均得分分别为 41.5%、58.1% 和 39.4%。
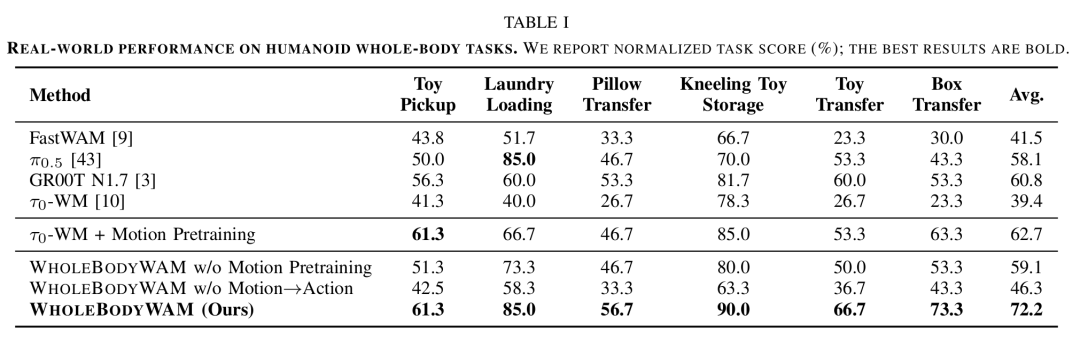
为了分析 Motion Pretraining 的实际作用,研究团队进一步开展了消融实验。
当保留 Video-Motion-Action 架构,但移除第一阶段的 Motion Pretraining 时,平均任务得分从 72.2% 下降至 59.1%;当保留 Motion Expert,却阻断 Motion 向 Action 的直接信息交互时,得分进一步下降至 46.3%。
这表明,Motion Expert 的作用并不只是增加一个辅助运动预测目标。将预训练得到的身体动态知识真正融入 Action Generation,是运动先验转化为控制收益的重要环节。
而这项工作更值得关注的,是其对 Motion Scaling 的直接验证。
研究团队分别使用 0、1K、2K 和 4K+ 小时的运动数据进行预训练,考察数据规模对未来身体运动预测与下游真实机器人控制的影响。
随着预训练数据规模扩大,模型的未来运动预测误差 MPJRE 从 1.127° 降至 0.817°,下降约 27.5%。
与此同时,三个代表性真实机器人任务上的平均归一化任务得分从 57.1% 提升至 67.6%。
随着 Motion Pretraining 数据规模增长,模型不仅能够更准确地预测未来身体运动,这种改善也进一步反映在真实机器人控制表现上。
这为人形机器人基础模型提供了一条值得探索的 Scaling 路线:通过扩大人类与异构机器人 Motion 数据规模,提升可迁移的身体运动预测能力,并将其转化为目标机器人的控制收益。
除了最终任务表现,Motion Scaling 的另一项重要价值在于提升目标机器人数据效率。
相比互联网视频和人体运动数据,真实人形机器人的全身操作示范需要复杂的采集设备和人工操作,数据获取成本更高,也难以在不同本体之间直接复用。
研究团队因此分别使用 20%、50% 和 100% 的目标机器人示范数据进行后训练。结果显示,引入 Motion Pretraining 后,三种数据预算下的平均任务得分分别提升了 4.2、11.2 和 10.5 个百分点,说明预训练运动先验能够在不同数据规模下提供控制收益。
其中,在三个代表性任务上,仅使用 50% 目标机器人示范数据的 WholeBodyWAM 取得了 46.9% 的平均归一化任务得分,而 FastWAM 使用完整目标机器人示范数据时,对应得分为 42.9%。
在这组实验中,借助大规模异构 Motion 预训练,WholeBodyWAM 仅使用一半的目标机器人示范数据,就取得了超过 FastWAM 完整数据训练版本的平均任务得分。
对于真实数据采集成本较高的人形机器人而言,这一结果展示了跨本体运动预训练在提高目标机器人数据利用效率方面的潜力。

(a)随着预训练数据规模扩大,未来全身运动预测误差持续降低;
(b)下游真实机器人任务得分随之提升;
(c)大规模运动预训练提高了目标机器人数据效率,仅使用 50% 目标机器人示范数据的预训练模型,在三个代表性任务上取得了超过 FastWAM 完整数据版本的平均得分。
04 泛化与推理效率:让预测能力真正服务于全身移动操作
除了训练条件下的任务表现,机器人能否适应变化的环境,同样是实际应用中的重要问题。
目标物体的位置、颜色和形状都可能发生变化;对于人形机器人而言,这些变化不仅影响目标识别与抓取,也可能改变机器人接近目标、调整姿态和完成操作的方式。
研究团队进一步设计了两类受控分布变化,考察 WholeBodyWAM 的任务泛化能力:在 Toy Pickup 任务中将目标篮子移动 15 cm,以及在 Kneeling Toy Storage 任务中使用未见过颜色和形状的玩具。
实验结果显示,在篮子位置变化后,WholeBodyWAM 取得了 55.0% 的归一化任务得分,高于 GR00T N1.7 的 46.3%;在未见玩具颜色和形状的条件下,WholeBodyWAM 取得了 75.0% 的任务得分,高于 GR00T N1.7 的 63.3%。
在这两类受控分布变化下,WholeBodyWAM 均表现出更小的性能下降,展示了对空间位置与物体外观变化的适应能力。

除了泛化能力,推理速度也是人形机器人世界模型能否真正走向实际部署的关键因素。
对于固定机械臂,部分操作任务允许机器人在相对静止的状态下等待模型完成推理。但对于正在行走、搬运物体或进行姿态转换的人形机器人,身体状态与外部环境都在持续变化。
如果模型生成动作的时间过长,机器人下一次决策所依据的观测,就可能已经与实际状态产生偏差。
尤其在全身移动操作中,机器人需要不断根据新的视觉与身体状态调整动作。高层策略的推理延迟会影响闭环决策的及时性。
因此,人形机器人的世界模型不仅需要能够预测未来,还需要及时将预测结果转化为可执行动作。
传统的视频生成式 WAM 往往需要预测未来视觉序列,部分方法还需要完整解码未来视频,带来较大的在线计算开销。
WholeBodyWAM 则采用了不同的思路:训练阶段保留未来视觉监督,部署阶段省去未来 RGB 视频生成,直接预测未来身体运动与动作序列。
在论文报告的 NVIDIA A100 端到端推理测试中,WholeBodyWAM 实现了 363 ms 的推理延迟。
相比之下,DreamZero 和 LingBot-VA 的推理延迟分别为 7095 ms 和 5259 ms,FastWAM 为 525 ms,τ0-WM 为 313 ms。
这意味着,WholeBodyWAM 相比 DreamZero 和 LingBot-VA 分别实现了约 19.5 倍和 14.5 倍的推理加速,相比 FastWAM 提速约 1.45 倍,同时保持了与 τ0-WM 接近的推理延迟。

这里值得关注的,不只是模型完成一次动作预测需要多少毫秒,而是 WholeBodyWAM 在保留显式未来身体运动预测的同时,避免了完整未来视频生成带来的计算负担。
在实际部署中,模型采用 Action Chunk 进行闭环执行,机器人底层控制器负责执行相应的移动与平衡控制,高层策略则根据新的视觉与身体状态持续更新动作决策。
需要注意的是,高层模型的一次推理延迟并不等同于机器人底层控制周期。对于全身移动操作,两者需要协同工作:底层控制器持续执行运动与平衡控制,高层策略则需要尽可能及时地根据新观测更新任务相关动作。
对于需要持续移动、调整姿态并完成物体操作的人形机器人,预测能力与推理效率需要共同服务于闭环控制。
WholeBodyWAM 通过直接利用未来身体运动预测,为兼顾两者提供了一种新的世界动作建模方式。
从目标机器人 Action 到跨本体 Motion,人形机器人 Scaling 的新探索
当前,具身智能基础模型正在不断向更大规模的数据和更复杂的机器人任务发展。但真实机器人 Action 数据具有明显的本体依赖性,采集成本较高,也难以像互联网视觉和语言数据一样持续扩展。
WholeBodyWAM 提供了另一种思路:
先从规模更大、来源更广泛的人类与异构机器人 Motion 数据中学习可迁移的身体动态先验,再通过目标机器人后训练完成控制能力迁移,而不必将模型能力的提升完全依赖于持续增加真机示范。
这项工作将世界模型的预测对象从外部环境进一步扩展到机器人自身的身体运动,也将预训练的数据来源扩展到更广泛的跨本体 Motion 资源。
从实验结果来看,Motion Pretraining 数据规模的扩大,不仅改善了未来身体运动预测,还进一步提升了真实机器人控制表现与目标机器人数据效率。未见任务条件下的泛化实验和推理延迟测试,也展示了这一框架在实际全身移动操作中的应用潜力。
WholeBodyWAM 为人形机器人基础模型探索了一条以大规模 Whole-Body Motion 为核心的 Scaling 新路线,也为如何将丰富的跨本体运动资源转化为真实机器人控制能力提供了新的研究思路。
对于人形机器人来说,理解外部世界接下来会发生什么固然重要。
但要真正完成复杂的全身移动操作,它还需要理解另一件事:
自己的身体,接下来应该怎么动。
-END-
点击下方卡片,关注【Xbotics具身智能实验室】公众号
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀