随着 Sora、Runway 等视频生成模型的快速迭代,AI 视频生成正在变得越来越普及。但生成速度慢、算力门槛高的问题,让大多数开发者和创作者难以将其落地。一段 5 秒 720P 视频,传统方法需要超过 1 小时才能完成扩散生成——这给实时创作、批量生成与消费级硬件部署带来了巨大挑战。
更令人困惑的是,当研究者试图通过极致稀疏化(97%稀疏率)来突破性能瓶颈时,却发现了一个反常现象:训练损失持续下降,生成视频质量却急剧恶化——人物破碎、背景扭曲、时序混乱。
针对这一问题,北京大学、清华大学、阿里巴巴等机构的研究者提出了 SparkDiffusion:首个将稀疏注意力、少步蒸馏与低精度量化整合到统一框架(含开源权重及完整训练代码)的视频生成加速系统,推动 DiT 视频生成从「分散优化单个组件」转向「端到端系统化加速」的新范式。
论文标题: SparkDiffusion: Mitigating the High-Sparsity Trap via Staged Sparse Warm-up, Trajectory-Mixed Distillation, and FP8 Quantization
项目主页: https://sparkdiffusion.github.io/
代码地址: https://github.com/AlibabaResearch/SparkDiffusion
研究机构: 北京大学、清华大学、阿里巴巴、电子科技大学、哈尔滨工业大学
核心发现
"高稀疏陷阱"——当训练越久,质量越差
极致稀疏的反常现象
研究团队发现,当稀疏率从 90%推到 97%时(计算量从 10%降至 3%),训练损失持续下降,生成视频却开始破碎、扭曲、失去时序连贯性。更诡异的是,延长训练、增大数据集、扩大补偿分支容量,都无法修复这个问题。

团队将这种现象命名为"高稀疏陷阱"(High-Sparsity Trap):
在极高稀疏率下,逐步监督架构的稀疏视频 DiT 会陷入一种失效模式——尽管单步验证损失持续优化,但终端生成质量却停滞不前甚至退化,而且延长逐步训练也无法实质性恢复终端质量。
问题出在哪?误差累积在高噪声阶段
扩散模型沿着去噪轨迹逐步生成视频。传统的 Flow Matching 等逐步监督方法,只要求模型在某个噪声时刻预测正确的速度,却不直接约束"这一步与后续轨迹组合后,最终会生成什么"。
关键实验:Oracle 干预
研究者做了一项 Oracle 干预实验:在 97%稀疏率下,用稠密教师的预测替换稀疏学生在不同采样区间的预测。
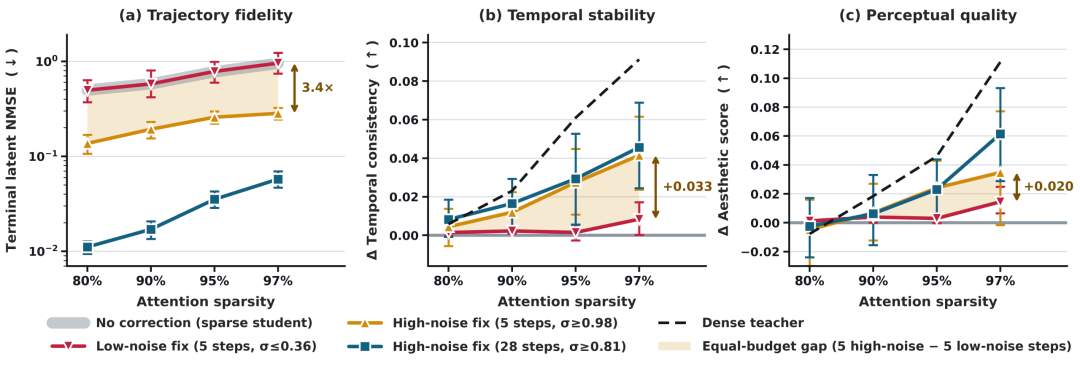
发现:
只修正最高噪声的 5 步: 移除大部分终点误差
修正最低噪声的 5 步: 改善很有限
结论: 高噪声阶段的结构误差会被后续步骤放大,最终导致终端质量崩溃。
解法
从诊断到分阶段治疗
核心洞察:终端对齐监督
传统方法的问题: 只监督"当前这一步预测是否准确",却不管后续累积误差会把结果带偏到哪里。
SparkDiffusion 的解法: 终端对齐监督(Terminal-Aligned Supervision),在训练时就约束"这一步最终会生成什么",从根源上避免误差累积。
理论验证:二维序列分布实验
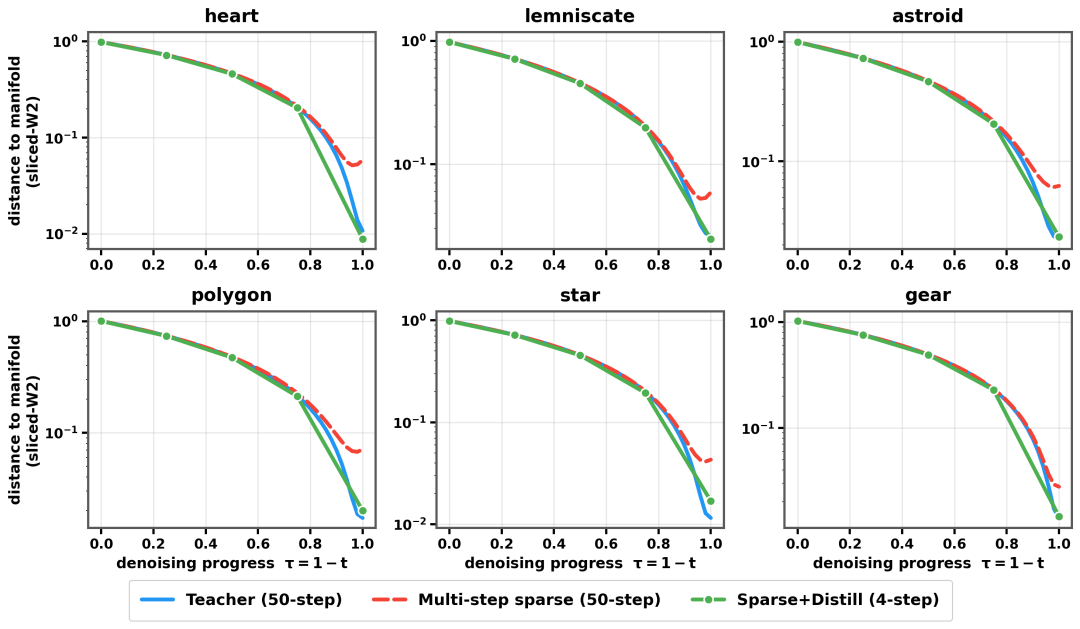
在六种二维序列分布上:
仅逐步训练的 95%稀疏模型: 轨迹末端明显偏离数据分布
加入终端对齐蒸馏后: 少步学生的终点距离重新接近稠密教师
方法设计
RoLA + CrossDistill + FP8
分阶段策略:先适应,再修正
基于上述诊断,SparkDiffusion 提出三阶段流程:

RoLA:为极高稀疏率保留全局信息
SparkDiffusion 默认采用团队提出的 RoLA:Rotary-Positioned Low-Rank Linear Attention for Efficient Diffusion Transformers 作为稀疏注意力模块。RoLA 一边通过块稀疏分支保留高能量 query-key 交互,一边用带旋转位置信息的低秩线性分支补回被稀疏化舍弃的全局上下文。
CrossDistill:3 步兼顾质量与多样性
SparkDiffusion 的少步蒸馏采用团队提出的 CrossDistill:Balancing Quality and Diversity via Trajectory-Level Hybrid Few-Step Distillation。CrossDistill 在噪声轨迹上设置交叉点。PCM 一致性目标和 DMD 分布匹配目标都不是只拟合孤立时刻,而是利用后续轨迹或最终输出构造监督,因此都属于终端对齐监督:
高噪声阶段使用 1 个 PCM 一致性步骤,跟随教师的粗结构与运动轨迹,并保留不同随机种子带来的多样性;
低噪声阶段使用 2 个 DMD 分布匹配步骤,直接修正终点可见误差,增强细节与真实感。
最终得到一个 3 步、无 CFG 的学生模型。它一方面用终端对齐信号跨过高稀疏陷阱,另一方面通过高低噪声分工平衡生成质量与多样性。
再结合 FP8 量化策略以及团队开发的高性能融合算子,将理论计算收益转化为实际延迟缩减。
实验结果
单卡 RTX 5090 实现 265 倍加速
主要性能数据
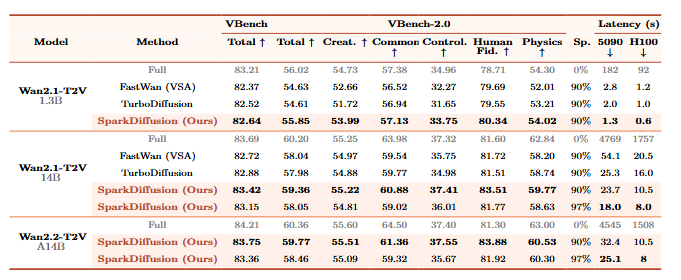
SparkDiffusion 在以下配置下均保持高质量快速生成:
在 90%稀疏率下: SparkDiffusion 在所有指标上全面超越 FastWan 和 TurboDiffusion
推到 97%稀疏: 质量略有下降但仍接近稠密基线,加速比从 201×提升到 265×
H100 上: 同样配置下加速 220×,绝对延迟降至 8 秒
为什么高分辨率加速更明显?
分辨率越高,稀疏收益越大:
720P 单帧 token 数是 480P 的 2.25 倍
注意力计算量是 O(L²),因此是 5 倍以上
RoLA 稀疏跳过的冗余计算也随之增加
这解释了为什么 720P-14B 的 265×加速比 480P-1.3B 的 140×更高。

立即体验
SparkDiffusion 已完整开源:
✅ 权重
✅ 稀疏微调+蒸馏训练代码
✅ RTX 5090/H100 推理脚本
✅ 统一加速框架 (稀疏+蒸馏+量化一体化)
✅ 跨模型支持 (Wan2.1/Wan2.2, T2V/I2V, 480P/720P)

论文标题: SparkDiffusion: Mitigating the High-Sparsity Trap — A Unified Framework for up to 265× Single-GPU Acceleration of Visual Generation
论文地址:https://arxiv.org/abs/2609.23153
项目主页: https://sparkdiffusion.github.io/
GitHub: https://github.com/AlibabaResearch/SparkDiffusion
权重链接: https://huggingface.co/collections/alibabagroup/sparkdiffusion
RoLA 论文: https://arxiv.org/abs/2609.06712
CrossDistill 论文: https://arxiv.org/abs/2609.14725
总结与展望
SparkDiffusion 将 DiT 视频生成加速从"分散优化单个组件"推进到"端到端系统化加速":
核心贡献:
首次识别并命名"高稀疏陷阱" — 极致稀疏率下逐步训练失效的现象
诊断根因 — 高噪声阶段的结构误差会沿轨迹累积
分阶段解法 — 先稀疏预热建立粗略先验,再轨迹混合蒸馏修正终端分布
统一框架 — 首个整合稀疏+蒸馏+量化的完整开源系统
实测成果:
RTX 5090 单卡: 265 倍加速 (720P-14B, 18 秒生成 5 秒视频)
H100: 220 倍加速 (同配置,8 秒生成)
质量保持: VBench-2.0 仅下降 0.5 点(从 60.2→59.77)
研究团队希望这项工作能够为视频生成落地提供新的思路,在高稀疏度下激发消费级显卡视频生成的速度上限,让消费级显卡也能高质量生成视频。
下一步计划
团队正在将该框架扩展至:
AR 自回归视频生成 — 跨帧误差累积正是终端对齐监督的下一个突破口
全模态生成 — 跨模态、超长序列场景下的稀疏优化空间更大
AR 扩展、全模态生成的后续进展,敬请期待。

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com