国产算力的故事,正在进入更关键的一章。
过去几年,产业关注的重点更多是有没有。但有没有之后,更难的问题正在浮现:能否稳定运行?能否适配复杂工业场景?能否在万卡集群中真正跑出有效算力?
工业算力对此感受尤为直接。工业生产对可靠性、实时性和系统稳定性的要求远高于一般云端应用,国产算力要真正进入工业现场,考验的不只是GPU性能,还包括互连、存储、软件生态以及最终的生产实践。
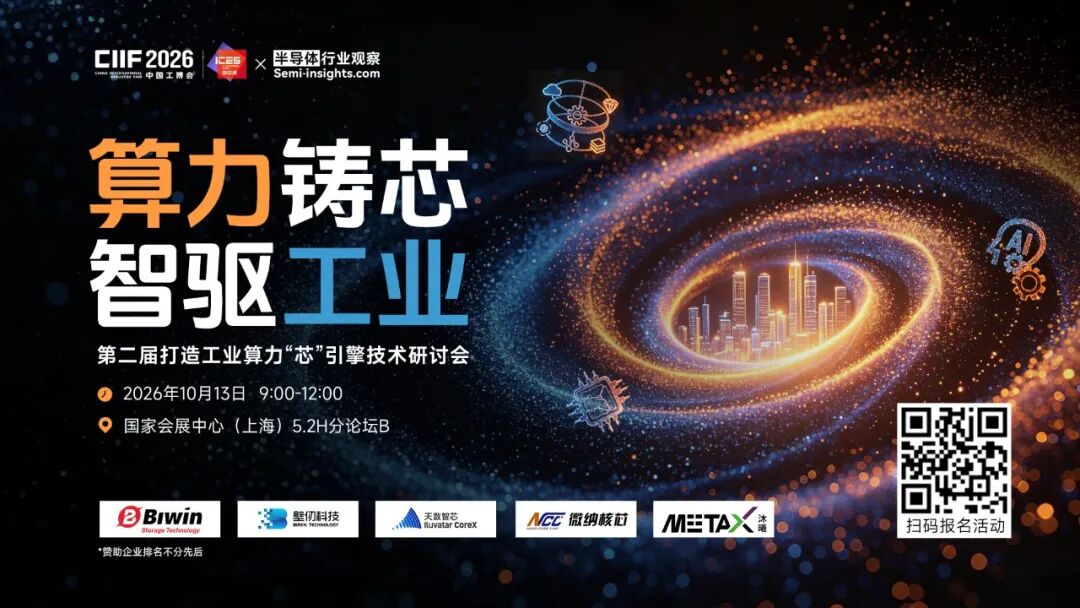
在这一背景下,由国芯展主办、半导体行业观察承办的第二届工业算力芯引擎研讨会,将于2026年10月13日上午在上海举行。围绕GPU架构、工业应用、存储、软件生态与存算架构等关键环节,产业链不同位置的企业将共同讨论国产算力走向工业现场的现实路径。
先看周期,再看算力
技术浪潮之下,产业景气度始终是绕不开的背景变量。本次研讨会将由半导体综研主理人关牮老师开场,围绕半导体行业景气度的原理与分析方法展开分享。

这一轮AI算力需求正在向上游持续传导,GPU、HBM、服务器以及相关设备材料环节均受到影响。与此同时,国产替代、存储价格变化和算力基础设施投资也在重新塑造产业链的供需关系。
工业算力究竟处于怎样的产业位置?眼下的需求增长有多少来自周期,有多少来自新的结构性需求?这些问题,将成为理解后续技术演进的重要坐标。
活动议程
观众签到+暖场
半导体行业景气度原理及分析
关牮|半导体综研主理人
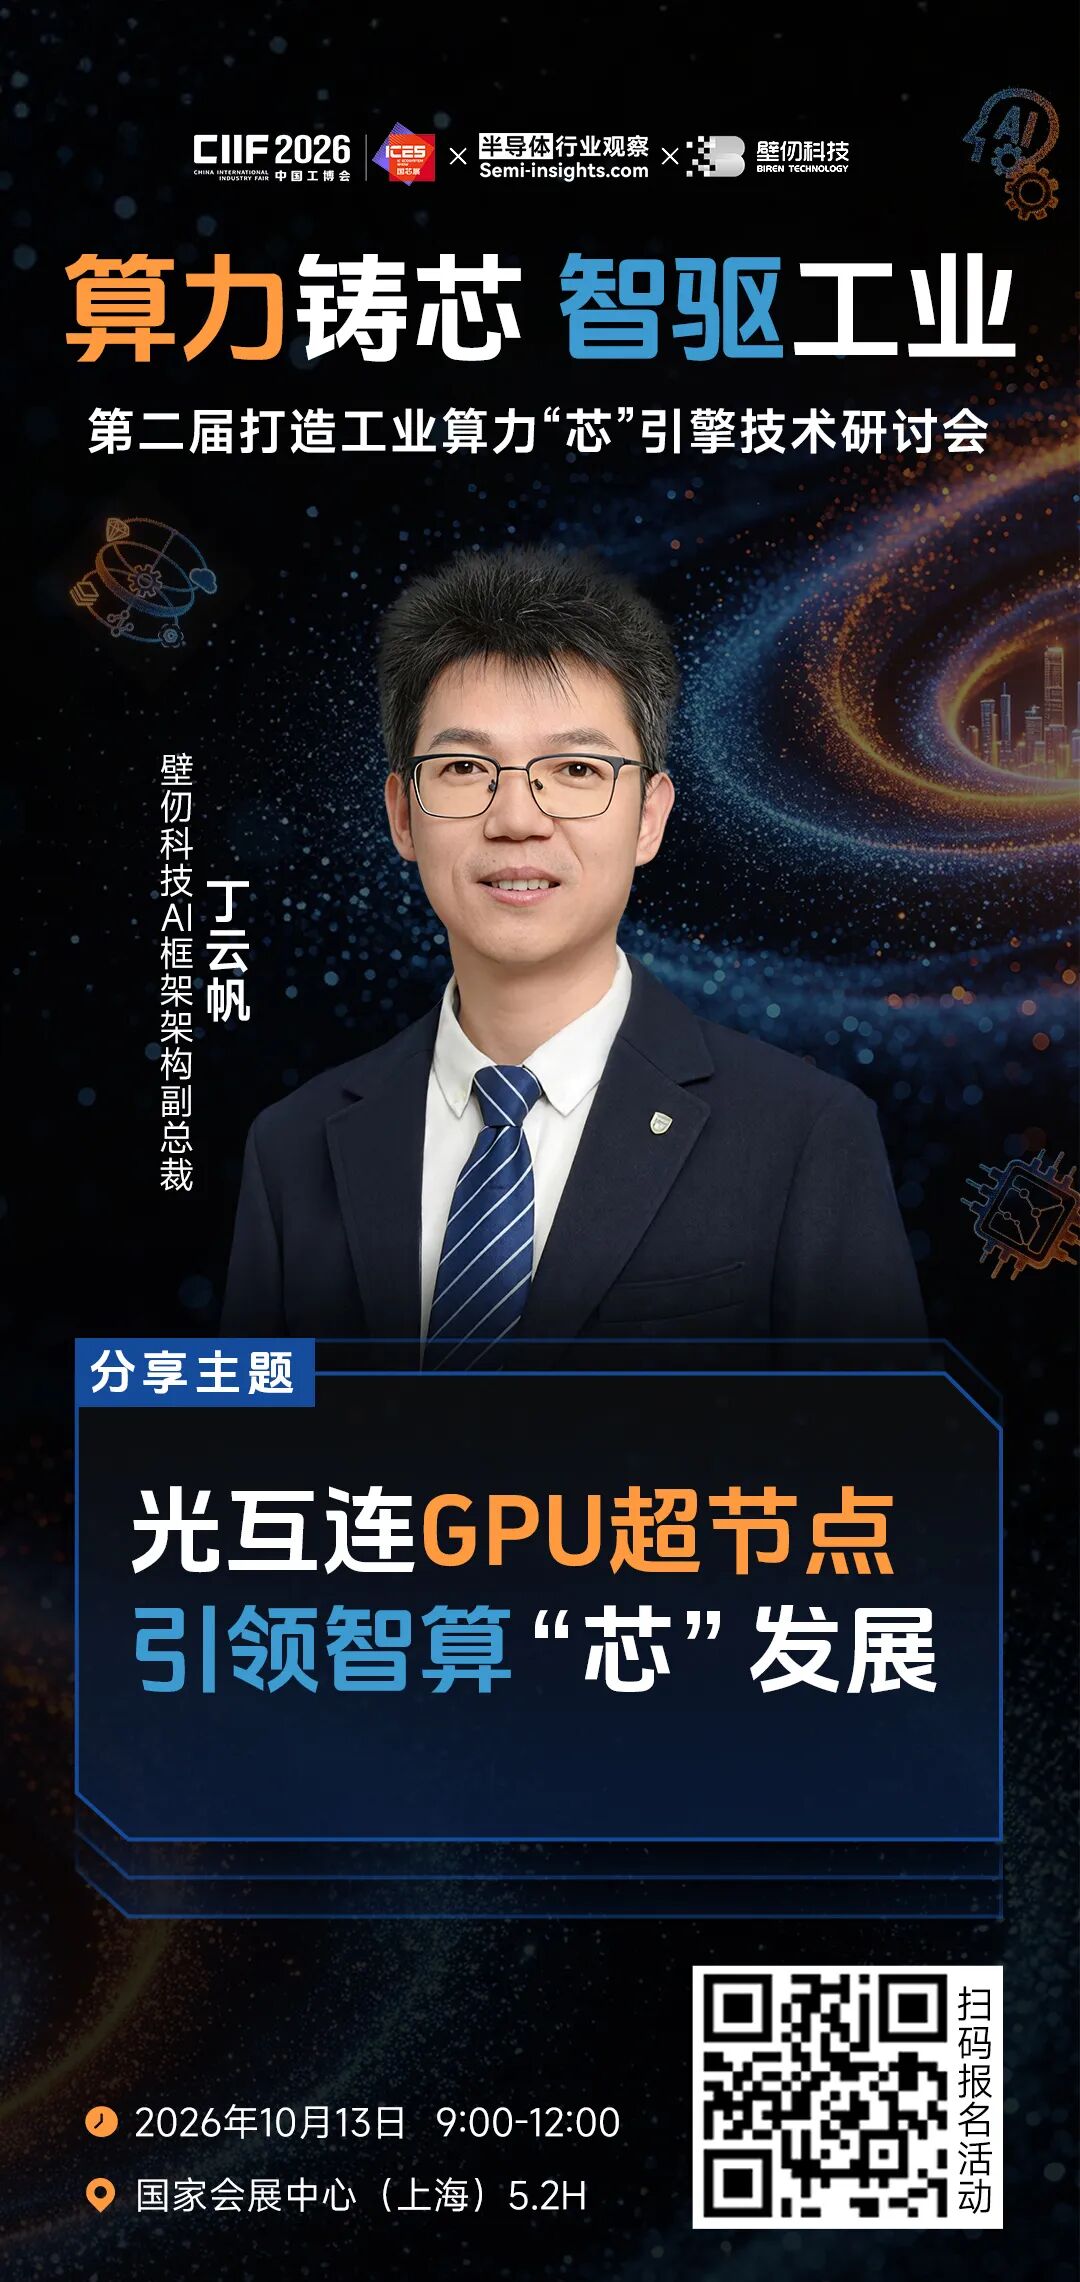
光互连GPU超节点,引领智算“芯"发展
丁云帆 壁仞科技AI框架架构副总裁
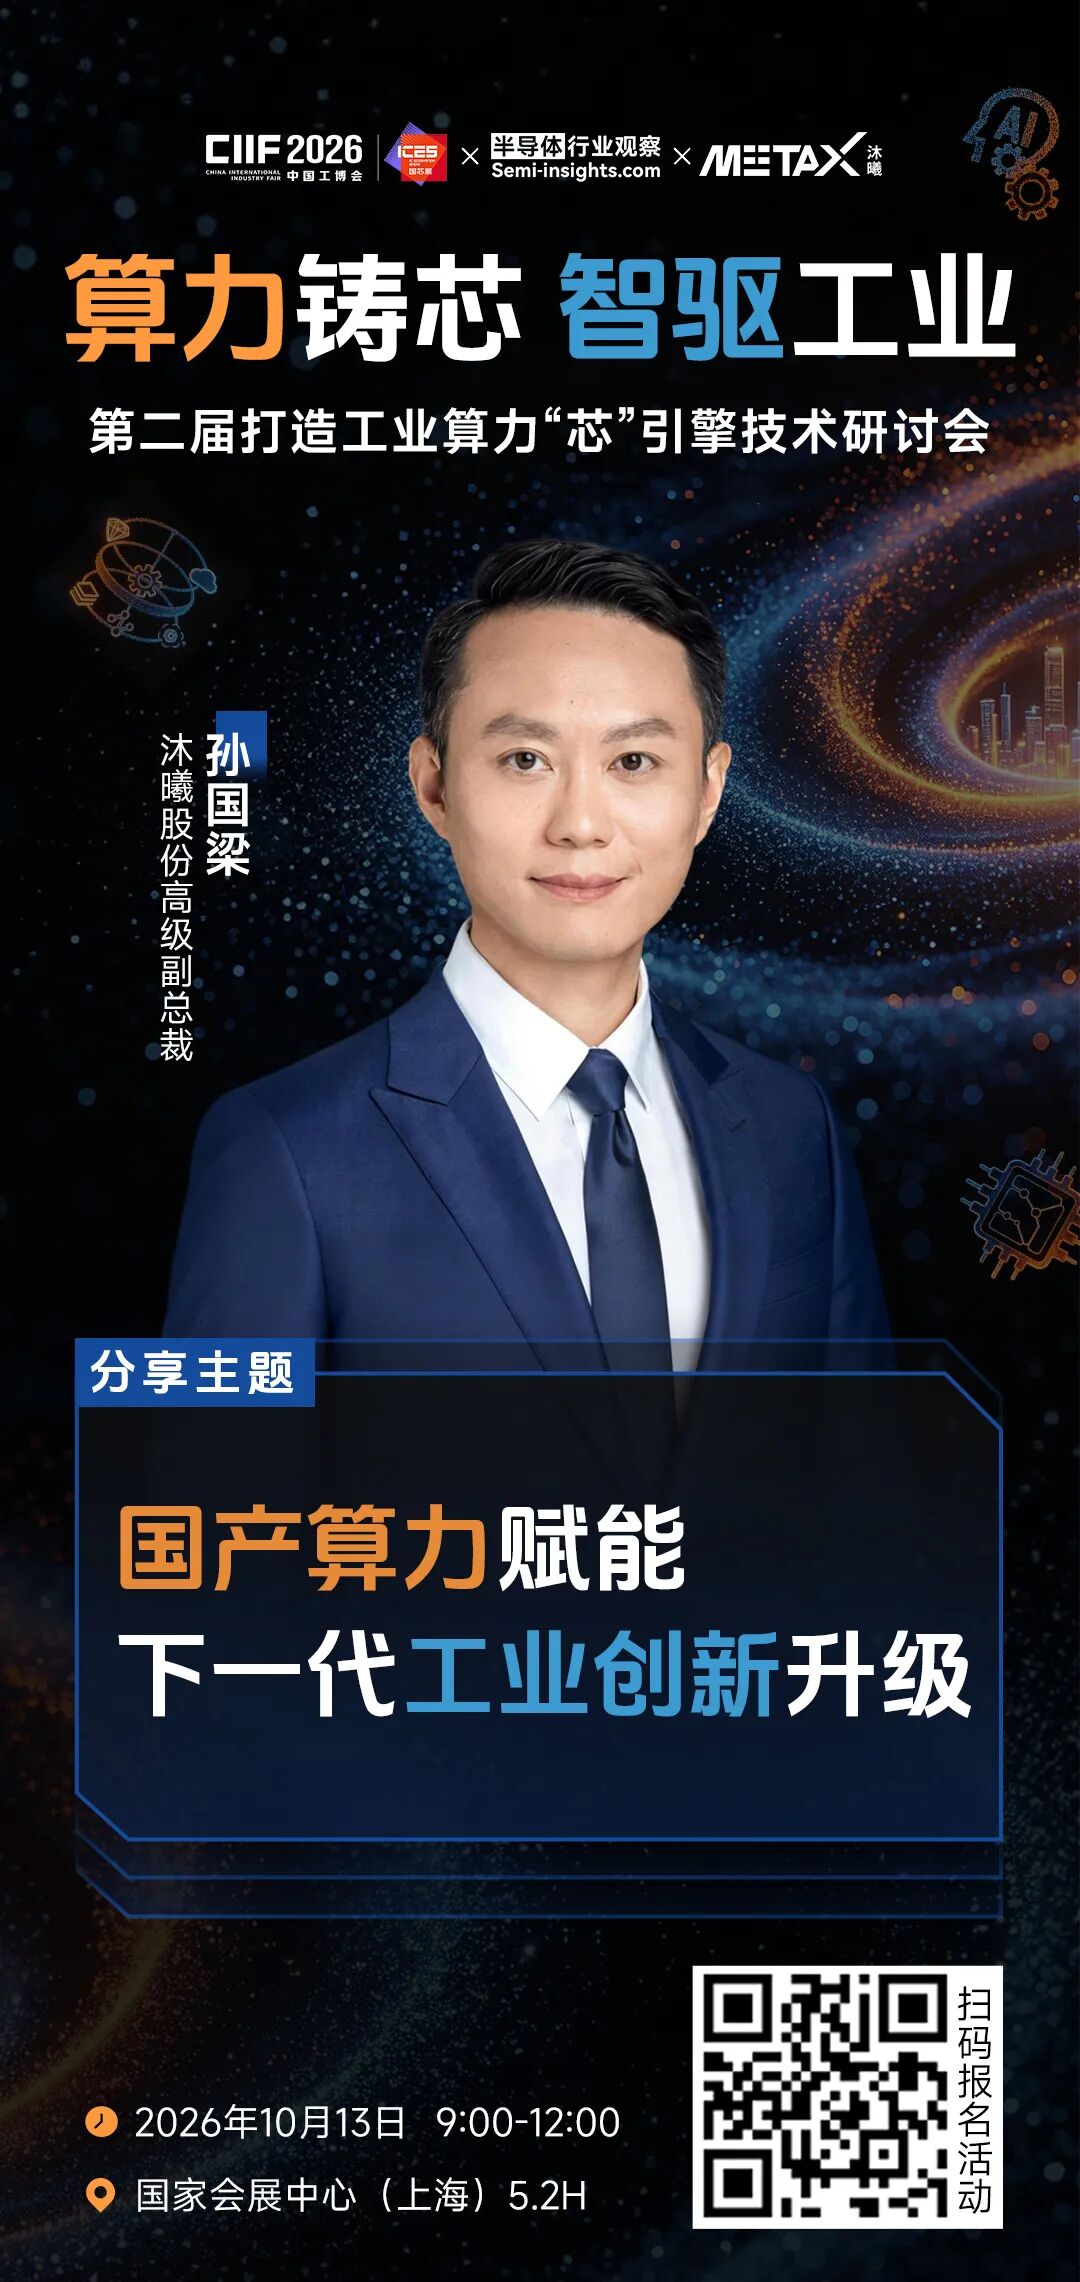
国产算力赋能下一代工业创新升级
孙国梁 沐曦股份高级副总裁
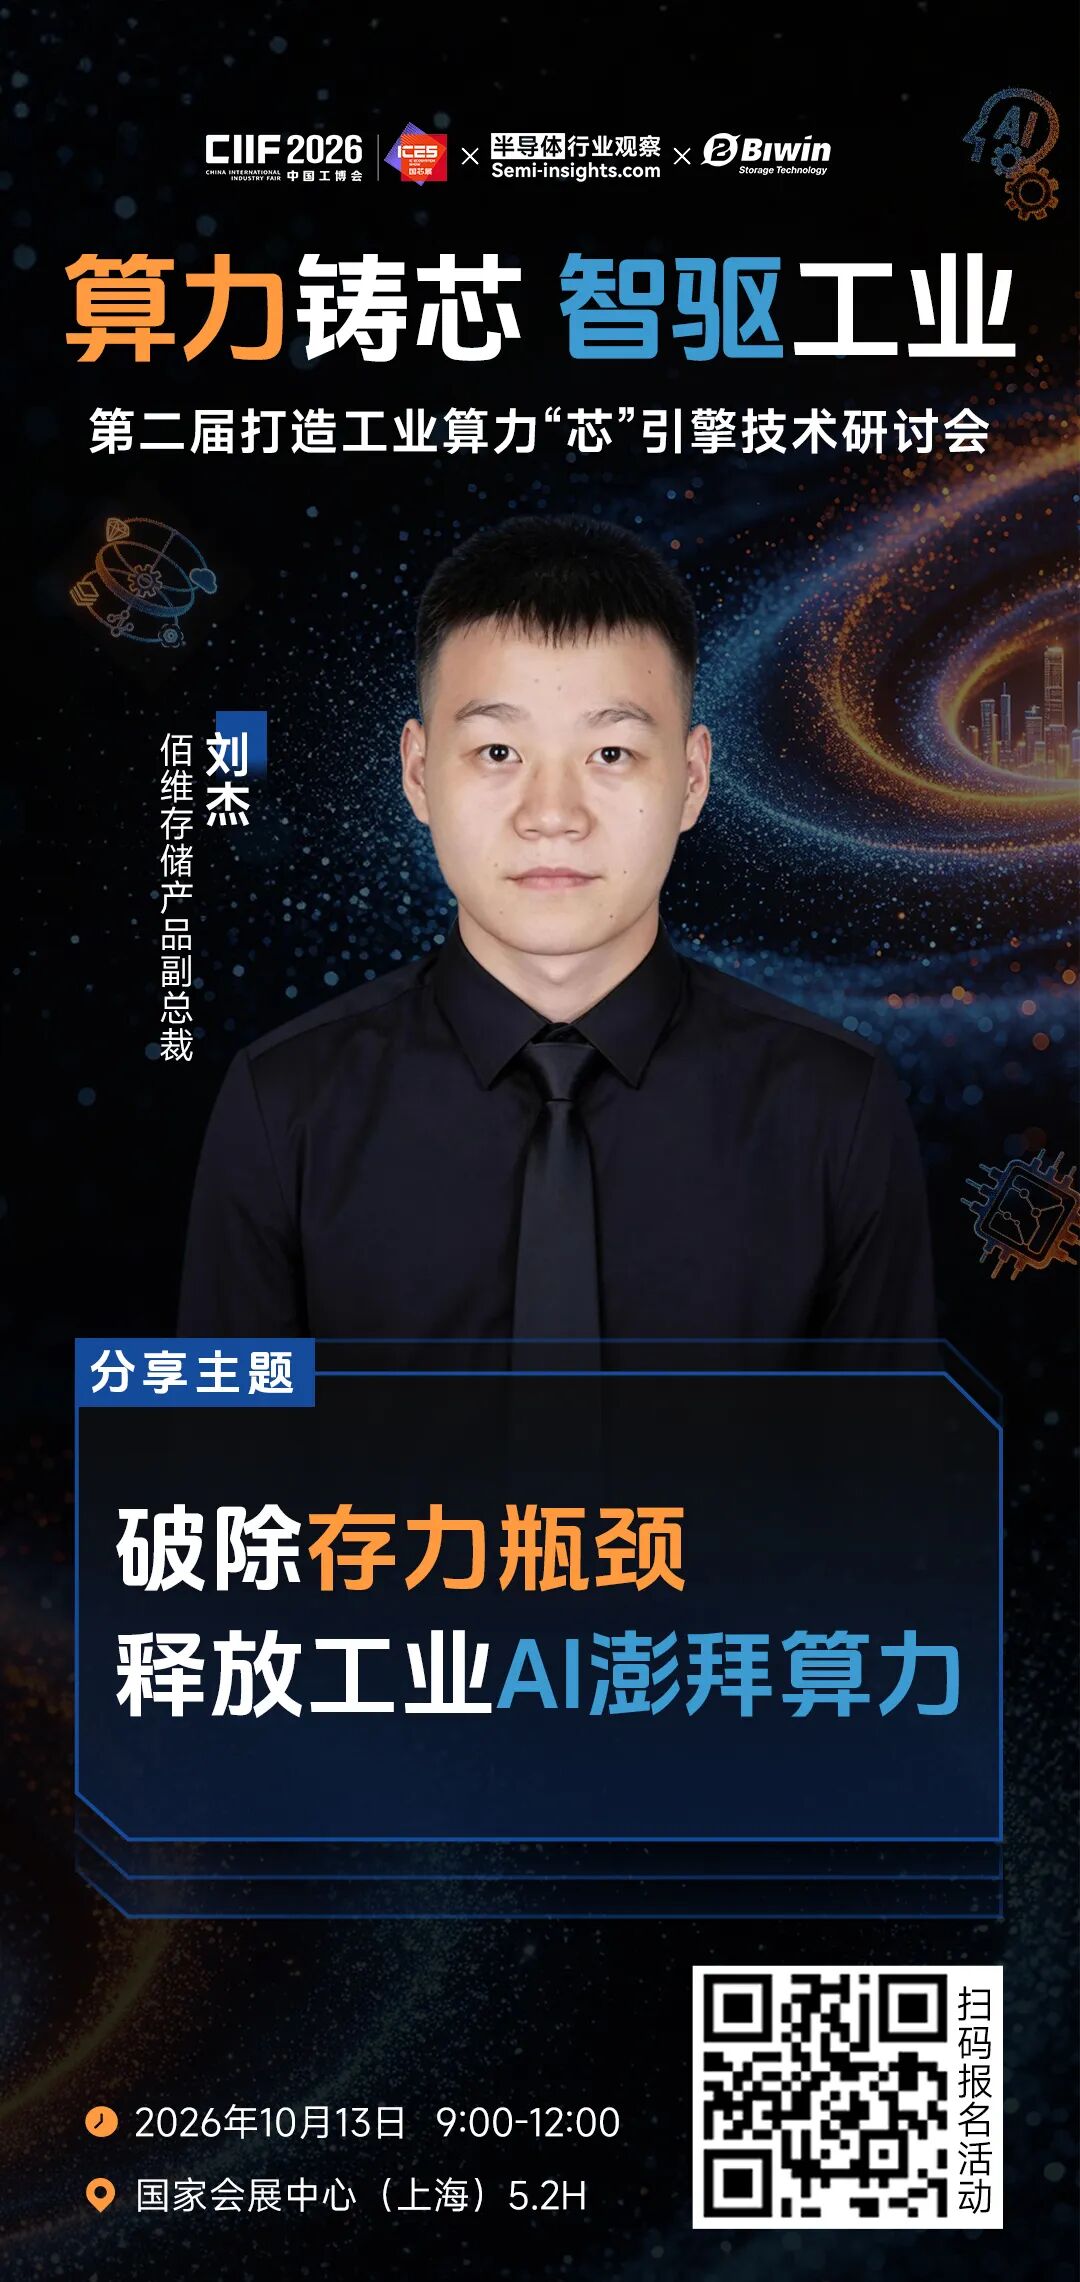
破除存力瓶颈,释放工业AI澎湃算力
刘杰 佰维存储产品副总裁
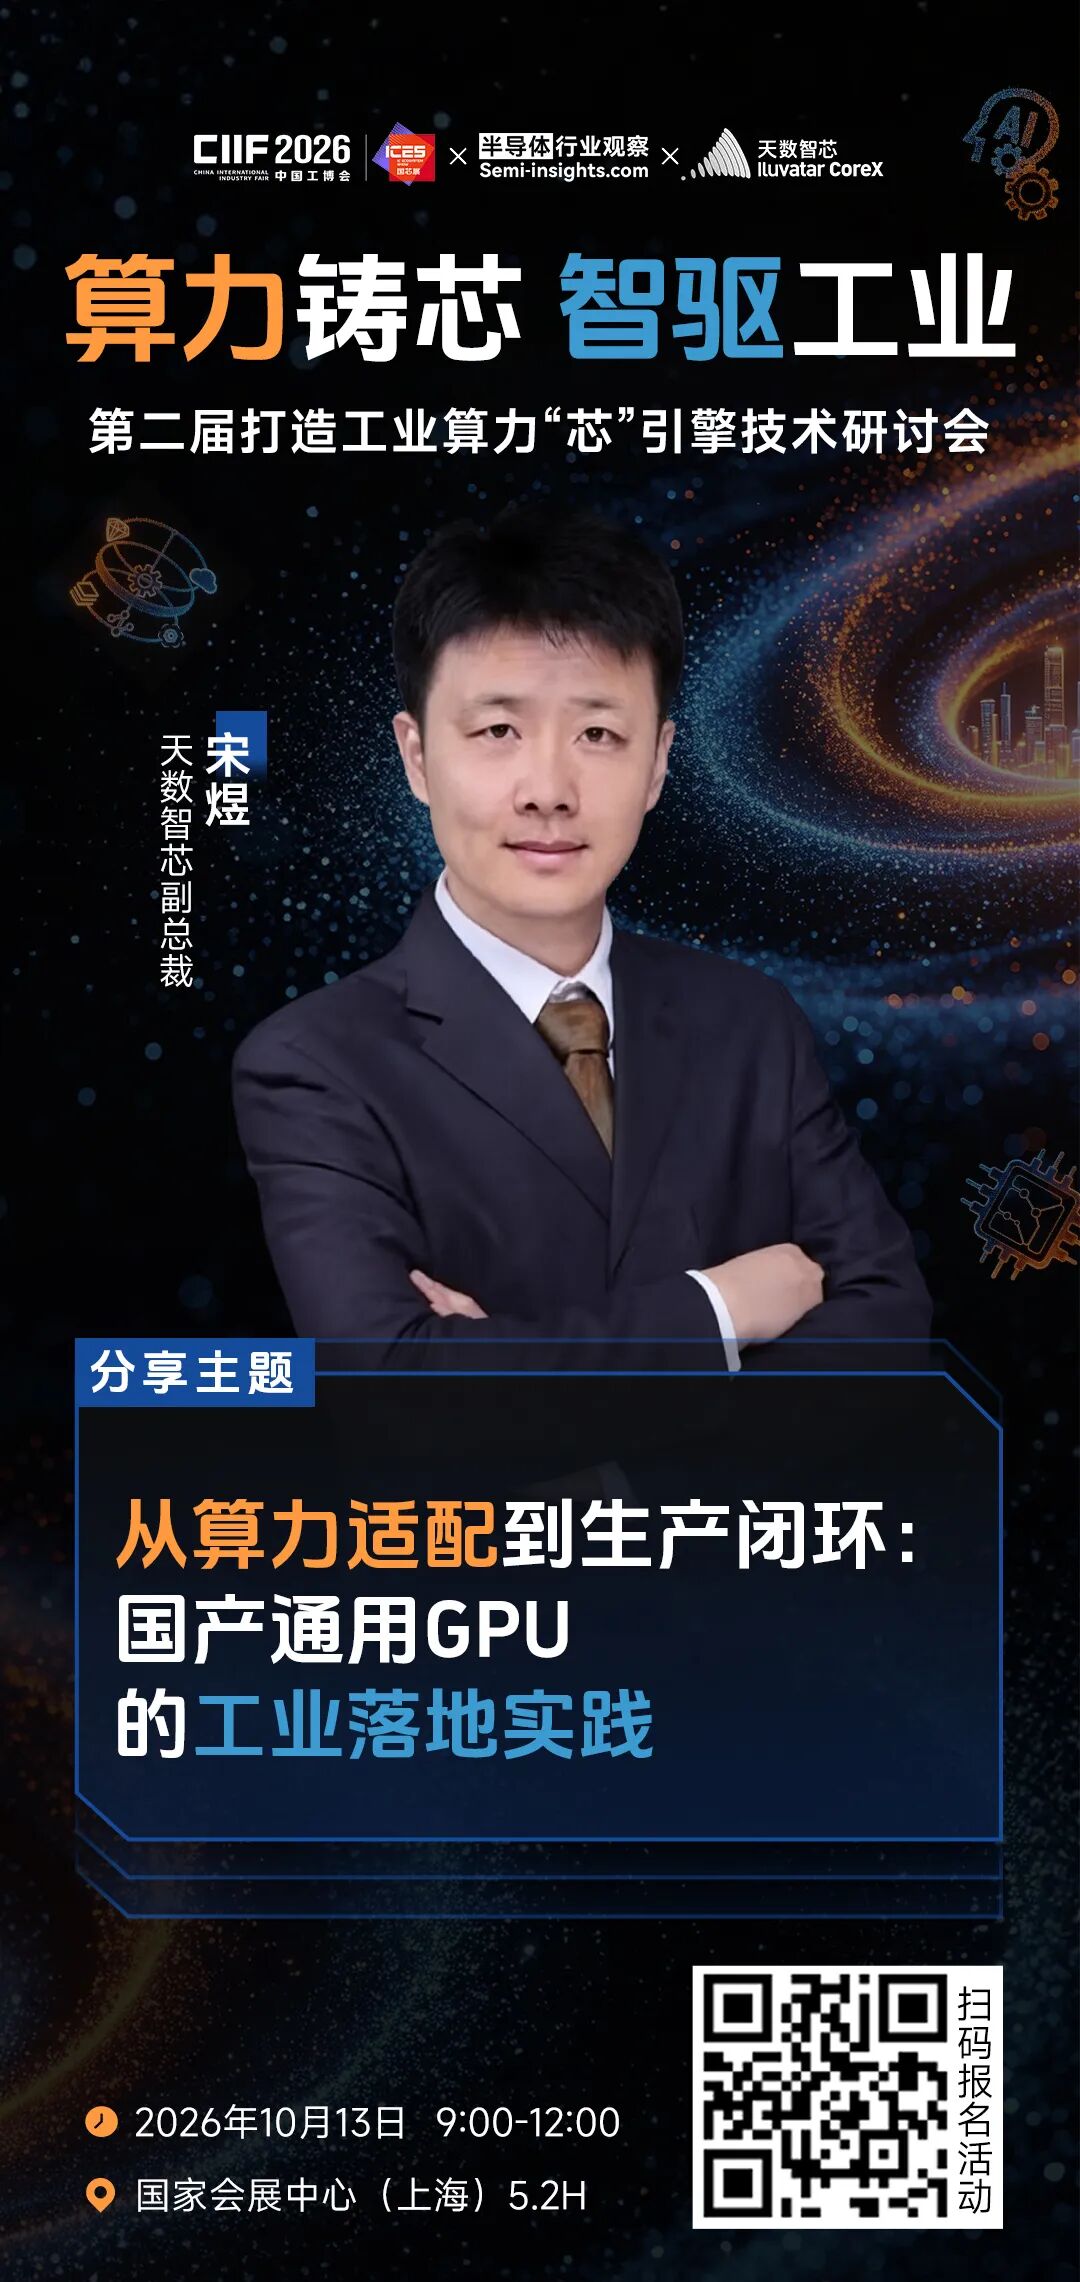
从算力适配到生产闭环:
国产通用GPU的工业落地实践
宋煜 天数智芯副总裁
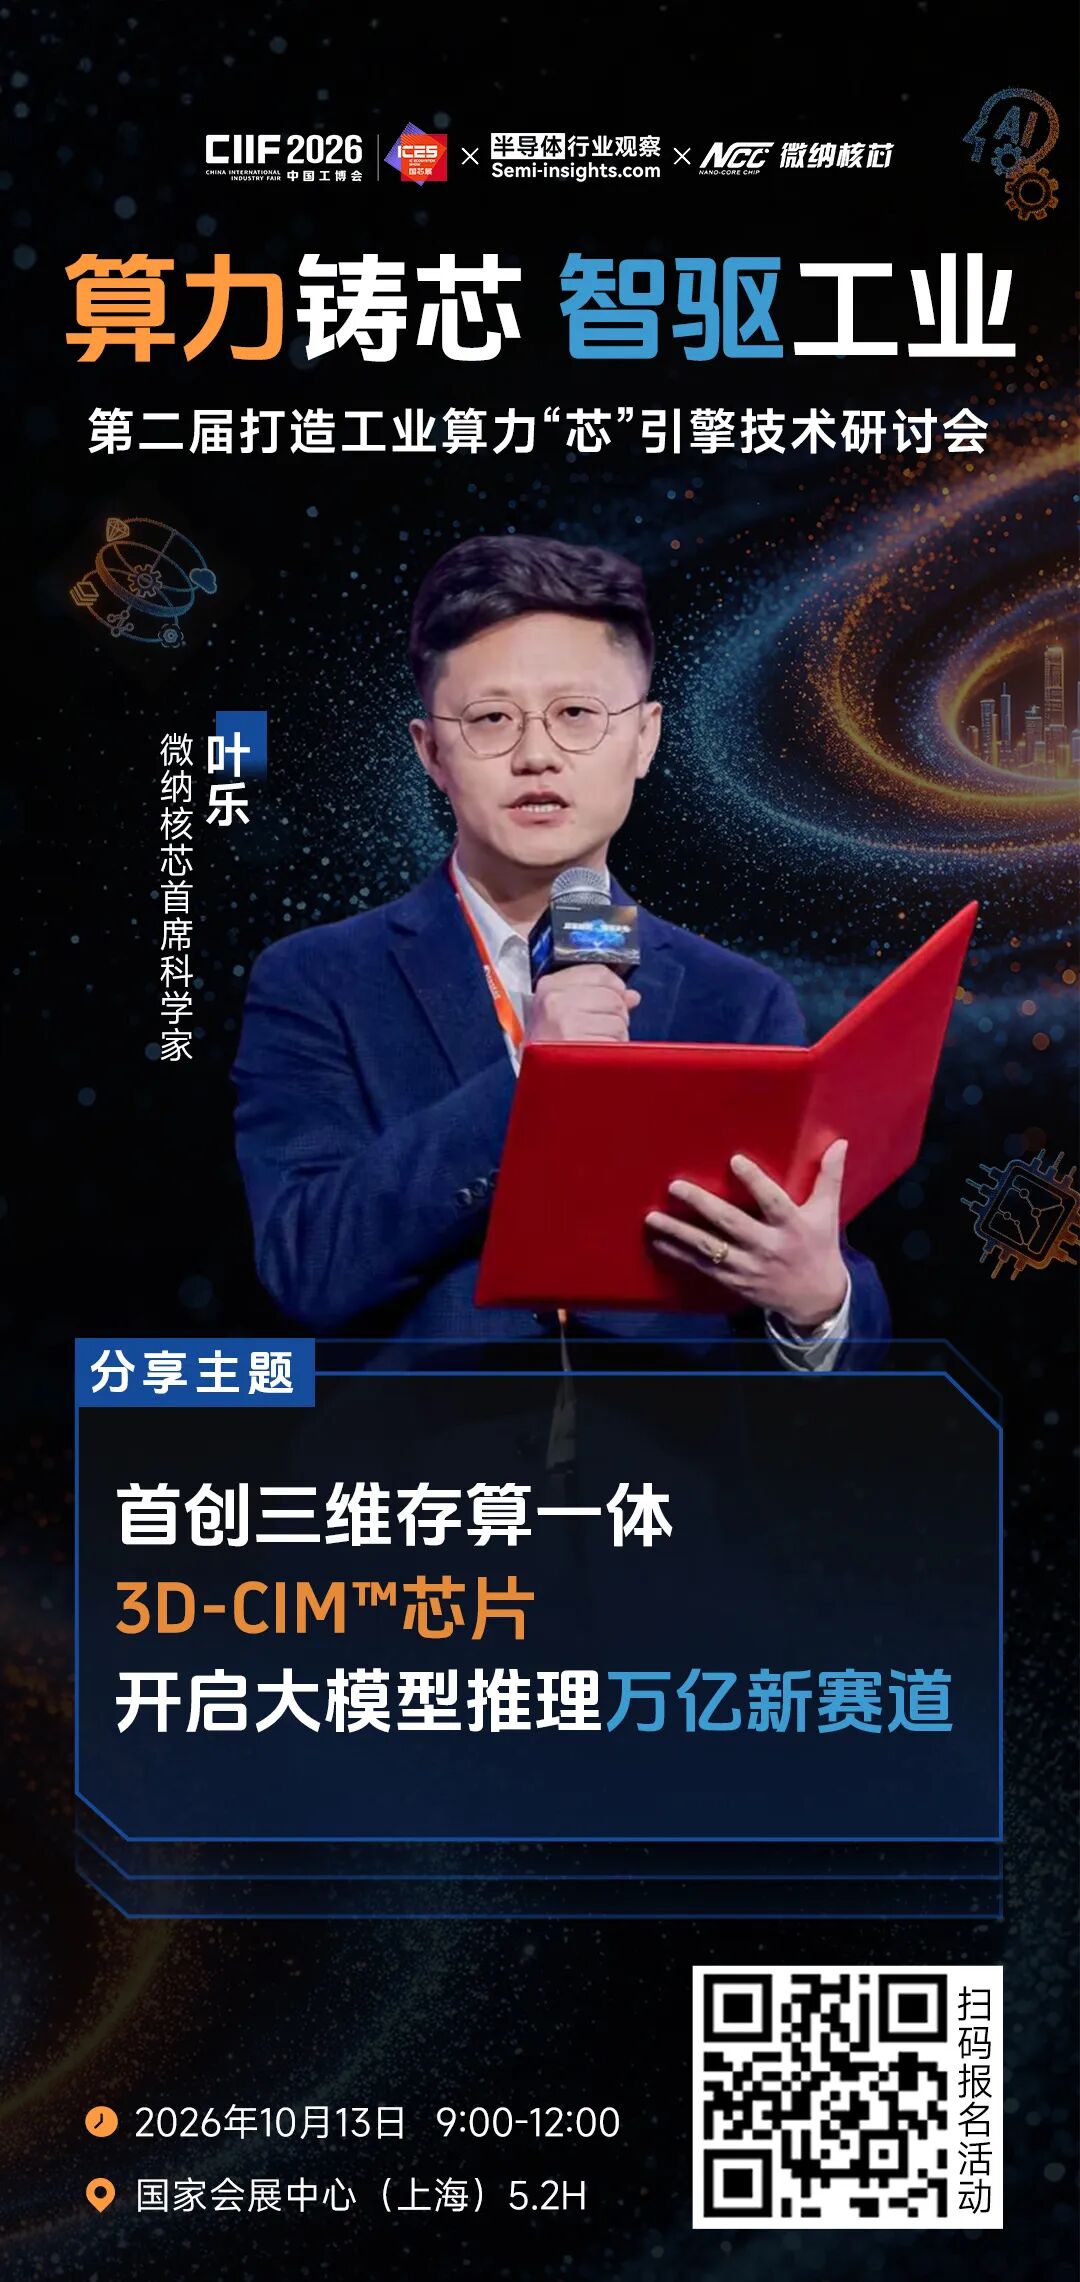
首创三维存算一体3D-CIMTM芯片:
开启大模型推理万亿新赛道
叶乐 微纳核芯首席科学家
结束
*最终议程或有调整,以官方公布为准
扫描下方二维码即可报名👇

GPU互联的核心战场
当AI模型越来越大,算力的竞争就不再只是单卡性能的竞争。壁仞科技AI框架架构副总裁丁云帆将带来《光互连GPU超节点,引领智算“芯”发展》的主题演讲,聚焦下一代GPU超节点的架构演进。
目前,大规模GPU集群正在成为AI基础设施的重要形态,但当节点规模继续扩大,传统电互连在带宽、功耗、距离以及系统扩展等方面面临越来越明显的挑战。光互连因此开始从数据中心网络进一步进入GPU计算系统内部。
今年WAIC期间,壁仞科技推出下一代NPO光互连、分布式解耦架构超节点方案,支持单个超节点1024卡Scale-up扩展,并通过BLink 2.0互连协议实现大规模GPU协同。
丁云帆长期负责AI软件架构、大模型千卡万卡集群及超节点相关工作,此次演讲,他将从光互连GPU超节点切入,进一步讨论大规模GPU协同背后的架构与技术路径。
国产GPU落地工业
算力规模扩大之后,另一个问题随之而来:这些算力究竟如何进入具体行业?沐曦股份副总裁孙国梁将围绕《国产算力赋能下一代工业创新升级》展开分享。
过去几年,国产GPU已经逐渐从研发验证走向商业化落地。沐曦2025年实现营收16.44亿元,同比增长121%,GPU累计出货突破5.5万颗。相比单纯追求峰值性能,工业客户更关心的,是算力能否适配真实业务,并在长期运行中形成稳定的投入产出关系。
这也让工业场景成为检验国产GPU产品成熟度的重要应用环境。对于国产算力而言,进入工业并不是简单地增加几张GPU,而是需要进一步打通硬件、软件、算法和具体业务流程。
沐曦此次分享,将从国产GPU产品与产业生态的角度,进一步讨论算力如何服务下一代工业创新。
破除存力瓶颈
GPU不断增加,存储系统同样承受着越来越大的压力。佰维存储产品副总裁刘杰将带来《破除存力瓶颈,释放工业AI澎湃算力》的主题演讲。
AI服务器正在改变传统存储需求结构。随着模型规模扩大,单台AI服务器的DRAM用量已经达到传统服务器的数倍,HBM等高性能存储也持续面临供给压力。对于工业AI而言,大量数据的实时处理进一步放大了带宽、容量和访问效率的重要性。
因此,算力基础设施的升级并不只是GPU数量的增加,存力同样决定着这些计算资源能够释放多少实际性能。
佰维存储近年来持续向芯片设计、先进封测以及CXL DRAM等企业级存储方案延伸。佰维存储此次分享,也将把讨论从“算得更快”进一步拉向“数据如何跟得上”,寻找工业AI存力瓶颈的解决路径。
打造算力生产闭环
如果说GPU和存储解决的是基础设施问题,那么真正进入工厂之后,考验的就是算力与业务的适配能力。天数智芯副总裁宋煜将分享《从算力适配到生产闭环:国产通用GPU的工业落地实践》的主题演讲。
工业场景并不以Benchmark作为最终标准。一套算力系统能否稳定运行,能否适配已有的软件环境,能否真正改善生产效率、降低成本,最终都要在具体业务中得到验证。
目前,天数智芯已经形成覆盖训练、推理、边缘计算等场景的通用GPU产品体系。此次分享,天数智芯将进一步把视角落到生产闭环,讨论国产通用GPU如何从芯片能力走向实际业务价值。
算力的另一条路
如果前面的讨论更多是在完善GPU主导的算力体系,那么存算一体则提供了另一种思路。微纳核芯CEO叶乐将带来主题为《首创三维存算一体3D-CIM™芯片,开启大模型推理万亿新赛道》的演讲。
随着推理需求快速增长,传统冯·诺伊曼架构下数据搬运带来的功耗与效率问题越来越受到关注。存算一体试图把计算进一步靠近数据,通过架构变化减少数据搬运,提高计算密度与能效。而微纳核芯的3D-CIM™架构融合DRAM三维近存计算、SRAM存内计算与RISC-V异构存算,探索面向大模型推理的新型计算路径。
对于国产算力而言,这类探索的意义在于,当GPU体系继续演进的同时,产业是否还能够打开新的计算架构空间。
请上下滑动查看
工业算力,下一阶段拼什么?
从行业景气度,到GPU超节点,再到工业应用、存储基础设施与新型计算架构,本届研讨会所覆盖的,实际上是国产算力从芯片走向系统,再走向生产现场的几个关键环节。
工业算力的竞争正在逐渐脱离单一芯片性能的比较。GPU需要解决规模扩展,存储需要匹配数据吞吐,软件需要完成软硬件适配,而最终所有技术都要回到具体的工业业务中接受验证。
国产算力真正进入工业深水区之后,拼的或许不再只是有没有一颗性能足够高的芯片,而是能否把芯片、互连、存储、软件和应用组织成一个稳定运行的系统,并最终转化为真实的生产效率。
10月13日,第二届工业算力芯引擎研讨会,与产业链上下游一道,把国产算力下一阶段的问题推向更深处。
目前会议报名通道已正式开启,席位有限,优先锁定行业核心参会资源!
👇👇

联系人:Aaron
联系方式:13167968615
点这里👆加关注,锁定更多原创内容
*免责声明:文章内容系作者个人观点,半导体芯闻转载仅为了传达一种不同的观点,不代表半导体芯闻对该观点赞同或支持,如果有任何异议,欢迎联系我们。
推荐阅读
喜欢我们的内容就点“在看”分享给小伙伴哦~