点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
一、3D动态预训练的死锁:要学动作,先得有机器人
世界模型的核心使命是让感知系统能够预测场景在交互下如何演化。这类模型最受益于大规模多样化数据的预训练——数据越多、越杂,学到的先验就越丰富,下游应用就越省力。但当前的3D动态模型走进了一个死胡同。
主流方法要求机器人动作标签来学习动作条件化的3D动态。这意味着模型必须看到“机械臂施加了多大的力、往哪个方向推”这类具身特定的标注。问题在于,机器人交互数据的采集成本极高,而互联网上浩如烟海的视频——一个人折叠衣服、拉动抽屉、踢开一扇门——虽然包含了丰富的动态信息,却因为缺少动作标签而被排除在训练池之外。
这个死锁的根源在于一个隐含假设:学习动态必须先知道动作。但工作提出了一个反直觉的替代方案:如果动作本身可以被表示为3D空间中点的运动呢?折叠衣服的动作,本质上就是布料上每个点的位移轨迹;推抽屉的动作,就是抽屉表面点的运动。动作和状态在3D点轨迹这个表示下统一了。
PointWorld的研究也探索了类似的方向,通过3D point flows统一状态和动作,但其训练需要真实世界的机器人交互数据。PointZero则更进一步:预训练阶段完全不需要机器人,只需要RGB-D观测和点轨迹。

图1 展示了PointZero的核心思路。给定一张RGB-D图像和少量点轨迹(橙色箭头),PointZero预测所有观测场景点的未来3D轨迹。这是一个无需机器人的预训练目标。
二、架构:一个Transformer同时搞定几何、动作与视觉
PointZero的架构简洁但高效。它将点云几何、动作轨迹和视觉特征统一编码到一个扩散Transformer中,从噪声中预测目标状态。
点token方面,观测点云 中每个点的初始位置在 个未来帧上重复,形成 ,通过共享MLP嵌入为 。
部分点轨迹token方面,对于每个时间步 和轨迹索引 ,将3D坐标 嵌入后加上时间嵌入 和轨迹索引嵌入 ,得到 。这种设计让模型能够区分不同时间步和不同轨迹的语义,同时保持对轨迹数量的灵活性——实验表明 即可提供足够的条件化信息。
视觉token方面,使用DINOv2提取稠密图像特征,再通过Perceiver-IO模块压缩为 个视觉token:
Perceiver-IO的交叉注意力机制在处理大规模点云时具有线性复杂度优势,这对于PointZero需要同时编码点云、动作和视觉三种模态至关重要。
DiT采用自注意力与交叉注意力交替的层结构。每个点的查询将当前噪声未来轨迹 与初始位置 拼接后投影,交叉注意力的键和值由点、动作和视觉嵌入拼接而成:。

图2 展示了PointZero的架构概览。模型接收单张RGB-D图像和少量完整点轨迹,预测稠密3D点轨迹。PointZero可以微调为以机器人位姿为条件,或额外输出机器人动作块。
三、训练目标:回归、流匹配与JiT的完整光谱
工作探索了三种训练目标,覆盖了从确定性回归到生成式建模的完整光谱。
回归直接预测轨迹:
流匹配(v-prediction) 在高斯噪声和目标之间插值,训练模型预测速度场:
JiT-style(x-prediction) 直接预测去噪后的轨迹,监督隐含速度。JiT的核心论点是自然图像位于像素空间的低维流形上。工作将这一思想迁移到3D轨迹预测:由于PointZero不使用低维VAE编码3D流,数据本身位于低维流形上,JiT的x-prediction策略同样适用:
训练中给后续时间步更高的权重,强调长时程预测——越远的未来不确定性越大,越需要精确监督。权重公式为 。
四、2.9M帧数据集:可变形、铰接、刚性物体全覆盖
工作贡献了一个大规模合成数据集,包含290万帧,覆盖可变形物体(毛巾、T恤、短裤)、铰接物体(PartNet-Mobility)和刚体(Kubric引擎),运动由随机交互驱动。
可变形物体方面,工作采用程序化布料生成,随机化尺度和比例,使用NVIDIA Flex建模物理,应用折叠、提起、掉落或推动等动作轨迹。铰接物体方面,从PartNet-Mobility检索物体,在Genesis中模拟运动,随机选择旋转或平移关节。刚体方面,修改Kubric引擎以包含真值3D轨迹并减少物体数量。
数据集的关键特征是逐点轨迹的稠密标注,每一帧中每个点的未来轨迹都有真值。类别混合比例为可变形约42.67%、铰接约43.10%、刚体约14.22%,大致为3:3:1,反映了工作对复杂非刚性和铰接动力学的侧重。
为评估零样本仿真到现实的迁移,工作还采集了14个真实世界物体、124次交互的数据集,使用FoundationStereo和CoTracker3获得动作和点轨迹标签。

图3 展示了数据集概览。包含290万合成图像帧,覆盖可变形、铰接和刚性物体,以及真实世界14个物体、124次交互的零样本迁移评估集。
五、实验结果:从合成到真实,从预训练到下游
合成数据集上的动态预测
表1 展示了在合成数据集留出样本上的动态预测误差。所有基线都在相同数据集上训练。PointZero的每个变体在每个指标、每个物体类别上都超过了所有基线。以可变形物体为例,PointZero-JiT-oracle-10的MDE为2.85 cm,而最强的基线PGND为9.01 cm。生成式目标(FM和JiT)优于回归变体,表明模型捕获了合理点轨迹的多模态分布。

工作还提供了更细致的分布统计。PointZero-FM-pooled-scalar-median-10在可变形物体上的MDE仅为3.21 cm,铰接物体上为1.75 cm,刚性物体上为11.65 cm。铰接物体上的1.75 cm意味着模型对关节运动的预测精度达到了亚厘米级。
真实世界零样本点轨迹补全
在未见过的真实物体上,所有方法仅在合成数据上训练、不做微调。【表9位置:工作Table 9】 显示,PointZero-FM和PointZero-JiT在12项真实世界指标中的11项上超过所有基线。工作指出,GBND经常预测零运动,而PTv3和PGND难以恢复刚性(铰接)运动。
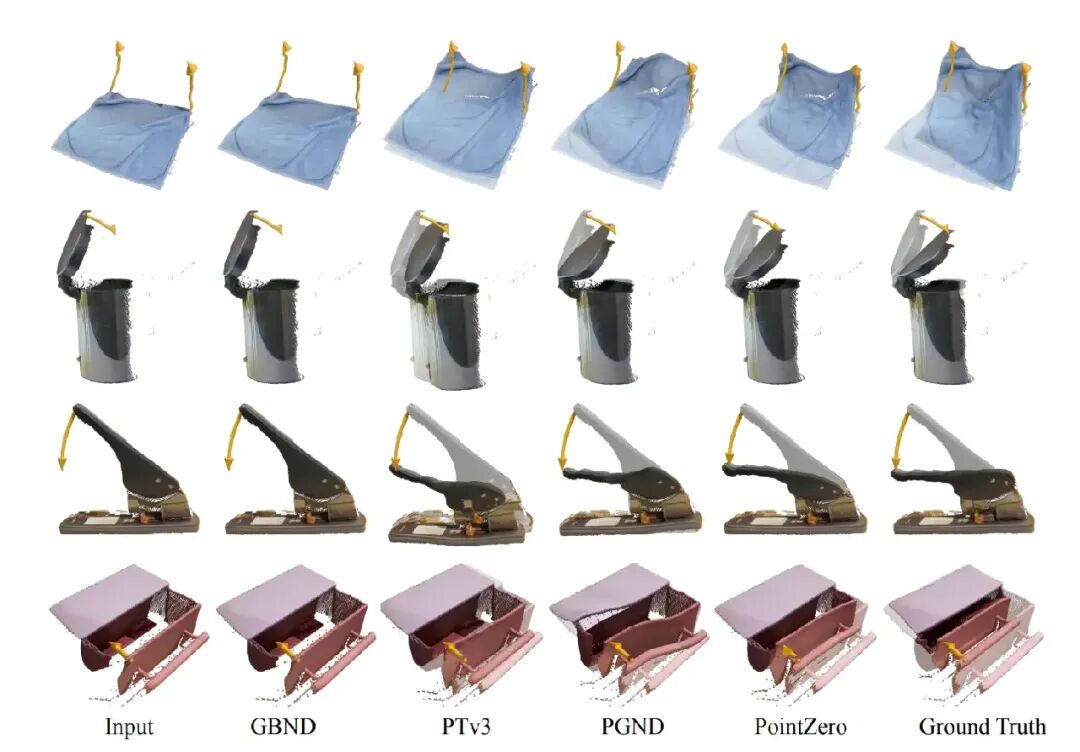
图4 展示了真实世界3D点轨迹补全的定性评估。PointZero在遵循输入轨迹动作和保持物体物理结构方面表现出色。
后训练一:动作条件化3D动态预测
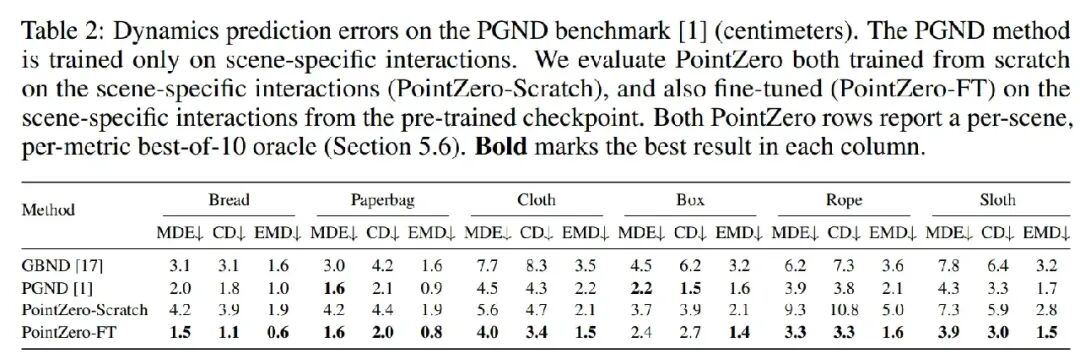
在PGND基准的6个场景上,PointZero后训练后在4/6场景上显著优于SOTA基线。表2 显示,PointZero-FT在Bread场景的MDE为1.5 cm(PGND为2.0 cm),在Paperbag上为1.6 cm(PGND为1.6 cm),在Cloth上为4.0 cm(PGND为4.5 cm)。更重要的是,PointZero-Scratch(从随机初始化训练)的性能远低于PointZero-FT,证明预训练是强预测的关键。
后训练二:机器人操作模仿学习
表3 展示了模仿学习的成功率。PointZero在7个操作任务中的6个上取得最高或并列最高成功率。仿真任务中,Blockstack达到99.8%,Microwave达到93.1%,Glass达到95.9%。真实世界任务中,Drawer达到100%,Cup达到100%,Sock达到90.0%。

工作进一步隔离了预训练本身的贡献。表4 显示,使用20条动作标注演示且无额外视频时,预训练将平均成功率从80.5%提升至88.2%(带辅助点轨迹监督)。表5 显示,不带下游点轨迹监督时,预训练配方达到**80.0%,而从零训练仅为74.1%**。Glass任务上的差距最大:64.6% vs 49.1%。
六、相关工作全景:3D动态预训练的三条路线
PointZero不是孤立的贡献。将其置于更广阔的学术脉络中,可以清晰地看到3D动态预训练领域正在形成的三条技术路线。
路线一:点轨迹作为中间表示。 3PoinTr同样使用3D点轨迹作为预训练目标,但它的出发点是从人类视频中学习操作策略。3PoinTr预测稠密3D点轨迹,然后将闭环多任务策略条件化在这些轨迹上,其优势在于能够保留对部分遮挡点的监督。PointZero与3PoinTr的关键区别在于预训练阶段的条件化信号:3PoinTr需要任务相关的轨迹预测,而PointZero只要求从稀疏轨迹补全稠密轨迹,这一更弱的要求使得PointZero能够利用更广泛的训练数据。
路线二:动作条件化的3D世界模型。 PointWorld是一个大规模预训练的3D世界模型,将状态和动作统一表示为3D点流,在约200万条轨迹上训练,单个检查点即可驱动真实Franka机械臂完成刚体推动、可变形物体操作、铰接物体操作和工具使用。PointWorld的实时推理速度(0.1秒)使其能够集成到MPC框架中。然而,PointWorld的训练需要真实世界的机器人交互数据,这限制了其规模化能力。PointZero的预训练阶段完全不需要机器人,这是两者最根本的差异。
路线三:自监督3D动态表示。 AFRO是一个自监督框架,从点云中学习动态感知的3D表示,无需动作或标签监督。AFRO将状态预测视为生成式扩散过程,在共享潜在空间中联合建模前向和逆向动力学。DynaRend则通过掩码重建和未来预测在triplane表示上联合学习3D几何、语义和动力学。这些方法都关注于从无动作标注的数据中学习动态表示,与PointZero的目标一致,但PointZero的独特之处在于将预训练任务明确设计为点轨迹补全,这一任务天然对应下游的点轨迹预测需求。
路线四:点跟踪的进步。 CoTracker3通过使用现成的点跟踪器作为教师,为无标注真实视频生成伪标签,使得真实视频可以用于训练。这一技术对PointZero具有重要意义:虽然PointZero在预训练阶段主要使用合成数据,但CoTracker3使得将真实视频纳入训练池成为可能,这正是工作在局限性中提到的未来方向。
七、从代码到实验:快速上手PointZero
工作已公开数据集、检查点权重和完整训练配方。项目主页https://pointzero-wm.github.io/提供了工作概览、方法架构图和数据集统计信息。
训练配置方面,工作使用8×H100 GPU训练约2天每个变体,采用ViT-Base骨干(768维、12头、12层)和3层Perceiver-IO编码器。预训练检查点使用4个查询token。后训练省略DINO视觉条件化以提高效率。测试时Flow Matching和JiT均使用4步前向欧拉更新。
数据预处理方面,每个点云使用初始帧质心和第99百分位半径进行归一化,评估时反转此变换以物理单位报告误差。训练时对点云和条件化点应用随机旋转和高斯噪声,对图像应用亮度、对比度、椒盐噪声和高斯噪声等视觉增强。
消融实验揭示了数据规模和模型容量的影响。表6 显示,将预训练数据降至10%时MDE从2.2 cm升至3.1 cm,降至5%时仅轻微下降至3.4 cm,表明即使使用部分数据也能提取有用的动态先验。表7 显示,将模型从Base配置缩小到Small(384维、6头、6层)会显著降低所有指标,表明进一步扩大Base模型可能带来额外收益。
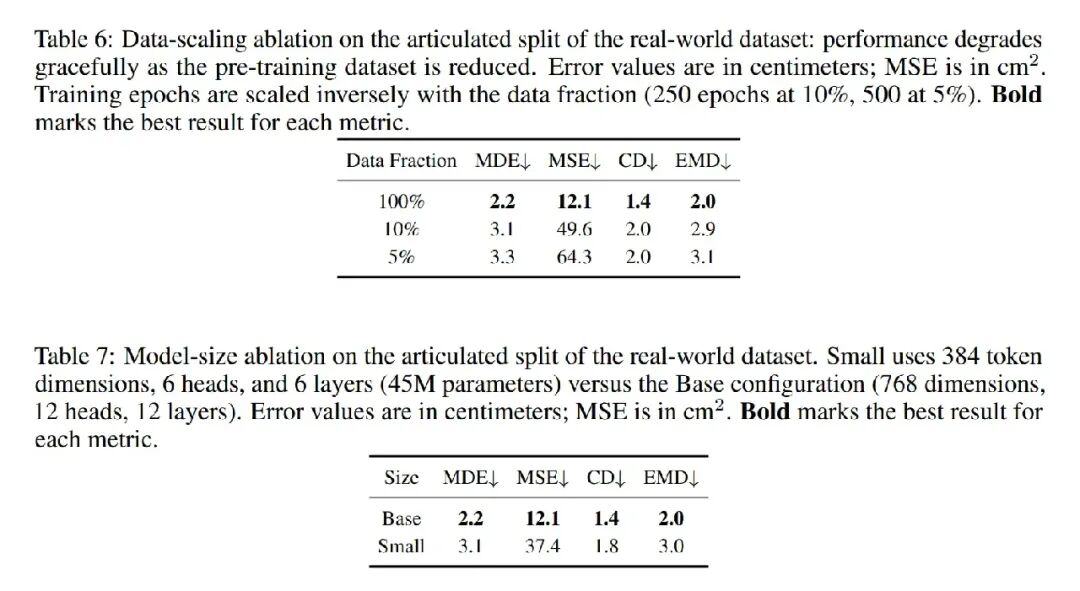
下游任务配置方面,模仿学习任务使用20条专家演示和100条无动作标签的额外视频。预训练增加平均成功率从80.5%到88.2%(带点轨迹监督),从74.1%到80.0%(不带点轨迹监督)。DP3和Diffusion Policy在相同协议下的平均成功率分别为45.0%和50.2%。
写在最后
PointZero的核心贡献不在于某个复杂的网络设计,而在于重新定义了3D动态预训练的游戏规则。通过将监督信号从“机器人动作”替换为“3D点轨迹”,工作打通了从仿真数据、互联网视频到下游机器人应用的完整通路。290万帧的合成数据集、三种训练范式的对比、在PGND基准和7个操作任务上的全面验证,构成了一套完整的“预训练-后训练”方法论。
工作的局限同样清晰。合成数据虽然覆盖了可变形、铰接和刚性物体,但尚未捕捉真实世界材料的全部多样性、接触丰富的手-物交互、杂乱场景和长时程动态。未来的方向是将仿真与来自真实视频的伪标注相结合——CoTracker3等技术已经证明这条路是可行的——并引入更丰富的交互表示,如接触位置和力。对于正在探索世界模型预训练的机器人学习研究者而言,PointZero提供了一个可验证的、开源的、可扩展的起点。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。