【内容目录】
一、推理为什么要拆成两半?
二、国产厂商,各站哪一边?
三、读题这一半,为什么国产先抢?
四、写答案这一半,国产走哪条路?
五、把两半接起来,中国团队的软件做到了哪一步?
六、上半年,这几家经营得怎么样?
七、 结语:拆开之后,难点挪到了哪?
参考资料

让大模型回答一个问题,芯片其实在干两件事。
(1)先是读题,把你输入的整段话一次读完,记下一份“笔记”。
(2)再是写答案,一点一点往外写,每写一步,都要回头翻一遍这份笔记。
这两件事吃的资源不一样。今年,英伟达和亚马逊云(AWS)先后给这两件事配了不同的芯片,读题交给GPU这类计算芯片,写答案则请来了几乎全靠芯片内部内存的专用芯片帮忙。
国产芯片厂商也开始拆了。华为,加上摩尔线程、沐曦这两家国产GPU上市公司,各押了哪一半?
先说结论:
·华为两边都押:同一颗昇腾950芯片做成两个版本。两版都配HBM,也就是贴在AI芯片旁边的高速显存,读题版配低成本的,写答案版配带宽更高的。
·摩尔线程先押读题:8月发布一份技术白皮书,方案里把自家的AI加速卡S5000用作专门读题的算力池,写答案交给另一款显存带宽更高的GPU。
·沐曦瞄准写答案:规划中的推理芯片Nx主打大容量、高带宽显存,要和自家GPU组成读题、写答案分开的系统;从公开描述看,Nx更偏写答案这一边。
一、推理为什么要拆成两半?
读题,业内叫预填充(Prefill);写答案,叫解码(Decode)。两件事难在不同的地方。
读题拼算力。整段话一次读完,成千上万个计算单元可以同时开工,像全班同学分着读完一本书。
写答案拼内存带宽。答案通常一个token一个token地往外写。每生成一个token,都要把模型参数和读题阶段的那份笔记再读一遍。在常见的场景下,要算的不多,大部分时间花在“翻笔记”上,内存往芯片里送数据的速度,往往决定了答案写得多快。这份笔记,也就是KV缓存。
华为在2025年的全联接大会上,把这个区别说得很直白,读题阶段“对计算并行的能力要求高,但对内存访问带宽的需求相对低”;写答案阶段“对互联带宽和访存带宽要求高”。
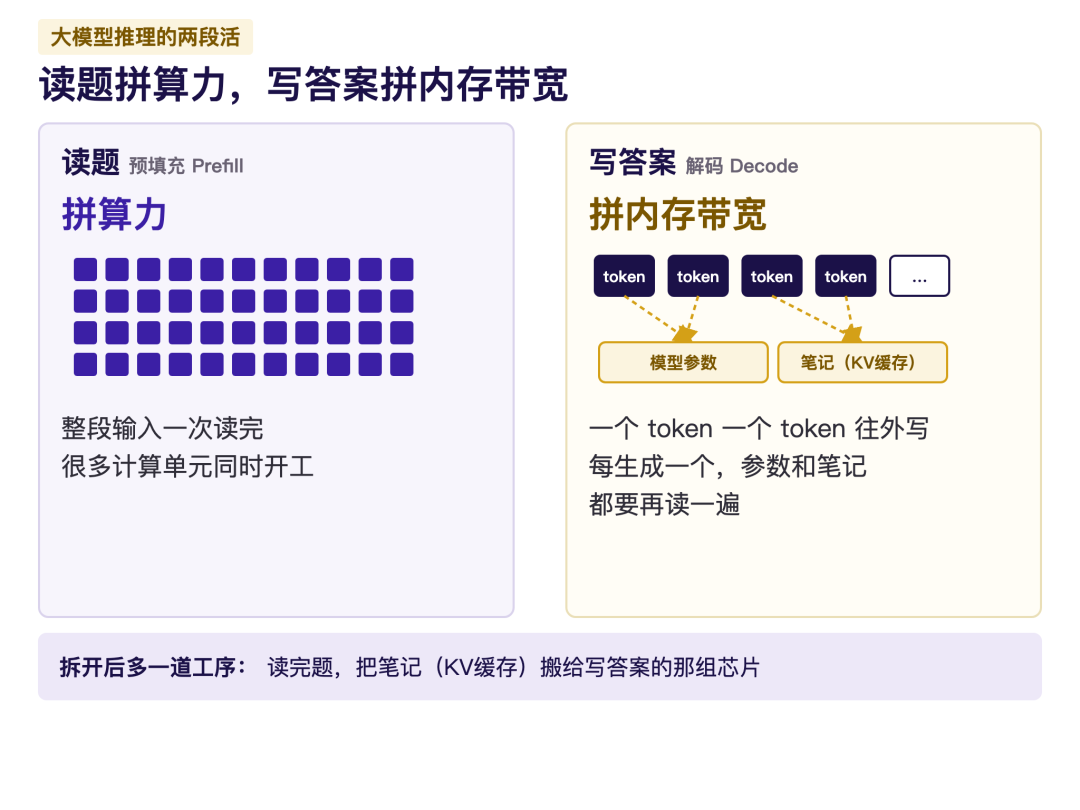
图1:读题拼算力,写答案拼内存带宽(示意)。指常见的生成场景;token是大模型处理文字的单位,可能是字、词或词的一部分。
两件事放在同一批芯片上,可能会互相拖累。
摩尔线程在前面提到的那份白皮书里,描述过一个常见“诡异”现象,虽然系统后台看数据一切正常,但用户在和AI对话时,经常觉得AI写着写着会突然“卡住”几秒。
这是怎么回事呢?因为芯片要同时接待很多不同用户的任务。假设芯片正顺畅地给你写答案,这时系统里突然进来其他用户的一篇超长文章,让芯片“读题”。这种繁重的读题任务会瞬间霸占芯片的全部算力,导致你这边的“写答案”任务被迫暂停、去一旁排队。在你看来,就是AI突然卡壳了。
题目还在变长。AI智能体写代码时,要反复读入代码、检索结果和对话记录。这份白皮书引用密歇根大学和斯坦福大学的实测,编程智能体累计读进去的内容,可达写出来的约154倍。这是多轮调用累计下来的比例,包含反复读入的上下文。
于是拆开,读题交给一组芯片,写答案交给另一组,互不干扰。代价是多了一道工序,读完题,要把笔记搬给写答案的那一组。
二、国产厂商,各站哪一边?
海外先动的两家,都给写答案配了专用芯片。
英伟达今年3月公布,自家新一代GPU Rubin负责读题;写答案时,回看前文的那部分计算(注意力)仍由Rubin算,另一部分计算交给LPU,这是英伟达从美国推理芯片公司Groq获得授权的芯片。
亚马逊云同在3月宣布,用自研的Trainium芯片读题,用美国公司Cerebras的晶圆级芯片写答案,也就是把一整片晶圆做成一颗大芯片。
这两种写答案的芯片有个共同点,芯片本身靠做在内部的高速内存SRAM,不用贴在旁边的HBM。
国产这边,本文讨论的几家公司站在哪一边,见图2。其中,华为和沐曦的写答案方案,走的都不是SRAM这条路。先看读题。
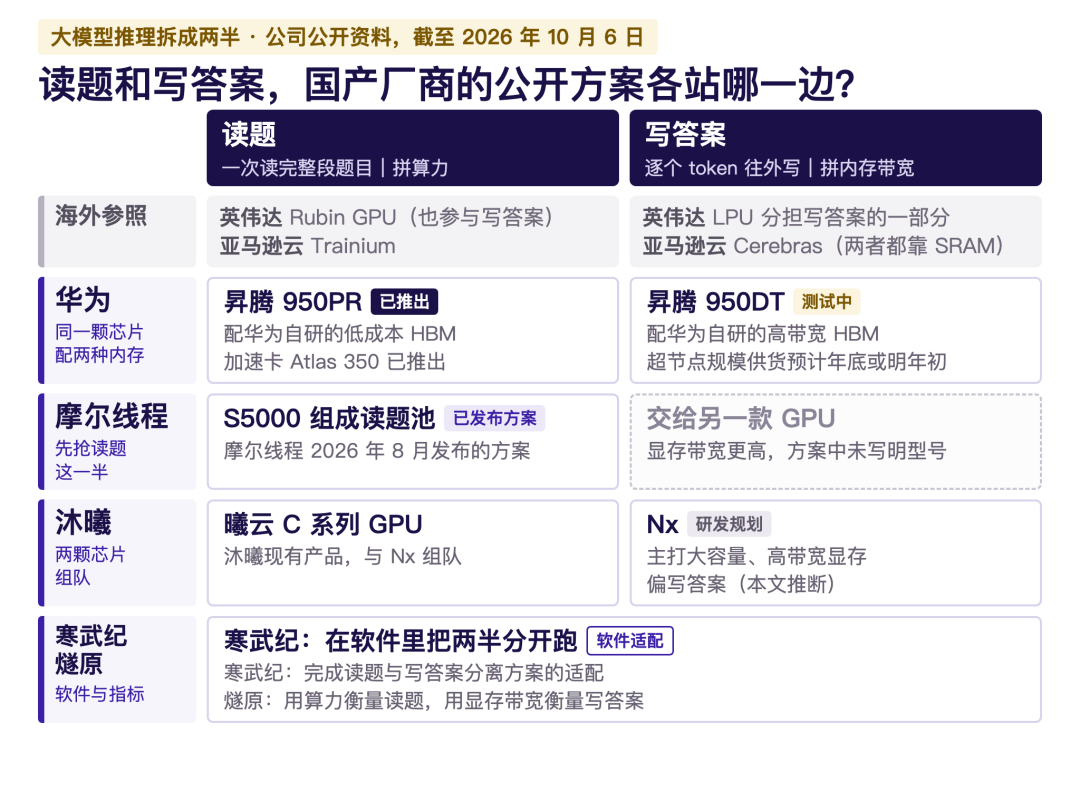
图2:读题和写答案,国产厂商的公开方案各站哪一边。资料截至2026年10月;HBM是贴在AI芯片旁边的高速显存,SRAM是做在芯片内部的高速内存;沐曦Nx偏写答案,是本文按公开描述的推断。
三、读题这一半,为什么国产先抢?
读题对内存带宽的要求相对低,这给了国产芯片一个切入口,这一半不用去拼最贵、最快的那一档内存。而HBM恰好是国内受限的一环,2024年12月,美国新增了针对HBM的对华出口管制。
华为:同一颗芯片,配两种内存。华为在2025年全联接大会上公布,“Ascend 950 PR和Ascend 950 DT共用了Ascend 950 Die”,也就是同一颗计算芯片,配两种华为自研的HBM:
·950PR:“主要面向推理Prefill阶段和推荐业务场景”,采用“华为自研的低成本HBM,HiBL 1.0”,已在2026年一季度推出,今年3月发布的加速卡Atlas 350用的就是它;
·950DT:“更注重推理Decode阶段和训练场景”,配HiZQ 2.0,容量144GB、带宽4TB/s,按2025年的路线图原计划2026年四季度推出。
好比同一台发动机,配两种供油,读题版用省钱的,写答案版用供得更快的。
两版的进展不一样。华为轮值董事长徐直军在今年全联接大会期间接受媒体采访时说:“950率先推出的是PR版,主要面向推理,目前上市量不算大。基于950DT的超节点则主要用于训练,目前还在测试中,规模供货应该在今年年底或明年初。”9月底,中国移动宣布,一套基于950DT的千卡超节点已在其北京昌平的数据中心落地。

图3:华为昇腾950,同一颗芯片配两种内存。950DT的超节点仍在测试,据徐直军,规模供货在今年年底或明年初;9月底中国移动北京节点已落地一套950DT千卡超节点。
摩尔线程:把读题做成单独的算力池。摩尔线程8月24日发布的那份技术白皮书,讲的就是这件事。
方案里,一批S5000组成读题池;写答案交给另一款显存带宽更高的GPU,白皮书没有写是哪一款。两边之间,用开源软件Mooncake搬笔记,这套软件出自Kimi背后的月之暗面和清华大学,第5节还会讲到。白皮书给了一个最小配置示例,12台S5000服务器,配1台写答案的服务器。实际比例要随模型和输入长度调整。
白皮书对读题池的要求写得很清楚,“高密度 FP8 算力”和“专攻高算力利用率与极低首字延迟”,算力配置从“通用冗余”转向“按需匹配”。翻译一下,算力要足,带宽够用就行,笔记读完就搬走,不用留太大地方。

图4:摩尔线程的读题算力池方案。12台配1台是白皮书给的最小配置示例,实际比例随模型和输入长度调整;写答案用的GPU,白皮书没有写明是哪一款。
摩尔线程在白皮书中,专门针对 S5000 芯片展示了一份“纯拼阅读极限”的成绩单。
为了排除写字慢的干扰,彻底摸清 S5000 的读题极限,官方设定了一个极端的实验室条件(采用智谱 GLM-5.2 模型):假定输入给 AI 的材料中,有 90% 都是以前读过的(可直接抄旧笔记),并且强令下游负责写答案的机器“只准写 1 个字就停笔交卷”。
在这种“90%开卷考+只写1个字”的场景下,S5000 交出的答卷非常亮眼:
·速度极快:面对 6 万字(64K)的长文,单台机器每秒能狂飙处理近 10 万字;哪怕是一口气喂给它 40 万字(400K)的超长文,单台每秒依然能处理 4.4 万字。
·发呆时间短:无论输入多长,系统从“接单”到“准备好吐出第一个字”的等待时间,中位数基本全控制在 6 秒以内。
(注:这是为了秀“读题速度”特调的数据,不代表日常写出完整回答的最终速度。)

图5:输入越长,读得越慢;九成输入直接复用了缓存。摩尔线程测试:单台8卡S5000,智谱GLM-5.2模型,前缀缓存命中率90%,只输出1个token;整组测试用2台S5000读题、4台写答案;五档的首个token等待时间中位数在4.9秒到5.7秒之间。厂商测试,不代表完整问答的速度。
不过,针对这场实测,有一个极易被误解的事情必须澄清:
在前面提到的 2:4(2台机器读题,4台机器写答案)测试阵容中,负责写答案的那 4 台机器,其实用的也是 S5000。
白皮书提出的理想方案,不是“S5000 读题 + 另一款神秘显卡写答案”吗?
确实如此。但在这份白皮书里,摩尔线程并没有放出那套“混搭方案”的实测数据(官方在9月业绩会上透露,混搭方案已在真实环境适配完毕,即将部署落地)。这场测试,纯粹是用全套 S5000 自己跑出来的。
这就顺带打破了一个行业里的常见偏见:
很多人以为“把读题交给国产卡,是因为国产卡内存不行,只能干读题的粗活”。
实则不然。S5000 完全能独立跑完读题和写答案的全流程。厂商之所以提倡把读、写拆给两款不同的芯片去干,根本原因不是国产卡“不能写”,而是为了省钱和效率,看两段活儿各自最吃什么资源,就把合适的芯片摆在合适的位置上。
四、写答案这一半,国产走哪条路?
写答案拼的是内存带宽,办法大致有三种(图6):
·把内存做进芯片里:英伟达和亚马逊云用的SRAM就是这种,最快,但很占芯片面积,一颗LPU只有500MB;
·把芯片旁边的HBM做快:HBM本身就是叠起来的内存,华为950DT走这条路,带宽4TB/s;
·把内存和计算叠在一起:沐曦规划的Nx走这条路,美国芯片公司d-Matrix也在为下一代芯片Raptor做类似的方案。
本文讨论的两家国产方案,落在后两种。
沐曦:把显存叠起来。沐曦2025年申请上市时,在回复上海证券交易所问询的文件里写道,Nx将“通过三维堆叠技术及混合键合先进封装工艺,实现大容量显存和超高显存带宽”,还可以和曦云C系列芯片互连,“组成Prefill-Decode分离的推理系统”。混合键合,是不用焊球,把两层芯片直接键合在一起。这是沐曦上市募资要投的项目,总投资约5.78亿元,研发内容包括和国内厂商合作做3D DRAM堆叠。
从描述看,Nx更偏写答案那一半;具体怎么分工,要看沐曦后续的产品披露。

图6:写答案拼内存带宽,三条路各有代价(示意)。三种是为讲清原理做的归纳,并不互斥,HBM本身也是叠起来的内存;第三栏的结构是概念示意,不代表Nx的实际结构。
五、把两半接起来,中国团队的软件做到了哪一步?
芯片之外还有一件事,读题和写答案拆开以后,谁来调度,笔记怎么搬。这一层,中国团队已经公开了不少落地的系统(图7)。
先看读题和写答案分开跑的系统:
·月之暗面和清华大学2024年公开了Kimi的推理平台Mooncake:读题、写答案分两组服务器,再把服务器里闲置的内存和硬盘拼成一个大“笔记仓库”。这篇论文拿下了存储领域顶级会议FAST 2025的最佳论文奖;论文数据是在英伟达A800、H800集群上跑出来的,让Kimi多处理了一倍多的请求。
·DeepSeek2025年3月公开推理系统,读题和写答案分开部署,读题一组用4台服务器,写答案一组用18台。
·华为云2025年8月公开了在CloudMatrix384上的推理系统。CloudMatrix384是把384颗昇腾芯片连成一台大机器的超节点;这套系统支持读题和写答案分开部署。
再往细里拆,是把模型每一层里的活也分开。每一层有两部分:注意力负责回看前文,前馈负责把每个token的信息再加工一遍。
字节跳动2025年4月公开的MegaScale-Infer,把这两部分拆到不同的GPU上,两边像打乒乓球一样来回传数据;阶跃星辰7月发布的Step-3也这样拆,取名AFD;华为云的那套系统同样支持。英伟达今年3月公布的方案,让GPU算注意力、LPU算前馈,用的也是这种切法。
这些软件,开始和国产芯片接上了。摩尔线程的读题方案,搬笔记用的正是Mooncake。
寒武纪在2026年半年报里写道,已“完成预填充与解码分离等推理方案的适配和验证”。
燧原在今年9月上市前发布的招股说明书里,直接用这两把尺子给芯片定指标:算力是“计算密集型场景(如大模型运行的预填充阶段)中的核心性能指标”;显存容量和显存带宽是“内存密集型场景(如大模型运行的解码阶段)中的核心性能指标”。

图7:推理拆分,本文涉及的部分公开进展。按公开时间排列;论文、系统、方案、产品、计划是不同类型的进展,不能直接比先后;空格只表示本文没有选入;灰字为海外厂商。
六、上半年,这几家经营得怎么样?
本文所列四家公司,上半年营收都在涨;扣除非经常性损益(投资收益、政府补助这类和日常经营无关的收支)后的净利润,也就是扣非净利润,只有寒武纪是正的(图8)。寒武纪、摩尔线程、沐曦的毛利率分别为55.3%、56.9%、57.2%;燧原的审阅数据没有列毛利率。
沐曦归母净利润6.12亿元,扣非后亏损0.49亿元,两者相差约6.61亿元,主要是金融资产公允价值变动等非经常性损益。燧原的数据为会计师审阅、未经审计。
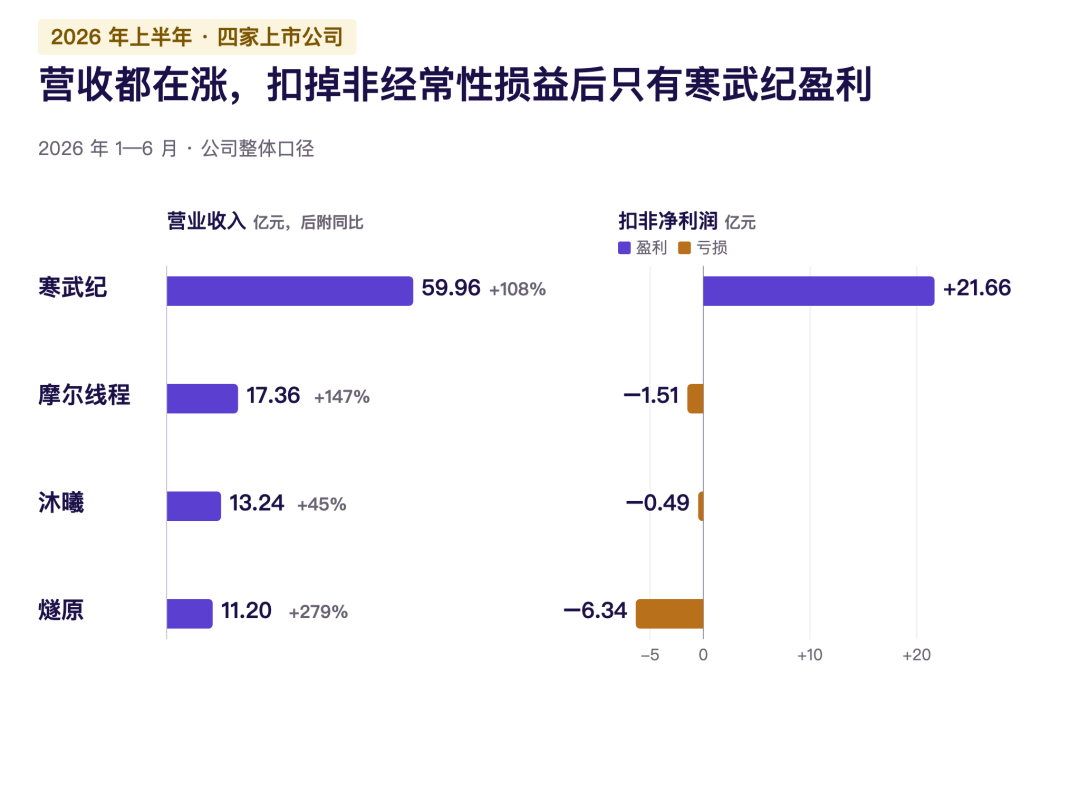
图8:四家公司上半年营收都在增长;扣除投资收益、政府补助这类非经常性损益后,只有寒武纪盈利。公司整体口径,不是推理产品的收入;燧原为会计师审阅、未经审计的数据。
七、结语:拆开之后,难点挪到了哪?
回到标题的问题:华为两边都押,摩尔线程先押读题,沐曦瞄准写答案。
本文讨论的方案里,读题这一半已经有产品和厂商实测;专为写答案设计的,华为950DT的超节点还在测试,规模供货要到今年年底或明年初,沐曦Nx还在研发规划里。拆开以后,难点也挪了位置:两组芯片之间要搬笔记,摩尔线程的白皮书写明,两边笔记的数据格式、分块大小、存放方式完全一致,才能原样直传。
接下来要看的,是专为写答案优化的产品和这类分开部署的方案,能不能在真实业务里同时把生成速度、等待时间和每个token的成本都做下来。产品推出、方案适配、规模部署,要分开看。最后引用徐直军的判断:往后关键可能不在推动的力度,而在“供货能力有多大”。
资料与口径:资料截至2026年10月。华为、英伟达、亚马逊云、Cerebras、d-Matrix的产品信息来自厂商公开资料,均为厂商口径;国产上市公司信息摘自公司半年报、招股说明书、上市审核问询回复与投资者关系活动记录表。状态分四档:已推出(昇腾950PR,Atlas 350加速卡)、已发布方案(摩尔线程白皮书)、测试中(昇腾950DT超节点)、研发规划(沐曦Nx)。沐曦两款芯片在读题、写答案之间如何分工,是本文按问询回复的描述推断。S5000实测为厂商测试,前缀缓存命中率90%。财务数据为公司整体口径,不是推理产品的收入;燧原为经审阅、未经审计的数据。图1、图6为示意。本文未覆盖海光信息、昆仑芯、壁仞科技、天数智芯、平头哥等厂商。
参考资料:(上下滑动可查看):