项目主页:loveju1y.github.io/DIDO/
代码仓库:github.com/LoveJu1y/DIDO-WAM/
arXiv:2609.15570
World Action Models ( WAMs )通过视频⽣成模型预测机器⼈动作后的未来场景,从⽽帮助机器⼈决策。
这是 视频模型的独特优势 —— 它可以显式描述 “ 动作之后,世界会发⽣什么 ” 。但代价也很明显:每次预测都需要完 整的视频⽣成,⽽扩散模型通常需要⼏⼗步 denoising 。
以 Wan2.2 为例,⼀次⽣成需要 50 步去噪,这样的推理开销让 WAM 难以真正部署到实时机器⼈系统中。 为了压缩推理成本,已有⼯作尝试了不同⽅向: DreamZero 做系统优化,⼀些⼯作压缩到 few steps ,Flash WAM 则直接压到 single-step 。
但问题来了: Flash-WAM 虽然快了,性能却明显下降; Dyna-2 也探索了单步 蒸馏,但⽬前还没有开源。当把⼏⼗步压缩到⼀步时,究竟丢掉了什么?能不能让模型只⽤⼀步,却保留多步的性能?
这正是 DIDO 要解决的问题。
01 多出来的denoising steps,到底在做什么?
DIDO ⾸先弄清楚⼀件事:多出来的 denoising steps ,到底增加了什么?
如果后⾯的步骤只是让背景从模糊变得更加清晰,那么把它们压缩掉似乎并不会影响机器⼈的决策;
但如果后续 denoising 还在逐渐形成⼀些机器 ⼈真正需要的信息,那么简单截断就注定会带来性能损失。
因此,作者没有直接去设计⼀个新的 single-step 模型,⽽是⾸先把⼀个四步视频模型的完整 denoising trajectory 拆开来看,观察每⼀步究竟在形成什么。

结果发现,不同类型的信息并不是同时出现的。
在较早的 denoising steps 中,背景、桌⾯以及静态场景结构 已经基本形成;但随着 denoising 继续进⾏,机械臂、⽬标物体才变得更清晰,从 latent 层⾯看它也还在不断补充交互动态。
这也解释了为什么简单的 one-step truncation 会损失性能:第⼀步看到的是⼀个已经具备场景结构、却还没有完整交互动态的未来。
对普通视频⽣成来说,这可能只是视觉质量的差异;但对机器⼈来说,真正重要的恰恰是夹⽖接下来怎么运动、什么时候接触物体,以及接触之后物体⼜会怎么运动。
于是,问题也变得更加明确了:如果后续 denoising 中真正有价值的是这些交互动态,那么能不能不再等待它们逐步出现,⽽是直接把它们带到第⼀步?
02 不只是“少做⼏步”,⽽是把多步未来教给⼀步
这也是 DIDO 与简单 one-step truncation 最本质的区别。
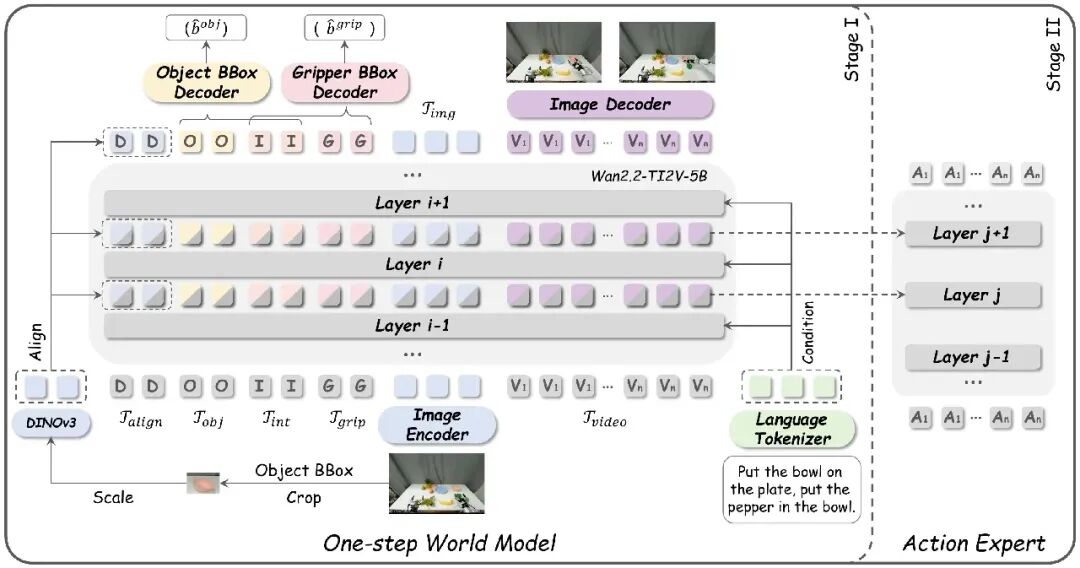
作者并没有把原来的多步模型粗暴地截断,⽽是先有⼀个完整的 multi-step video model ,将它作为 teacher , 随后训练⼀个 single-step student ,让它学习如何从同样的当前观测和动作条件出发,通过⼀次 forward pass ,直接恢复 teacher 原本需要多步 denoising 才能形成的未来动态。
那么具体怎么做?
DIDO 的核⼼是 Distribution Matching Distillation (DMD) 。不是直接对⻬最终输出,⽽是 让 student 和 teacher 在扰动分布层⾯保持⼀致。 具体⽽⾔, DMD 通过最⼩化 KL 散度来对⻬两者的分布:

其中, 是 student 在扩散时间步 处的分布, 是 teacher 在同⼀时间步的分布。
这个损失函数的梯度 通过 teacher 和 fake score network 之间的差异来估计,从⽽引导 student 逐步逼近 teacher 的分布特性。
换句话说, teacher ⽤四步慢慢 “画出” 的未来, student 需要在⼀步之内重现出这个分布 —— 不是简单地复制最终帧,⽽是学会如何在单次前向传播中,⽣成与 teacher 多步⽣成在统计意义上等价的未来动态。
这样⼀来, student 不再只是看到 “未来是什么样⼦” ,⽽是真正学会了 “未来是怎样⼀步步形成的” 。
03 看到完整未来之后,机器⼈真正需要看什么?
未来视频⾥当然包含整个场景:桌⾯、背景、其他物体、机械臂、⽬标物体,对于动作决策⽽⾔,这些信息的 重要程度显然并不相同。
机器⼈真正关⼼的,是那些正在参与交互的对象。
因此, DIDO 进⼀步在视频模型内部引⼊了 interaction-centric representations ,包括 gripper 、 object 、 interaction 和 align tokens ,让模型在预测未来的同时,显式关注与动作直接相关的实体和关系。
其中, interaction token 并不是简单地单独描述机械臂或者⽬标物体,⽽是同时参与 gripper 和 object 的轨迹 预测,显式建模⼆者之间的交互关系; align token 则利⽤ DINOv3 的多层视觉特征,为⽬标物体提供更加稳定的视觉语义信息。
于是, DIDO所预测的未来不再只是⼀个 “ 未来画⾯ ”,⽽开始包含更加明确的结构:谁在运动?谁是被操作对象?两者什么时候发⽣接触?接触之后⼜如何共同变化?
为了让这些交互动态区域更进⼀步服务于动作⽣成, DIDO 利⽤当前状态与未来状态之间的 latent difference , 为不同空间区域计算 dynamic score :

这个分数越⾼,意味着该区域在未来发⽣的变化越明显。 DIDO 不再让所有区域使⽤完全相同的 token resolution ,⽽是根据动态程度分配计算:⾼动态区域保留 full-resolution tokens ,低动态区域则进⾏ average pooling 。
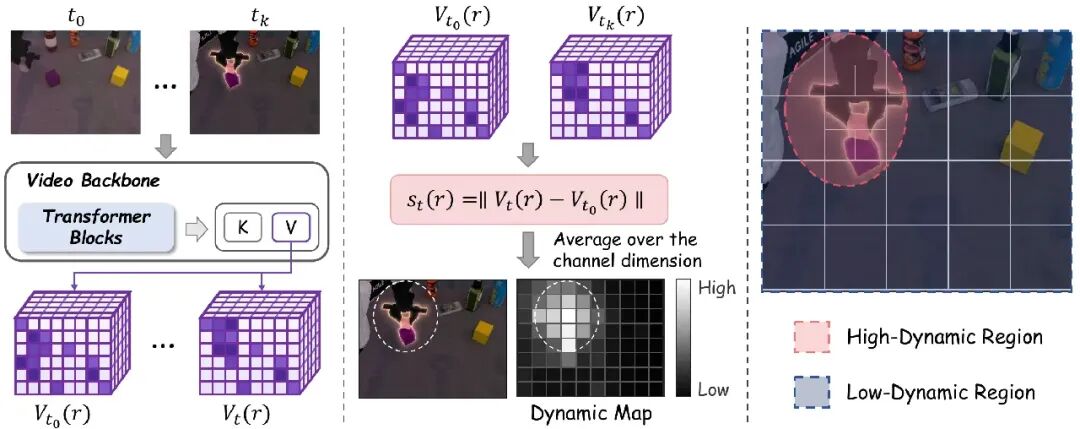
这样⼀来, DIDO 实际上完成了三次 “ 压缩 ” :⾸先把多步 denoising 压缩成⼀次预测,但尽可能保留多步形成的 未来动态;然后把注意⼒从完整场景进⼀步集中到真正参与交互的对象;最后再根据未来的动态程度,把计算 预算集中到真正发⽣变化的区域。
从 “ 怎么更快地⽣成未来 ” ,到 “ 未来中什么最值得保留 ” , DIDO 希望压缩的已经不只是 denoising steps ,⽽是 整个未来预测过程中真正有价值的信息。
04 DIDO的有效性验证
如果 DIDO 的每⼀步设计都对应着前⾯发现的⼀个问题,那么它们应该能够在实验中逐步体现出来。消融结果也呈现出了⾮常清晰的变化:
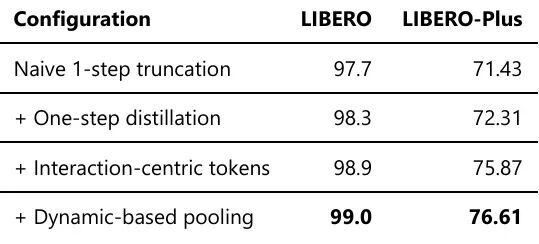
从 97.7% → 98.3% → 98.9% → 99.0% ,性能并不是随着模块简单堆叠⽽提升,⽽是恰好对应了前⾯提出的三个问题: one-step distillation 把多步未来带回⼀步, interaction-centric tokens 让模型知道未来中谁最重 要,⽽ dynamic-based pooling 则进⼀步把计算集中到真正发⽣变化的区域。
这也说明,单步预测真正需要解决的并不是 “ 如何把后⾯的步骤删掉 ” ,⽽是如何把后⾯步骤中真正有⽤的信息留下来。
在常⻅ benchmark LIBERO 和 RoboTwin 上, DIDO 也分别达到了 99.0% 和 92.0% :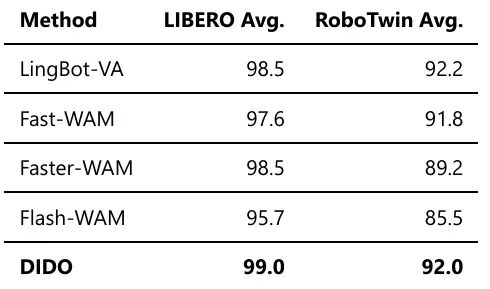
为了测试 DIDO 的泛化性,作者进⼀步在 LIBERO-Plus 上加⼊相机、光照、背景、物体布局、机器⼈初始化和语 ⾔等系统扰动。
DIDO 最终达到 76.61% ,相⽐ Fast-WAM 的 51.5% 提升 25.1 个百分点。尤其是在 object layout 扰动下,DIDO 达到83.34%,⽽Fast-WAM 为37.7%。
这个结果恰恰验证了前⾯的设计初衷:当物体不再出现在模型熟悉的位置时,模型仍然需要重新定位真正参与交互的 gripper 和 object ,⽽不是依赖固定的场景记忆。
05 从 benchmark ⾛向真实世界
进⼀步地, DIDO 部署到真实的 Galbot G1 上,测试 position generalization 和 environment generalization 。

在 Basic setting 中,作者主要改变⽬标位置; Advanced setting 则进⼀步加⼊环境视觉⼲扰。 Basic setting 下, DIDO 的平均 task-progress score 达到 80.8% ,⾼于 π₀.₅ 的 74.5% 和 Fast-WAM 的 53.8% ;在 Advanced setting 下,即使加⼊更加复杂的环境视觉⼲扰, DIDO 仍达到 66.0% ,⽽ Fast-WAM 为 33.0% 。
这意味着, DIDO 并没有因为把多步预测压缩成⼀步,就失去对关键交互动态的建模能⼒。 那么,这些设计最终换来了什么?在 NVIDIA H100 、 batch size = 1 的设置下,四步 teacher 的推理延迟为 562 ms ,⽽DIDO 只需要 384 ms ,整体降低约 32% 。相⽐ Fast-WAM 的 356 ms , DIDO 只增加 28 ms 的延迟, 却在 LIBERO-Plus 上获得了 25.1 个百分点的提升。
回到最开始的问题:如果多步 denoising 中确实包含机器⼈需要的交互动态,那么为什么 DIDO 可以只⽤⼀ 步?
答案并不是因为后⾯的步骤 “ 不重要 ” ,恰恰相反,正是因为后⾯的步骤重要,所以我们才需要把它们真正贡献 的信息蒸馏出来。
DIDO 真正做的是:把多步 denoising 中逐渐形成的交互动态压缩进⼀次预测,再把计算进⼀步集中到真正发 ⽣变化的区域。
对于 WAM ⽽⾔,真正值得追求的也许并不是 “ ⽣成更少的未来 ” ,⽽是:在有限的推理预算下,如何保留未来中真正值得机器⼈⽤来⾏动的变化?
⽽ DIDO 给出的答案是:让机器⼈不⽤等待未来逐步⽣成,⽽是在⼀次预测中,直接看到真正有⽤的未来。
-END-
点击下方卡片,关注【Xbotics具身智能实验室】
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀



