作者 / Harry
编辑 / 九九
先看一段视频。
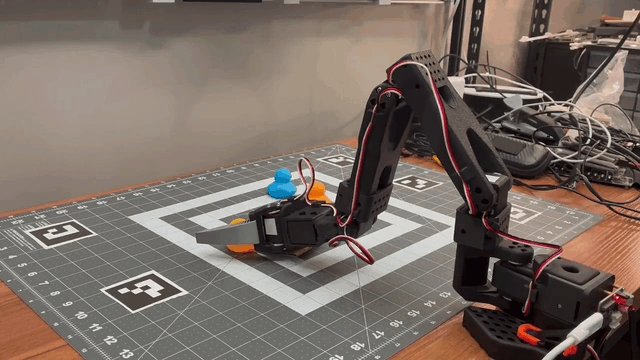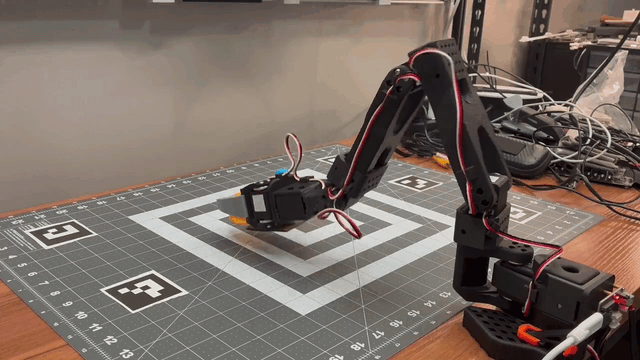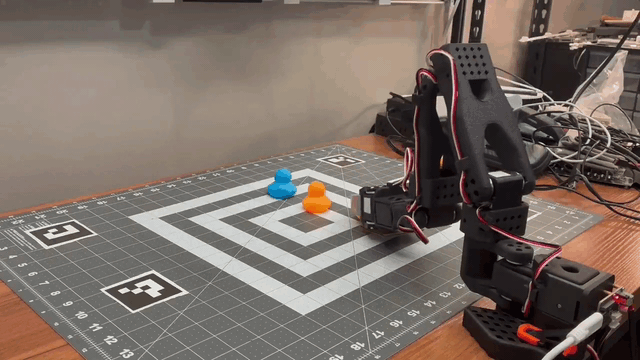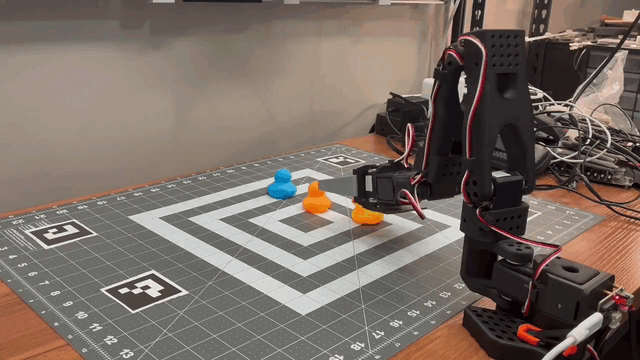
这台 3D 打印的桌面机械臂,把一只小黄鸭夹起来、抬起、放到目标位置,一次搬运做得干净利落。做这个演示的开发者说,这台机械臂没录过一条示教数据,也没训练过任何动作策略,每一步怎么走,都是一个叫 Jev 的模型当场决定的。
这个操作有点特别。当下让机械臂学一个新动作,主流做法是先靠遥操作带着它做几十上百遍,录成示教数据,再训一个 VLA(视觉-语言-动作模型),这个模型看着画面,直接算出每个关节怎么转。在 SO-101 上,LeRobot 官方教程建议一个新任务先录约 50 段完整演示;π0 这样的通用模型,预训练用了一万多小时的机器人数据。
Jev 的思路完全不同。这个模型不写字,只做选择题:给它一段描述和几个选项,几百毫秒后,它会告诉你每个选项有几成把握。接到机械臂上,动作不用学,提前写成"下降""闭爪""抬起"这样的技能,机器人每走一步就问 Jev 一次:下一步用哪个?
Jev 出自美国初创公司 TypeSafe AI,9 月中旬刚刚发布。这家公司 2024 年成立,闭门做了两年,这次亮相同时宣布了 4000 万美元种子轮融资;创始人 Diogo Almeida 在 OpenAI 参与过 InstructGPT,也就是让大模型学会听指令的那项研究,后来成了 ChatGPT 的基础。
这会不会是 VLA 之外的另一条路?我把能找到的十几个开源项目都翻了一遍。
01 两条路:VLA 教机器人怎么动,Jev 让它做选择

Jev与VLA最大的区别在于“本事”从哪来。VLA 靠动作数据,示教看得够多,就知道这种画面下该怎么动,动作能做得很细、很连贯;代价是每换一个任务,都得重新录数据、重新训。
Jev 靠的是大模型本身的常识。它不用懂关节怎么转,只要读懂"夹爪已经在物块正上方,还没夹住",判断下一步该"下降"还是"闭爪"。换任务,改的是技能列表和题目,不用再采数据。

机器人每推进一步,都会完成一轮循环:相机获取画面,程序把当前状态转成文字,Jev 从候选技能中选出下一步,机器人执行相应的技能,再更新画面。底层的技能和电机控制,传统机器人早就做得很成熟了;Jev 只负责中间这道选择题,每秒决策 1 到 5 次。
说实话,这个思路不新。早年的机器人任务规划,也是在技能之间做选择,只不过靠的是人写死的规则,碰上规则没写到的情况,机器人就卡住了。Jev 就是从这里切入的:把"下一步调用哪个技能"交给模型,由 Jev 结合当前状态来判断。
02 如何才能用上Jev?
Jev 并没有装在机器人上,实际上是在 TypeSafe AI 的服务器上跑的。用起来跟问 ChatGPT 差不多,只不过向 Jev 提问的,是机器人旁边那台电脑上的一段程序。每一轮,这段程序先把机器人看到的情况写成一段文字,连同题目和选项一起发给 Jev;Jev 零点几秒后给每个选项回一个概率;程序再让机器人执行概率最高的那一项。

每次问 Jev,都要给三样东西:状态,也就是眼下的情况,比如"苹果已在盘里,夹爪张开,高 152.8 毫米";题目,比如"现在该做哪件事";选项,也就是几个写好的候选答案,每个后面写明什么情况下适用。
这道题普通大模型也能做,问题是太慢、太贵。机器人每一步都要等大模型几秒,动作就一顿一顿的;每一步都按大模型的价钱付,跑一天账单也难看。

慢,是因为大模型要一个 token 一个 token 地往外写,每写一个就把整个模型算一遍,哪怕答案只有"拦截"两个字。Jev 把这一步砍掉了:材料读一遍,每个选项直接出一个概率。
所以 Jev 一次请求只要 70 到 500 毫秒,输入每百万 token 0.042 美元,输出不收钱。放到机械臂上很直观:同一个让 xArm7 把苹果放进盘子的仿真任务,Jev 花了 0.0188 美元,GPT-6 Astra 花了 5.93 美元,差了三百多倍。
官方评测里,Jev 的准确率和 OpenAI 的中档模型接近,调用成本不到对方的百分之二;第三方的独立测试比的也是准确率,结论相近:Jev 大致和中档大模型持平,与最强那一档仍有差距。
Jev 还会给每个答案报把握度。这对机器人很有用:把握够就执行,不够就停下再看一眼,或者交给人工处理。
代价也有,官方文档自己列了:不会算数,分不清两个日期谁先谁后,看不懂图,只读文字。所以到了机器人上,距离、角度得先由代码算好,画面得先由别的模型翻成文字。
这样一来,分工就清楚了:代码负责算数和看图,Jev 负责在备好的选项里挑一个,又快又便宜,还报得出几成把握。这套分工放到真实任务里,能不能跑通?
03 三个实验:每一轮都问了 Jev 什么
下面三个实验,两个在仿真里,一个在真机上。每一轮都照上面的方式问 Jev,区别只在问什么。配图和上一节一个格式:左边是发给 Jev 的,右边是它回的。
现在可以来看看Jev的表现。
实验一 xArm7 放苹果:一步一步看 Jev 在干什么
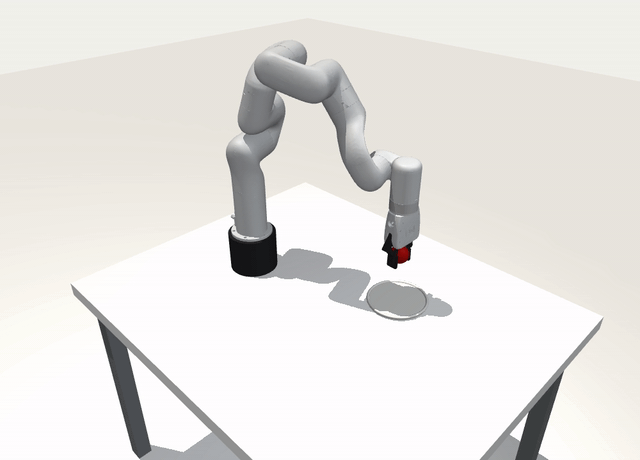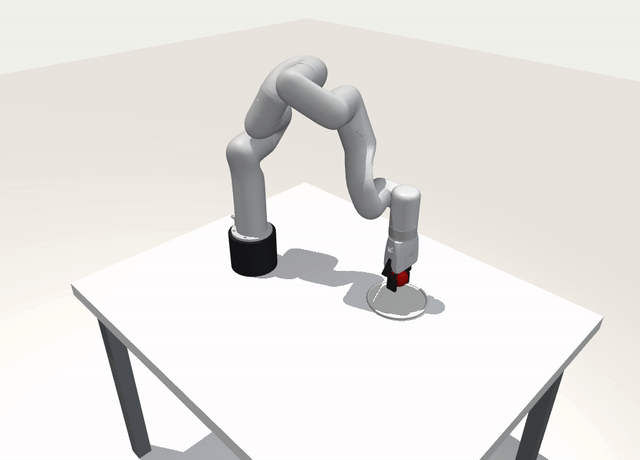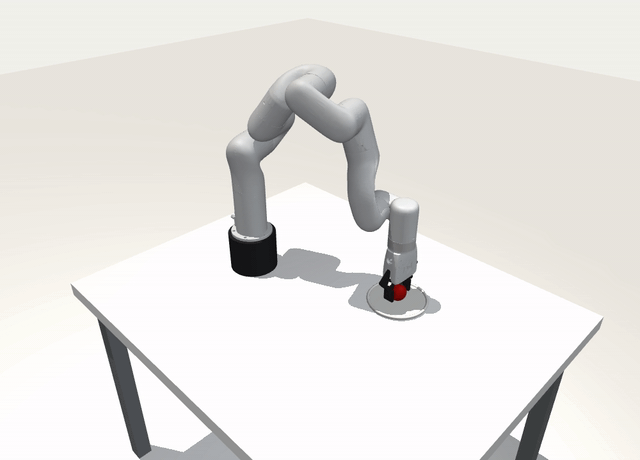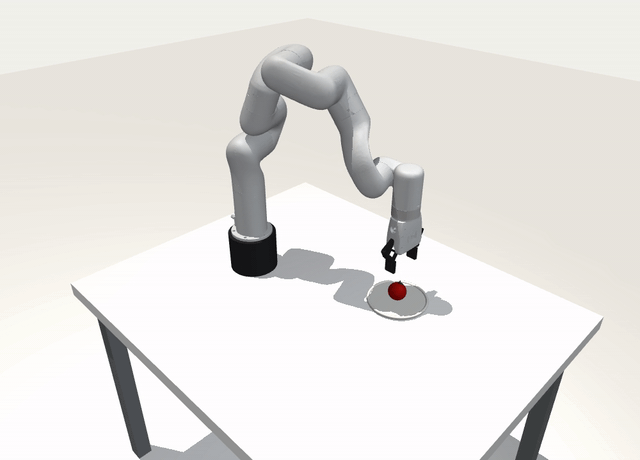
任务很简单:仿真里一台 xArm7、一个苹果、一个盘子,把苹果放进盘子。整个过程拆成很多轮,机械臂每轮只挪一小步,挪之前先问 Jev 两道题。

第一道题是"现在该做哪件事",8 个选项,从接近、抓取一直到结束,每个都写了什么时候该选。比如"放低":已在盘子正上方,还没到松手高度;"撤回":苹果已留在盘子里,夹爪还低于 160 毫米。第二道题是"往哪边挪",x、y、z 三个方向各选负向、不动或正向。
Jev 要做的,就是读仿真器报上来的数,看眼下满足哪一条。上图是最后一轮:苹果已在盘里,夹爪高 152.8 毫米,不到 160,正好是"撤回"的条件,Jev 也选了"撤回",把握 89%;第二道题 Jev 让 z 方向往上,把握 93%。
这样跑了 113 轮,苹果放进了盘子,花了 0.0188 美元;GPT-6 Astra 跑同样的流程,用了 106 轮、5.93 美元。不过每个模型只跑了一次,每一步的条件又写得很细,这组对比能说明 Jev 便宜,说明不了 Jev 更会控制机械臂。
实验二 Franka 放汤罐:先预演,再让 Jev 挑
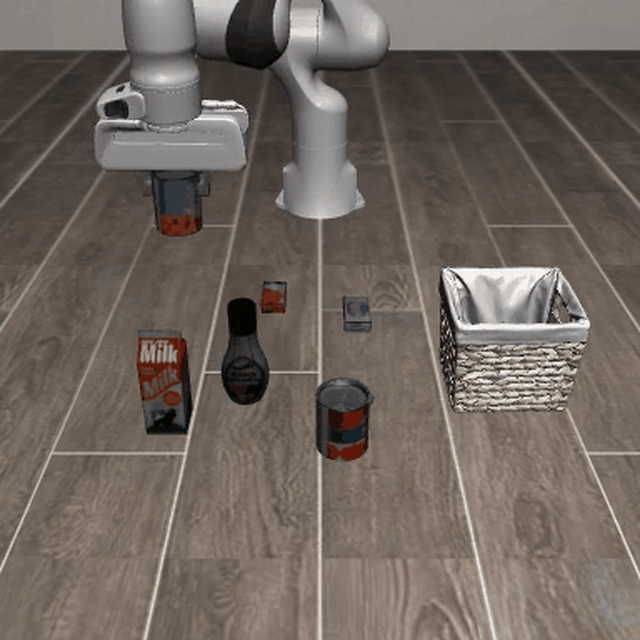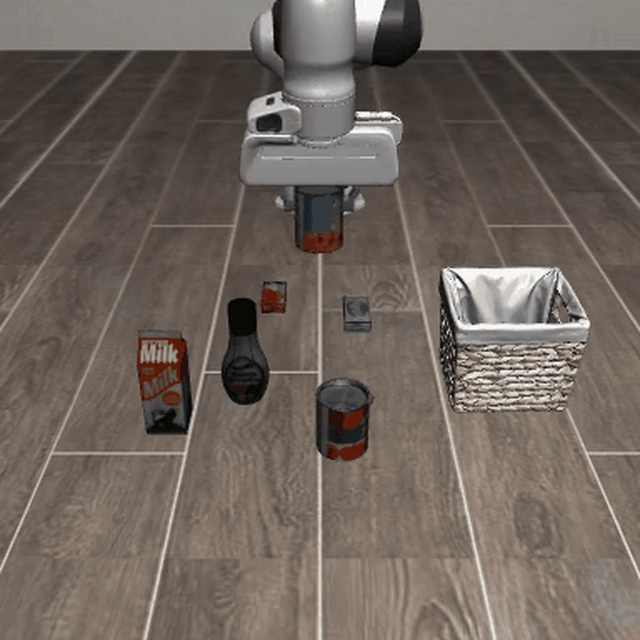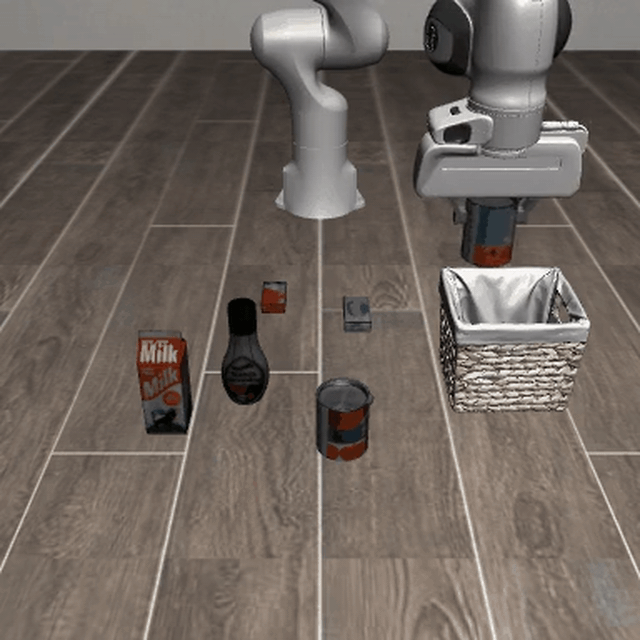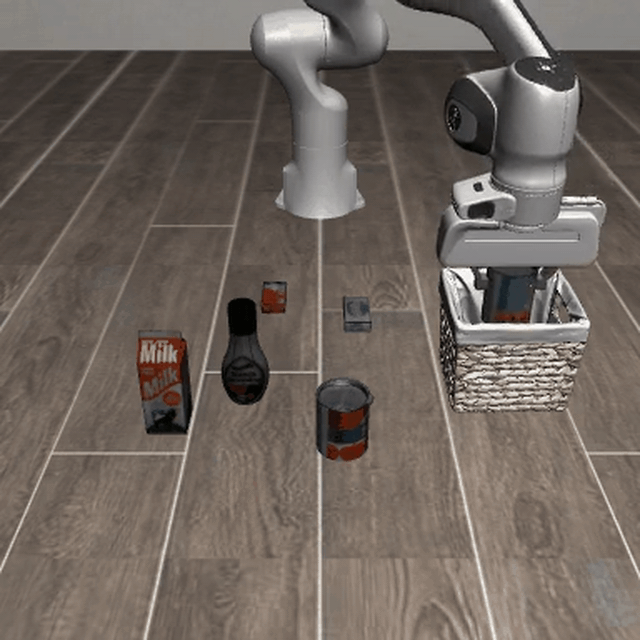
第二个实验在 LIBERO 仿真环境里,让 Franka 机械臂把一罐汤放进篮子。这回连"每一步挪多少"也做成了选择题,而且问之前,代码先把每个选项的后果算好了。
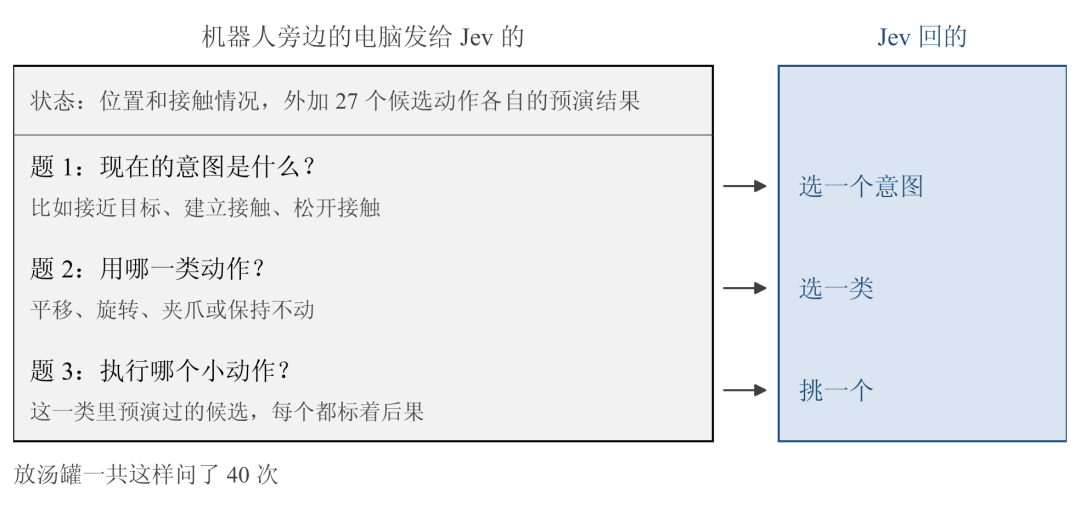
每一步,代码列出 27 个小动作,在物理引擎里挨个预演,看做完会不会碰到东西、离目标是近了还是远了。Jev 拿到的是一张标好后果的菜单,分三次答:先选意图,再选哪一类动作,最后挑一个。放汤罐一共问了 40 次,最后汤罐进了篮子。这个项目公开的结果,就是几个任务各自的运行记录,没有统计成功率;跑得最多的是关微波炉门,3 次里成功 2 次。
Jev 不会算数,那就别让 Jev 算。距离、碰撞这些数,代码在提问之前就都算完了,Jev 只管在后果已知的几个选项里挑。
实验三 SO-101 真机:还在路上

真机上公开的记录少得多。上面这段视频里,SO-101 接了两个 USB 相机,Jev 每秒做大约 2 次决策,把球放进盒子,中间抓滑了一次,又回去重新抓起来。视频标着"有人监督的原型""剪辑过的真实画面",部分片段加速,也没公开代码。公开了代码、在真机上跑过 Jev 的是另一个 SO-101 项目,下图是这个项目每一轮问的四道题。

做法和仿真差不多,只是信息从仿真器换成了相机。腕部装一个相机,用最简单的颜色识别找物块,把"看没看见、对没对中",以及夹爪到没到抓取高度、夹没夹住,一起交给 Jev。技能从找物块开始,一路走到闭爪、抬起,每一轮由 Jev 判断该走到哪一步;风险分超过预设的阈值 1.5,代码就直接让机械臂后退。
这个项目一开始不是这么做的。最早,开发者让 Jev 在"每个关节转不超过 2 度"的小步里挑,结果一步 1.8 度地挑,怎么也找不到、抓不起物块,后来才改成按技能选。
三个实验还有两个共同点。一是数字都来自一次或极少几次运行,没有一个项目给出成功率,也没有一个在同样条件下跟写得好的规则比过。二是最后的否决权都在代码手里,急停和关节限位不交给 Jev,风险阈值也不交。
三个实验合起来说明,Jev 已经能接进机器人的任务流程,但还证明不了它比写好的规则或 VLA 更可靠。
04 Jev 能成为 VLA 之外的另一条路吗?
Jev 的好处很明显。不用录示教数据,换任务只改题目和选项;每一步都是一道带概率的选择题,出了错能查到是哪一步选错;没把握的时候还能自己停下来。这三点,今天的 VLA 都做不好。
短板也明显。技能要有人先写好,画面要先翻成文字,毫米级、连续不断的精细动作 Jev 做不了。速度上,Figure 的 Helix 动作层每秒出 200 次动作,π0 最高每秒 50 次,Jev 在这些实验里每秒只被问 1 到 5 次。Jev 的快是跟大模型比出来的,跟 Helix 的动作层比,还慢了 40 到 200 倍。
所以我更倾向于两条路会接起来:VLA 把一个个技能做稳、做细,Jev 这类模型在技能之间做选择、在关键节点把关,比如抓完之后判断抓没抓住、滑了要不要重试、东西被人挪走了要不要叫人。GitHub 上已经有人立项做"用 Jev 监督 VLA",不过还停在设计阶段。
最缺的一块是看图。Jev 现在只读文字,机器人要用它,就得先有个模型把画面翻成文字,翻错了,判断就跟着错。
已经有研究在补这一块。南京大学和微软亚洲研究院的论文 PixelJev,把 Jev 这种"读一遍、给每个选项打分"的做法用到了图片上:跳过把画面翻成文字这一步,直接把图片和选项一起交给 Qwen3.5 的 2B、4B 多模态版本,读出每个选项的概率。在宠物品种、卫星图分类这类任务上,每类只用 64 张图微调,准确率就从五六成涨到九成左右。不过这篇还没做机器人实验,代码也没放出来。
结语
回到开头的小黄鸭。那段视频没公开代码,我们看不出 Jev 在里面到底答了哪些题,但这段视频抛出的问题是真的:机器人对"下一步做什么"的判断,也一定要从动作数据里学出来吗?
至少在这一层,Jev 给了一个快、便宜、不用示教数据的答案。Jev 能走多远,得看第一份同条件对比:同样的感知、同样的技能库,交给 Jev 挑和交给一段认真写的规则挑,成功率差多少。十几个项目里,还没有一个回答过这个问题。
-END-
点击下方卡片,关注【Xbotics具身智能实验室】公众号
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀



