【内容目录】
1. AI训练为什么会让电网“晃”?
2. 减震链怎么搭?
3. 国内这道题,为什么更难?
4. 国产芯片公司,站在哪一层?
5. 结语:谁在晃,谁在稳?
参考资料
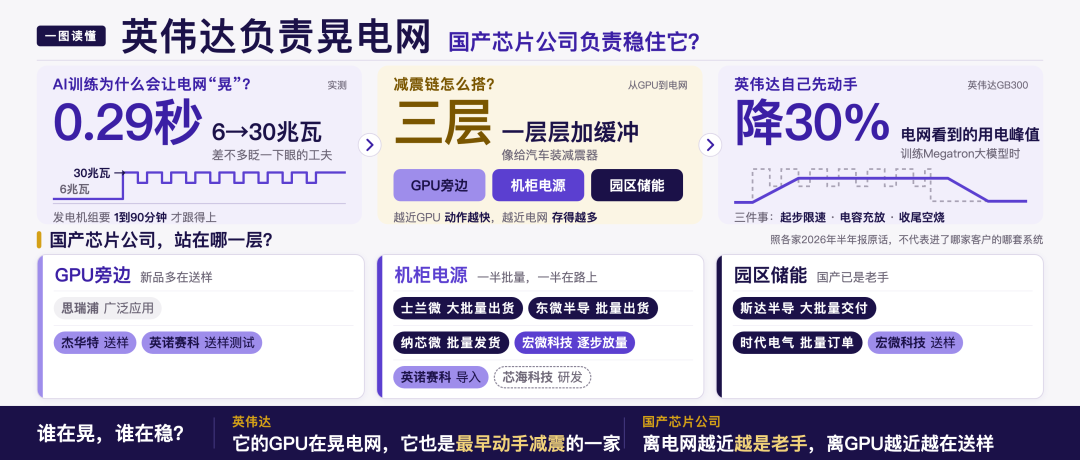
去年 10 月,英伟达在一篇讲 800 伏供电的技术博客里,自己点破了一件事,一座 AI 工厂(英伟达对大型 AI 数据中心的叫法),是一台同步运转的大机器,用电会在几秒钟内上下翻动几百兆瓦,对电网稳定是重大威胁。
这不是夸张。美国一份讲大负荷并网的行业报告里,记着一次实测,一个 50 兆瓦的 AI 训练区块(数据中心里专门跑训练的一片机房),0.29 秒内,用电从 6 兆瓦冲到 30 兆瓦。差不多就是眨一下眼的工夫。
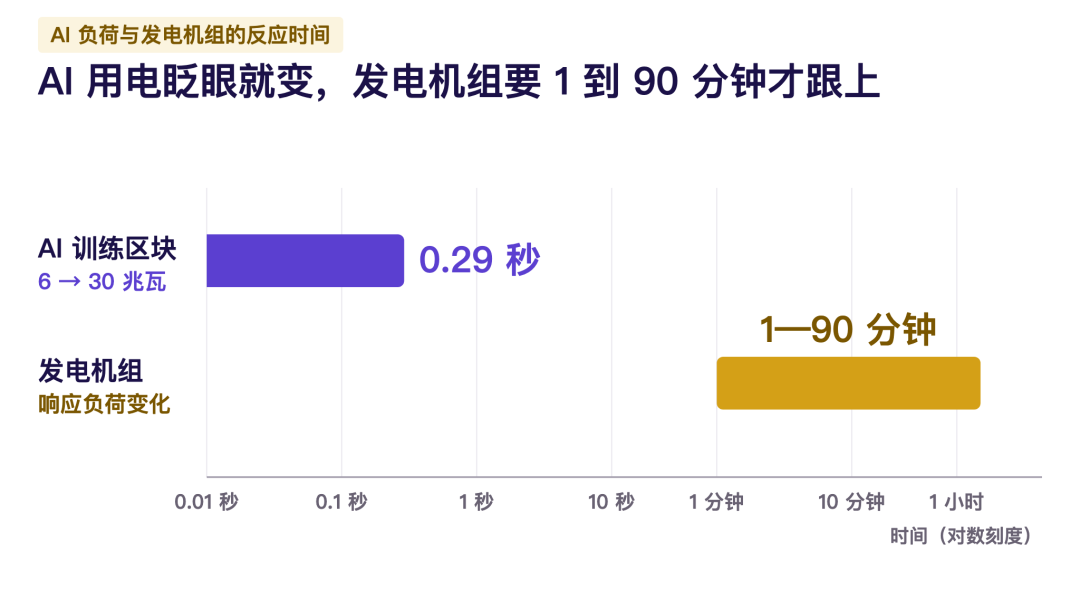
图1:AI 训练区块的用电,0.29 秒从 6 兆瓦冲到 30 兆瓦;发电机组响应负荷变化,要 1 到 90 分钟。实测数据出自 GridLab 2025 年 3 月的大负荷并网报告,这座设施没有经过 UPS(不间断电源)接电网,电网看到的就是它的原始用电;发电机组的响应时间是英伟达的说法。
电网最怕这种“晃”。于是,从 GPU 旁边、机柜里到整个园区,业内开始一层层加缓冲,像给汽车装减震器。英伟达自己,就装了第一道。
这条减震链,每一层都离不开芯片。国产芯片公司,站在哪一层?
1. AI训练为什么会让电网“晃”?
大模型训练,是几万张 GPU 合起来干一件事。
它的节奏很固定:每张卡先各算一小步,算完互相对一遍答案(交换计算结果),再一起算下一步。
·算的时候:GPU 接近满功率;
·对答案的时候:GPU 大多在等数据传输,功率掉到接近空闲。
一张卡这样一高一低,无所谓。麻烦在于,几万张卡的步子完全一致,整座机房的用电就跟着一起一高一低。按英伟达的说法,一台机柜的功率,能在毫秒之间从空闲时的 30% 左右冲到 100%,再落回去。
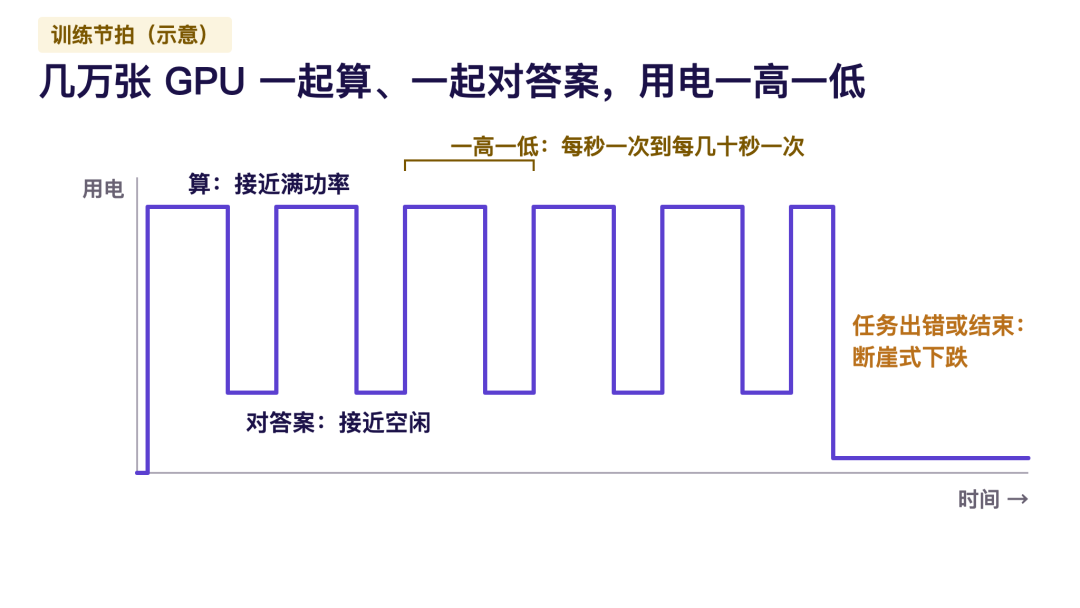
图2:训练时,几万张 GPU 一起算、一起对答案,用电跟着一高一低(示意,不是实测曲线)。任务中途出错或结束时,用电还会断崖式下跌。
微软、OpenAI 和英伟达去年 8 月联合发表的一篇论文,量过这种起伏,任务规模不同,大约每秒一次到每几十秒一次;放大到整座数据中心,起伏能达到几十甚至上百兆瓦。
电网为什么接不住这个节奏?有两个原因。
一是发电机组跟不上。按英伟达的说法,发电机组响应负荷变化,要 1 到 90 分钟(因为传统的发电厂(比如火电、核电)本质上是在“烧开水”,这是一个极其笨重且缓慢的物理过程。发电厂不是一块巨大的电池,按一下开关电就马上出来。它是靠燃烧燃料加热锅炉里的水,产生高压蒸汽,再去吹动巨大的汽轮机叶片旋转来发电的,这种热力学和机械上的物理传导根本快不起来,所以需要 1 到 90 分钟才能慢慢把发电量提上来。同理,如果 AI 突然不用电了,锅炉里刚烧出来的滔天蒸汽也无法瞬间消失,多出来的电就会憋在电网里)。
而 AI 负荷变一次只要零点几秒。训练要是中途出错、突然停下,用电断崖式下跌,发电那头多出来的电一时无处可去。
二是容易共振。汽轮发电机的长轴、整张电网,都有自己的固有晃动频率。上面那篇论文测到,AI 训练的用电起伏,能量主要集中在每秒 0.2 到 3 次之间;而电网和汽轮机轴系的共振频率,从约 0.16 赫兹一直延伸到 60 赫兹以上,正好把这一段包了进去。
这就像一队士兵齐步走过一座桥,步子再轻,只要和桥的节拍对上,桥也会越晃越厉害。

图3:AI 训练的用电起伏,正好落在电网和汽轮机的共振频率范围里。两个频率范围都出自微软、OpenAI 和英伟达 2025 年 8 月的联合论文;横轴是每秒起伏的次数(赫兹),按对数刻度画。
今年 9 月,在美国达拉斯的一场数据中心电力会议上,甲骨文的一位工程师就提醒,这类振荡可能引起机械共振,损伤汽轮机的轴。
所以,同步训练这种用法就是让电网晃的原因。换成谁家的卡都会晃,只是英伟达的 GPU 用得最多,它也是最早出来认账、动手减震的一家。
2. 减震链怎么搭?
英伟达给减震定的目标,是在 GPU 和电网之间做一个低通滤波器,慢的变化放过去,快的抖动挡下来。GPU 那头怎么晃,传到电网这头,都得是平滑的。
这套减震,可以分成三层来看:越靠近 GPU,动作越快,能存的电越少;越靠近电网,存得越多,动作也越慢。
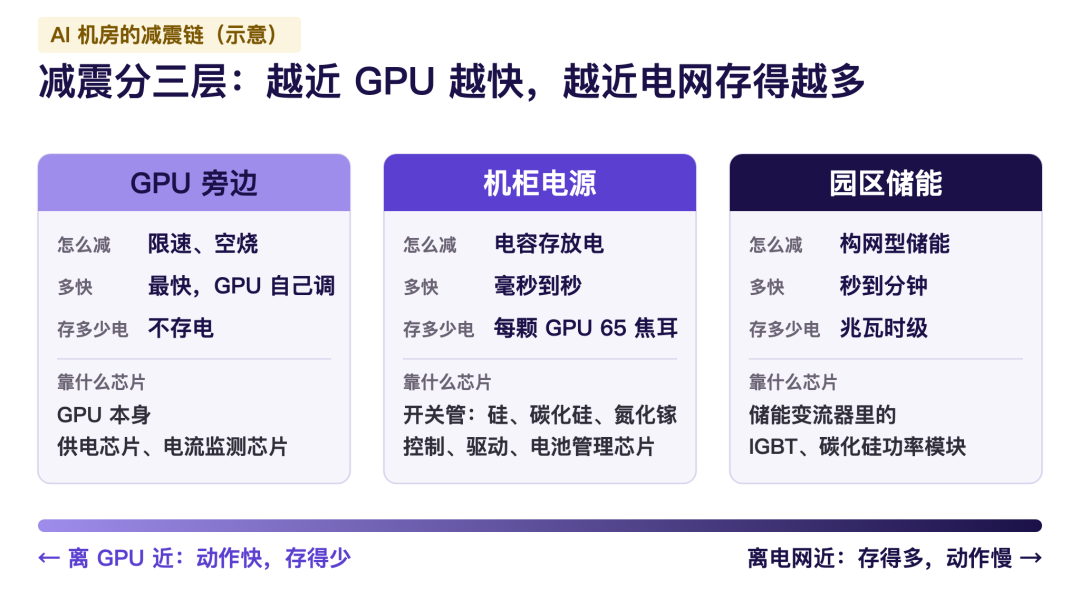
图4:AI 机房的减震链,从 GPU 旁边到园区分三层,每一层靠的芯片不同(示意)。各层的响应时间是大致量级,因方案而异。
第一层,GPU 自己先收着点
最快、也最省设备的办法,是让 GPU 自己别太猛。
英伟达在 GB300 机柜(2025 年推出的一代 AI 服务器机柜)里,加了两个动作:
·起步时限速:任务刚开始,先给 GPU 的功率封个顶,再按电网承受得住的速度,一点点放开;
·收尾时空烧:任务突然停下,GPU 不马上歇着,而是进入专门的空烧模式继续耗电;等不来新任务,再慢慢把功率降下去。
空烧,就是为了让电网平稳,故意浪费一部分电。
浪费多少?上面那篇论文做过仿真,如果给 GPU 设一个最低功率,设在设计功耗的 90%,总能耗要多出 10.5%。而英伟达上一代 GB200 允许设的最低功率,上限正好是 90%。
限速、空烧,靠的是 GPU 自带的功率控制和驱动程序。前提是,它得知道自己每一刻吃了多少电。这些读数,一般来自板子上的供电芯片和电流监测芯片。
第二层,机柜里塞进“蓄水池”
光靠 GPU 收着,总有收不住的时候。第二层,是在机柜的电源里存点电,用电少时充进去,用电多时放出来。
GB300 就这么干了。它的电源架(机柜里集中放电源模块的那几层)里装了电解电容,每颗 GPU 配 65 焦耳,电源里大约一半的体积,都让给了这些电容;再由一个充放电控制器,实时决定什么时候存、什么时候放。
英伟达称,加上这套储能,训练 Megatron 大模型时,电网看到的用电峰值降了 30%。
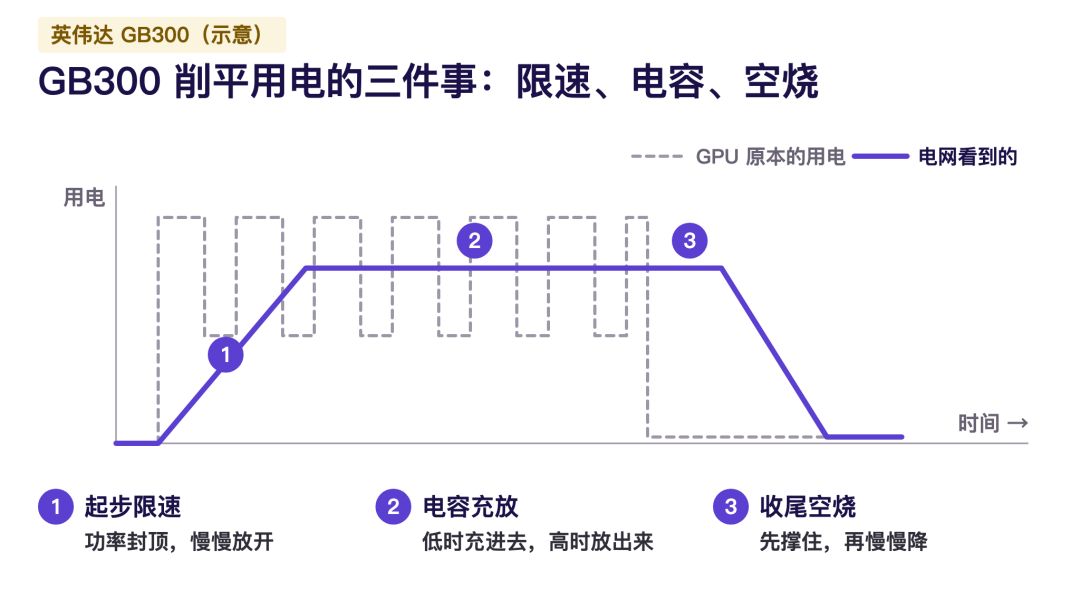
图5:英伟达 GB300 削平用电曲线的三件事:起步限速、电容填谷削峰、收尾空烧(示意,不是实测曲线)。30% 是英伟达公布的训练 Megatron 大模型时的结果。
不过,65 焦耳不多。一颗上千瓦的 GPU 满功率跑,几十毫秒就用完了(按 1000 瓦算,约 65 毫秒)。所以电容只管最快的那些抖动,更长的起伏,要交给第三层。
这一层,芯片干两件事:
·开关:电源里的开关管,负责把电充进去、放出来。除了传统的硅,越来越多用上碳化硅、氮化镓,这两种新一代功率半导体材料更耐高压、开关更快;
·指挥:数字控制芯片和驱动芯片,决定什么时候充、什么时候放、充多少;机柜里的备用电池,还得靠电池管理芯片看着。
第三层,园区里建个“水库”
再往外,是整座园区的储能电站,接在数据中心和电网的接口上。
按英伟达的设计,它管的是更慢、更大的变化,比如整批任务的启动和收尾;万一要切到备用发电机,切换那段时间也靠它托住。
这一层的关键词,是构网型储能。普通储能跟着电网走,电网给什么电压和频率,它就跟着什么;构网型储能反过来,能像一台发电机那样,主动把电压和频率撑住。
它的心脏是储能变流器,也就是把电池的直流电和电网的交流电来回转换的那台设备。里面成排装着的,是 IGBT(一种大功率开关芯片)和碳化硅功率模块。
3. 国内这道题,为什么更难?
国内的智算中心,电越来越多地直接来自风电和光伏。
2024 年 7 月,国家发展改革委等四部门印发《数据中心绿色低碳发展专项行动计划》,要求到 2025 年底,国家枢纽节点(国家规划的几大算力集群所在地)新建数据中心的绿电占比超过 80%。今年,算电协同(把算力和电力放在一起统筹规划)第一次写进了政府工作报告。
据媒体报道,国家能源局 4 月介绍,全国已有 99 个绿电直连项目完成审批,对应新能源装机 3405 万千瓦。所谓绿电直连,就是风电、光伏通过专线直接给用户供电,不绕道大电网。
这让减震更难了,风光发电本来就随天气起伏,AI 负荷又在另一头上下翻动,两头一起晃。
华为今年 5 月发布源网荷储 AIDC 战略(电源、电网、负荷、储能一起规划的 AI 数据中心)时,说的正是这件事:“新能源大规模并网加剧电网波动,叠加AI业务大负荷频繁波动,AIDC面临可靠性挑战。”它给出的方向,是“以电网友好UPS和构网型储能为核心”的供电架构。

图6:直连风电光伏的智算中心,电源那头随天气起伏,负载这头随训练节拍起伏,中间靠储能和电力电子来接(示意)。
做储能的人也这么看。科华数能高级储能解决方案专家林金水,接受《中国能源报》采访时说:“在AIDC场景中,储能主要解决两个问题:一是GPU侧负荷激烈波动对传统电源供给的影响,二是AIDC巨大电量需求如何供给。”
国内还有一招,是让算力跟着风走。据国家能源局网站介绍,新疆伊吾一边“规模化配置储能平抑波动”,一边“引导智算中心将非实时任务,错峰调整到风力充沛时段运行”,“让算力主动追着绿电‘跑’”。
储能系统厂商阳光电源的半年报,也把“AIDC配储”写进了全球储能需求增长的原因。
4. 国产芯片公司,站在哪一层?
按各家 2026 年半年报的原话看,有一条线很清楚:
离 GPU 越近,新品越多还在送样;离电网越近,国产越是老手。
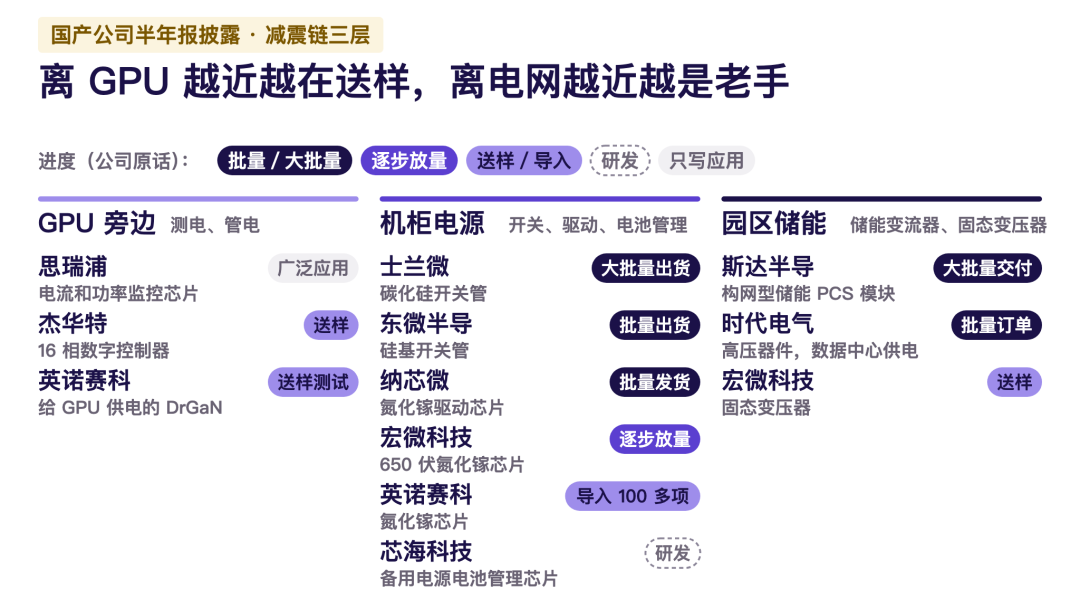
图7:减震链三层里,部分国产芯片公司披露的产品和进度。只表示公司披露的应用和进度,不代表进了哪家客户的哪套系统。
GPU 旁边:测电的已经铺开,管电的还在送样
·思瑞浦的电流和功率监控芯片,半年报称已广泛应用于 AI 服务器等需要实时监控功耗的场景。前面说的限速,靠的就是这一类读数。
·杰华特的 16 相数字控制器、英诺赛科给 GPU 供电的 DrGaN(把驱动和氮化镓开关管封在一起的功率级芯片),都到了头部客户送样这一步。
机柜:一半批量,一半在路上
·已批量:士兰微的碳化硅开关管“应用于AI算力中心电源上,实现大批量出货”;东微半导的硅基开关管在服务器等电源领域“批量出货”;纳芯微面向 AI 服务器电源的氮化镓驱动芯片“已实现批量发货”。
·在路上:宏微科技的 650 伏氮化镓芯片“已通过AIDC电源客户认证”,正在逐步放量;英诺赛科的氮化镓芯片在 20 多家头部云厂商导入了 100 多项;芯海科技面向服务器备用电源的电池管理芯片,还在研发。
园区:国产功率模块已经大批量交付
这一层背后,是中国做大的光伏和储能产业。
·斯达半导称,新一代构网型大型储能 PCS 模块(储能变流器用的功率模块)“已在多家储能头部企业大批量交付”;
·时代电气称,其高压器件“在新型电力系统、数据中心供电领域实现批量订单落地”。
·宏微科技面向固态变压器(用功率芯片和高频小变压器代替传统大变压器的设备)的产品,“已完成送样”。
不过,这些大批量交付多数来自光伏、储能电站;专门配给智算中心的储能用了谁家的模块,各家没有单独披露。
财务体检:老手稳而慢,跑得快的多数还没赚到钱
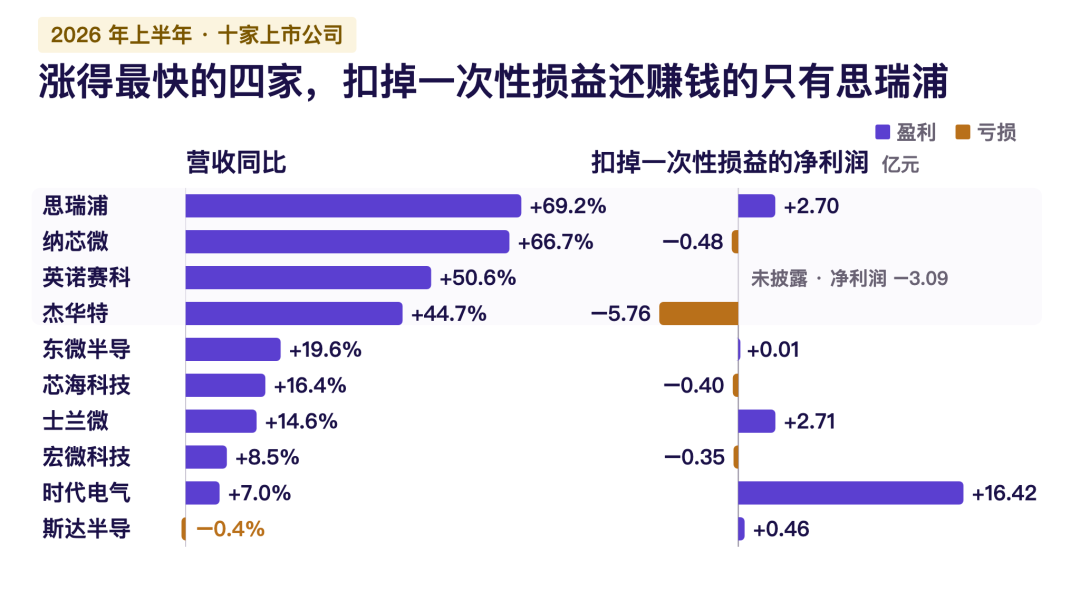
图8:十家公司上半年营收九增一降;扣除投资收益、政府补助这类一次性损益后,五家盈利、四家亏损,英诺赛科没有披露这一项(图中标的是它的净利润)。都是公司整体业绩,不是减震相关业务的业绩。
·营收涨四成以上的四家(思瑞浦、纳芯微、英诺赛科、杰华特),扣掉一次性损益后还赚钱的只有思瑞浦;英诺赛科(港股)不披露这一项,净利润亏损 3.09 亿元。
·园区那层的三家,营收增长都不到一成。 斯达半导营收微降 0.4%,扣掉一次性损益后的净利润降了 82%,公司的解释是原材料涨价、加上上年降过价;时代电气利润小幅增长。
营收涨得快,不等于钱已经赚到手。
5. 结语:谁在晃,谁在稳?
回到标题,答案分两半。
英伟达负责晃电网?只说对了一半。同步训练让电网晃,这笔账算在英伟达头上不冤;但它也是最早动手的一家,限速、空烧、电源里的电容,都是它自己的设计。
国产芯片公司负责稳住它?也只对了一部分。离 GPU 最近的那层,管电的新品大多还在送样;机柜那层,有的已批量出货,有的还在导入、研发;离电网最近的那层,构网型储能里的国产功率模块,已经在大批量地稳。
AI 给电网添了一种新麻烦,负荷会按节拍晃。往后比的,不只是谁的卡算得快,也是谁能让这台大机器,平平稳稳地用电。
参考资料:(上下滑动可查看):