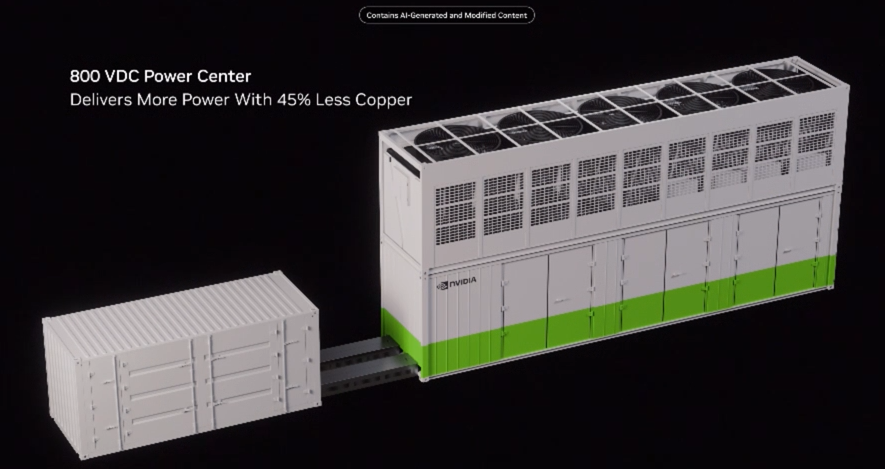
电子发烧友网报道(文/梁浩斌)Vera Rubin全面投入量产!在GTC柏林大会上,英伟达CEO黄仁勋展示了100%液冷的Vera Rubin平台,由包括Vera CPU、Rubin GPU、NVLink 6 交换机、ConnectX-9 SuperNIC、BlueField-4 DPU、Spectrum-6 以太网交换机,以及Groq 3 LPU等多款芯片组成。而伴随Vera Rubin的量产,黄仁勋在现场也详细介绍了全球首款进入量产的CPO产品——Spectrum-X CPO交换机。该CPO交换机集成512个端口,每个端口速度为200Gb每秒,系统带宽高达409.6Tb/s,采用了TSMC的coupe工艺,将硅光子组件直接贴合到芯片上。可以说,Vera Rubin机架、CPO、液冷量产的时间线,在这次发布会后正式尘埃落定。但更加值得关注的,是这次黄仁勋对于AI工厂的建造范式作出的改变。英伟达正在将AI工厂“模块化”,过去需要几个月在现场装配的算力基础设施,如今在供应链里就装好、线接好、烤机跑通,运到现场插上电就能产出token。用他的话说,这是让AI工厂“以光速建成”。“AI是制造业”黄仁勋此前在多个场合已经讲过AI产业的“五层蛋糕”,从上至下分别是能源、芯片与计算机、AI工厂(基础设施)、模型、应用。每一层都在增长,每一层都在创造岗位和公司。“就像电力一样,这是一场新的工业革命,而我们正站在它的最开端。”而这次GTC上,黄仁勋更是给出了一个定义:AI是一个制造业,不只是软件技术。他强调了一个常被跳过的顺序问题:“在模型出现之前,基础设施必须先存在。就像你要有互联网,得先有网络;你要享受电力,得先有通了电的房子和电厂。”模型层也不只是语言模型。在他的描述里,这一层包含语言、生物、化学、物理、机器人动作、动画,以及各种尺寸的模型;再往上是AI原生公司,再往上才是所有终端行业——汽车、制造、医疗、金融。把AI工厂装进集装箱,算力落地从数月到数天基于“AI是制造业”的概念,由此延伸出的逻辑就是,“产能”落地周期每拉长一天,就意味着少了一天的收入。黄仁勋举了一个例子来形容:“一座1GW的数据中心,成本大约500亿美元。你期望它带来的收入是每年约400亿美元。如果晚交付三个月,那就是100亿美元的收入没了。100亿美元,足够让任何人焦虑。”那么英伟达解决这个问题的方式,就是改变过去建造数据中心的范式,将算力机架、线缆打包成模块化的“集装箱”。于是英伟达推出了DSX Pod。DSX Pod以Vera Rubin NVL72为基本单元,7个液冷计算机架加17公里Spectrum-X线缆组成一个Pod;整组在工厂里完成集成、布线和测试,装进可运输的集装箱送到现场。过去需要4到5个月的安装调试,被压缩到大约1个月;现场部署从“数月”变成“数天”。支撑这一切的是Vera Rubin本身:全球第一台“没有线缆、100%液冷”的计算机,装配时间从Blackwell时代的2小时(80%液冷)缩短到5分钟以内;一个NVLink交换托盘把72颗GPU连成一台“巨型GPU”。在黄仁勋的演讲中,一DSX Pod可以看成是六层堆栈。第一层,算力单元:NVL72从“机架”变成“器件”。 基本单元是Vera Rubin NVL72,72颗GPU由一个NVLink交换托盘连成一台“巨型GPU”。第二层,Scale-out网络:可交付的17公里线缆。Pod内机架之间用Spectrum-X以太网互连,一个Pod的累计线缆长度就有17公里。如果按传统方式在客户现场敷设、梳理、端接,17公里就是几个月的工期;而在工厂里,它只是一道标准化工序。第三层,供电:800V直流进架。 演讲给出的关键一句是,高压直流直接进机架,减少转换级数、降低配电损耗。与之配套的是DSX MaxLPS,这是一个端到端的功率控制闭环,把功率按负载需求动态分配,“同样的产出,少用30%的电”。在AI工厂里,功率上限直接等于产能上限,所以这一层省下来的不只是电费,还有算力。第四层,冷却:45℃冷却液配干冷器。闭式液冷回路,冷却液温度可达45℃,这意味着在气候合适的地区可以直接用室外干冷器散热,不需要蒸发水。2GW规模下,每天省下5400万升水,相当于18万户家庭的日用水量。这也降低了数据中心对水源的需求。第五层,外壳:集装箱就是产品形态。Pod在工厂完成集成、全布线、烤机测试与合格化,然后装进可运输的集装箱发运。到现场不再需要组装,而是“卸货、就位、接电、接管”。第六层,数字孪生:先在虚拟世界里建一遍。DSX的起点是Omniverse,PTC把设备设计转成可仿真的资产,达索系统用基于模型的系统工程(MBSE)打通机架与厂房设计,施耐德电气仿真配电与液冷,Jacobs在Omniverse数字孪生里做总装,西门子评估热、噪声与电网影响,Procore负责施工阶段排程。合作伙伴在数字孪生环境中就已经打通应用链路,现场落地一次成型,避免返工。而安装形式,黄仁勋的说法是:场地端只需要电、水、网络与基础承载就绪,干冷器就位,剩下的交给吊装和接管。于是整套算力硬件的部署,从设备出货到产出token,从过去的4到5个月缩短至只需1个月。智能体和物理AI除了算力硬件,智能体以及物理AI也是这次GTC演讲中的重点。“这一年,AI变得有生产力了。”黄仁勋把转折点指向开源智能体,以及随之而来的token消耗暴增:“智能体会思考、推理、迭代、使用工具,因此消耗海量的token。但也正因如此,它们变得有用。”他把智能体拆成五件:模型、harness、沙箱、知识、工具。“智能体必须思考。”他说,大脑负责感知、推理、规划、调用工具,其余部分是我们的外骨骼——它掌管记忆和工具,把工作编排起来。但真正的新东西是安全。“安全和可靠不是一种愿望,它是技术和工程。”于是有了OpenShell:一个开源的智能体安全运行时,Apache 2.0许可,两条命令即可接入;它在系统调用、文件访问、网络连接三个粒度上执行策略,用形式化验证检查每一份策略是否超出权限上限;最外层还有基于BlueField-4、独立于主机的硬件隔离监控域,“一旦智能体打算做不该做的事,毫秒级切断与模型的连接”。关于物理AI,黄仁勋用基站作为切入点:“它不用摄像头、不用扬声器和麦克风,而是用无线电波感知世界,用波束赋形与世界交互。这简直是为AI量身定做的。”他给出的规模是:全球10万个站点、约100GW的分布式基站与数据中心,未来会演化为一张分布式AI网络。而就在上一周,经过近八年的合作,英伟达与诺基亚在T-Mobile网络上打通了第一通“由CUDA完成”的商用通话。“先让CUDA学会打电话,再在上面叠AI。”人形机器人被黄仁勋称作“下一个大型产业”,理由不在能力,而在构型:“机器人难做,是因为任务太分散,每个任务一套构型,技术飞轮就转不起来。手机、PC、NVLink 72之所以进步快,是因为标准构型带来了规模,规模带来了飞轮。”为此英伟达把物理AI拆成三台计算机,训练用的一台、在Omniverse数字孪生里学技能的一台、装进机器人本体的一台。第三台在车上叫Hyperion;在人形机器人上,英伟达与Agile Robots做了一台参考机器人,明年一季度交付。值得一提的是,最近上市的RTX Spark笔记本电脑,在演讲的最后被用于演示怎么投入到AI应用中。“十年前的今天,我把同样的1 PFLOPS、128GB的DGX-1交给了一家叫OpenAI的小公司。唯一的区别是,当年要两个人抬上楼。”而与之对比,今天同样算力的芯片,已经被集成到一台笔记本电脑中。在现场演示里,Hugging Face的一台小机器人在RTX Spark上完成了从建模、材质、物理属性到Isaac Lab里上万台并行训练的全流程,再把策略下回本机。小机器人摇摇晃晃走到舞台中央,并可以根据语音指令完成不同的动作。写在最后从“要两个人抬上楼的DGX-1”,到“一个人托在手上的1 PFLOPS”,十年间算力密度的指数级增长,也让AI基础设施的形态进行了三次变化,从单机、整机柜到今天的集装箱。把4到5个月的算力机柜上线周期压到1个月,AI基础设施的竞争开始从芯片,转向工程落地。谁将AI工厂造的更快、更省电、更早交付,将会成为接下来AI基础设施的竞争护城河。声明:本文由电子发烧友原创,转载请注明以上来源。如需入群交流,请添加微信elecfans999,投稿爆料采访需求,请发邮箱wuzipeng@elecfans.com。更多热点文章阅读点击关注 星标我们将我们设为星标,不错过每一次更新!喜欢就奖励一个“在看”吧!



 喜欢就奖励一个“在看”吧!喜欢就奖励一个“在看”吧!