点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
太长不看版: 借助视觉几何基础模型DA3,MV2GF让跨视角行人检测在未见相机配置下泛化暴涨,MODA最高提升4.7个百分点。
导读
多视角行人检测(MVPD)旨在从多视角图像中以俯视地图的形式检测行人。近年的 MVPD 方法采用统一框架,先将二维图像特征投影到三维世界空间,再将其聚合为单一特征。尽管这些方法有效,却难以泛化到训练时未见的相机配置,原因主要有两点:其一,在未见过的相机配置下,它们难以捕捉准确的跨视角视觉几何;其二,它们让检测模型高度依赖由图像特征投影在训练时产生的畸变模式。为应对这些问题,我们借助视觉几何基础模型并提出 MV2GF。该基础模型在捕捉跨视角视觉几何、在不同相机配置下预测精确三维属性方面展现出很强的泛化能力。MV2GF 将基础模型提取的任务专属特征与通用几何特征相融合,即便在未见相机配置下也能有效捕捉视觉几何。此外,MV2GF 利用基础模型预测的 3D 点图将图像特征中每个像素投影到合适的三维位置,使检测模型不再依赖训练时的畸变模式。我们的实验证明了借助视觉几何基础模型用于 MVPD 的有效性,并且 MV2GF 的泛化优于现有方法。
 ▲ 图1:左为以往 MVPD 方法,依赖透视变换把图像特征投影到同一地面平面,产生阴影式畸变;右为本文 MV2GF,借助预训练的视觉几何基础模型(红色块为可训练模块,蓝色块冻结),用 3D 点图替代透视投影,从根本上规避畸变、提升跨配置泛化。
效果展示
方法好不好,先看跨配置泛化的硬指标。下表在"训练与测试相机配置不同"的严苛设定下,把 MV2GF 与八种主流方法在 GMVD-D、MVPerception、Wildtrack 三个基准上做对比。可以看到 MV2GF 在 MODA(多目标检测准确率,综合漏检与误检的首要指标)上全面领先:在 GMVD-D 测试集上超出此前最优 4.6 个点,在 MVPerception 上超 4.7 个点,在 Wildtrack 上超 2.2 个点。
 ▲ 表1:测试相机配置与训练不同时,MV2GF 与以往方法的对比(所有模型均在 GMVD-D 训练集上训练)。MODA 为首要评价指标,数值越高越好。

引言
行人检测旨在从图像中找出并定位行人,是监控系统、自动驾驶、机器人等诸多应用的关键环节。这些应用常常需要在高度拥挤、杂乱的场景中做检测,而这类场景下遮挡是绕不开的难题,处理不好就会漏检。好在现实部署中,大量应用本来就配备了多路、视场互相重叠的相机,于是学界很自然地把目光投向多视角行人检测(MVPD),希望用多视角信息来对抗遮挡。MVPD 的目标,是从多路相机图像中预测一张俯视(BEV) occupancy 地图来标出行人位置;通过聚合来自不同视角的互补信息,MVPD 比单视角行人检测更鲁棒。
近年的 MVPD 方法大多采用统一的深度学习框架:先为每一路视角提取二维图像特征,再用标定好的相机参数把这些特征投影进三维世界空间,然后基于图像特征中蕴含的跨视角视觉几何信息(比如视角间行人与物体的三维位置关系),把多路投影特征聚合成一个统一的 BEV 特征,最后由这个 BEV 特征预测出 BEV 地图。
这些方法虽然取得了不错的结果,却很难泛化到训练数据里没出现过的相机配置,原因主要有两点。这里的"相机配置"包括相机类型、位姿和位置。第一个问题是,现有方法难以为未见过的相机配置准确捕捉跨视角的视觉几何。要捕捉准,关键是理解二维视角与三维世界空间之间的对应关系;但现有方法只从 MVPD 训练数据里有限的相机配置去学习这种对应。由于二维到三维的对应关系会随着相机配置变化,面对训练时没见过的配置,它们常常连这种对应关系都理解不了,自然也就抓不准视觉几何,导致检测模型无法有效地跨视角聚合特征。第二个问题是,现有方法让检测模型高度依赖训练配置下由图像特征投影产生的畸变规律。它们用透视变换或其衍生变换把二维图像特征投到三维世界空间,这些变换会把所有像素都投到同一平面上,产生一种"阴影式"畸变,把行人像影子一样摊开,从而模糊了 BEV 地图上精确的行人位置,损害检测性能。现有方法从训练配置的畸变规律中学习并隐式补偿,但一旦遇到训练数据之外的配置,往往补偿不到位——因为畸变规律随相机配置剧烈变化,这就阻碍了向未见配置的泛化。
为了破解这两个问题,如图1(b)所示,本文借助一个预训练的视觉几何基础模型(也就是前馈式 3D 重建 Transformer)。它通过 Transformer 在大规模多视角数据集上学到了跨视角视觉几何,在形形色色的相机配置下都展现出很强的泛化能力。因此,利用该基础模型 Transformer 提取出的多视角图像特征(其中包含跨视角的通用几何信息),能帮助检测模型为训练数据之外的相机配置捕捉准确的视觉几何。此外,本文没有用透视变换或其衍生变换,而是改用基础模型预测的 3D 点图(pointmap)来把图像特征投进三维世界空间——点图指明了多视角图像中每个像素在三维世界里的位置,用它来投影就不会把所有像素都投到同一平面,从而规避了阴影式畸变。
基于上述思路,本文提出 MV2GF(Multi-View detection with a Visual Geometric Foundation model)。文中主要选用预训练的 Depth Anything 3(DA3)作为视觉几何基础模型,因为它能在真实度量尺度下预测三维属性、可注入相机参数、且能单次前向处理超过两路视角,这些特性都非常契合 MVPD。为了充分利用 DA3 的多视角图像特征和 3D 点图,本文引入两个核心组件:任务-几何特征融合(Task-specific and Geometric information Fusion, TGF)与特征点图聚合(Feature Pointmap Aggregation, FPA)。TGF 旨在把 DA3 提供的通用几何信息与任务专属信息相融合,生成信息丰富的多视角图像特征:它用一个可训练的 ResNet 为各视角提取多尺度图像特征,同时取冻结的 DA3 Transformer 的多视角图像特征;ResNet 特征经过为 MVPD 端到端训练,包含聚焦行人的任务专属信息,DA3 特征则包含通用几何信息,二者经特征金字塔网络(FPN)融合后得到信息丰富的高分辨率图像特征,既能为未见过的相机配置捕捉跨视角视觉几何,又能突出各视角中的前景行人。FPA 则利用 TGF 的图像特征和 DA3 的 3D 点图来跨视角聚合信息并生成 BEV 特征,同时规避畸变:它先用 3D 点图坐标把图像特征中每个像素投到三维世界中的恰当位置,再用最大池化把落入同一体素的多视角特征聚合成三维体素特征,最后压缩垂直维度得到 BEV 特征,使检测模型不再依赖训练时的畸变规律。
主要贡献
首次将视觉几何基础模型(以 DA3 为例)引入多视角行人检测,利用其在大尺度多视角数据上学到的跨视角几何泛化能力,直接弥补现有方法在"未见相机配置"下抓不准视觉几何的根本短板。 提出任务-几何特征融合模块 TGF:把可训练 ResNet 的任务专属特征与冻结 DA3 Transformer 的通用几何特征在 FPN 中由低分辨率到高分辨率逐步融合,生成既突出前景行人、又富含跨视角几何信息的高分辨率图像特征。 提出特征点图聚合模块 FPA:用 DA3 预测的 3D 点图把每个像素特征投影到三维世界中的正确位置,再经体素最大池化聚合成 BEV 特征,从根本上规避了透视投影带来的阴影式畸变,使检测模型不再死记训练配置下的畸变规律。 在 GMVD-D、MVPerception、Wildtrack 三大基准上做了充分对比与消融,证明借助视觉几何基础模型,MV2GF 的跨配置泛化显著优于以往最优方法(MODA 最高提升 4.7 个点),并揭示了各组件与设计选择的贡献。
方法
一句话核心思路: 别再让检测模型自己从少量训练相机里"硬学"跨视角几何和投影畸变,而是直接请一个在海量多视角数据上预训练好的视觉几何基础模型(DA3)来提供"通用几何地图"和"每个像素的三维坐标",检测模型只管在它的地基上做行人聚合。
(a) 地基:视觉几何基础模型 DA3。 输入是多路视角图像与对应的相机参数(内参与外参),DA3 先用 patch 嵌入把每路图像变成 token,并把相机参数也嵌入成 token,然后经过 L=40 个 Transformer 块(含跨视角与视角内两种注意力)来捕捉跨视角视觉几何,最后从其中第 20、28、34、40 个块的特征预测出每路视角的 3D 点图 Pn,并输出重排后的多视角图像特征 En。点图 Pn 上的每个像素坐标 (u,v) 直接对应它在三维世界里的真实坐标,这正是后续规避畸变的"钥匙"。本文把 DA3 冻结,只训练其余小模块。
(b) 特征融合 TGF(对应图2(b))。 输入是 DA3 的多视角特征与原始多视角图像。TGF 先用可训练的 ResNet 为每路视角提取多尺度特征(聚焦行人的任务专属信息),再把 DA3 四个块的特征双线性插值到与 ResNet 各尺度相同的分辨率,沿通道拼接,最后用 FPN 由低到高逐步融合"任务专属 + 通用几何"两类信息,输出信息丰富的高分辨率图像特征 F′n。这样既保留了行人前景的判别性,又借助 DA3 把跨视角几何"焊"进了特征里,连训练时没见过的相机配置也能对付。
(c) 投影聚合 FPA(对应图2(c))。 输入是 DA3 的 3D 点图与 TGF 的图像特征。FPA 先把图像特征插值到点图分辨率,把 N 路点图和特征分别展平成坐标序列 P˙ 与特征序列 F˙;接着按每个特征向量在三维世界中的真实坐标,把它塞进对应的三维体素网格 V 中,并对落入同一体素的多个视角特征做最大池化,得到体素特征;最后压缩垂直维度并经一个 CNN 得到 BEV 特征 B。由于每个像素都被投到了"它真正在的三维位置",而不是统一拍平到地面平面,阴影式畸变被彻底绕开。检测头再用 sigmoid 从 BEV 特征预测 occupancy 地图与偏移地图,训练时使用 Focal Loss 与 L1 Loss,并加入逐视角的行人头/脚 occupancy 辅助损失。
 ▲ 图2:MV2GF 整体框架。(a) 总览,输入多视角图像与相机参数,经冻结的 DA3 得到几何特征与 3D 点图;(b) TGF 任务-几何特征融合模块;(c) FPA 特征点图聚合模块。红色块为可训练参数,灰色块无训练参数。
笔者理解。 这篇文章最聪明的地方,是把"泛化"这件事从检测模型自己扛,转移到了一个已经证明泛化很强的视觉几何基础模型身上。以往 MVPD 方法用透视变换投影,本质上是把"三维→二维→再投回三维"的几何压缩过程塞进了检测网络去学,而相机一变,这套压缩的畸变规律就全变了,网络自然学不动。MV2GF 用 DA3 的 3D 点图直接给出逐像素的三维坐标,等于跳过了脆弱的"平面投影"假设,把几何对应这件事交给在百万级多视角数据上练出来的大模型,检测网络只需要做"在哪个体素里、哪个行人更该被激活"的聚合决策——任务被拆得更干净,泛化也就顺理成章地好了。工程上值得注意两点:DA3 是冻结的(1.4B 参数不训,只训 23M 参数的小模块),训练成本可控;而点图投影 + 体素最大池化比可变形注意力更"物理正确",也更好解释。唯一的代价是推理变慢(见后文),但方法论上的收益远超这点开销,且消融显示即便换成更轻量的 MapAnything、Pi3X,本方法依然优于所有旧方法,说明"用基础模型打底"是比"选哪个基础模型"更本质的改进。
实验结果
主对比(表1)已经足够震撼:在"训练/测试相机配置不同"的设定下,MV2GF 在 GMVD-D、MVPerception、Wildtrack 三个基准的 MODA 上分别达到 84.8、86.5、87.9,全面压过 MSMVD 等八种强基线,其中相对此前最优的 MODA 提升为 +4.6 / +4.7 / +2.2。更关键的是,即便在"训练与测试配置相同"的 GMVD-S 上(表2),MV2GF 的 MODA(91.3 / 96.5 / 94.7)也以 0.1~0.2 个点的微弱优势超过 MSMVD——说明它不只是"泛化更强",在同源配置上同样不弱。
为了看清 TGF 与 FPA 各自贡献了多少,表3 做了逐组件叠加:以 MVDet + 本文损失为基线(MODA 73.4),仅加 TGF 升到 81.3(+4.4),仅加 FPA 升到 81.3,二者齐上达到 84.8,相对基线累计 +11.4 个点,证明两个模块缺一不可且相互补强。消融还确认:TGF 中 ResNet 与 DA3 特征"都要"比"只用其一"分别高出 +3.5 / +7.3 个点;DA3 特征显著优于替换成 DINOv2 / DINOv3 的通用视觉特征;体素边长 θz 取 50cm 为最优。
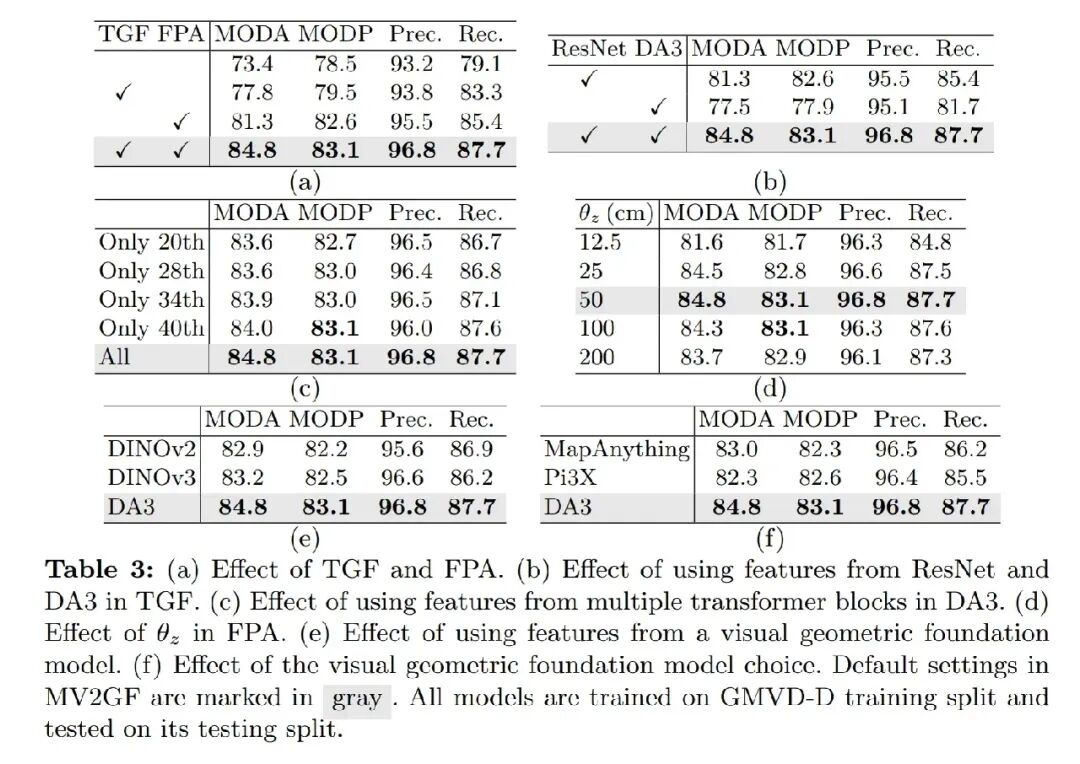 ▲ 表3:消融实验。(a) TGF 与 FPA 逐一叠加带来累计 +11.4 MODA;(b) 同时用 ResNet 与 DA3 特征优于只用其一;(c) 取多个 Transformer 块特征优于单块;(d) 体素边长 θz 的影响;(e)(f) 基础模型选择与特征来源对比。灰色为默认设置。
代价体现在推理速度上。表5 在 6 视角、A100 80GB 上测得的端到端推理速度显示,MV2GF 为 3.3 FPS,而以往方法在 4.5~5.2 FPS 之间,差距约 1.2~1.9 FPS。不过 MVPD 数据集多为 2.0 FPS 的多视角视频,因此 3.3 FPS 仍足以实时处理。
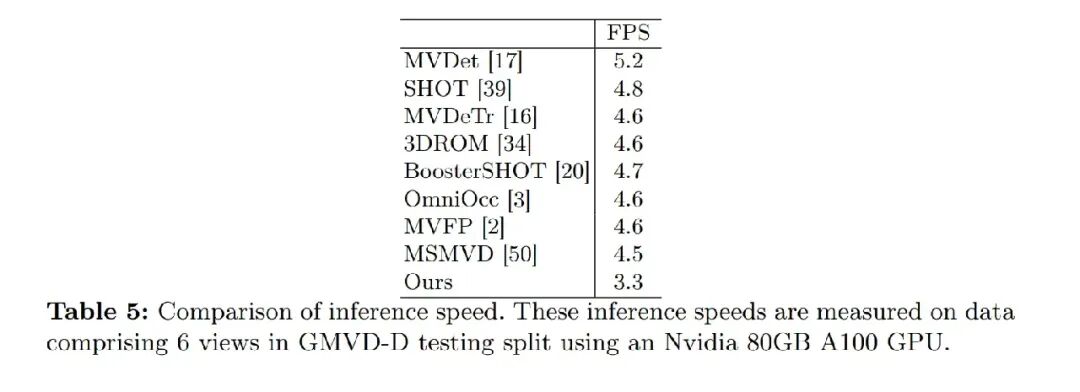 ▲ 表5:推理速度对比(6 视角,Nvidia A100 80GB,含数据加载与预处理)。MV2GF 为 3.3 FPS,略低于以往方法的 4.5–5.2 FPS,但已高于 MVPD 视频常见的 2.0 FPS 需求。
小结:MV2GF 用"视觉几何基础模型打底"这一招,把跨视角行人检测的泛化上限明显抬高了一截——在主指标 MODA 上最高 +4.7 个点、组件累计 +11.4 个点,代价仅是推理略慢约 1~2 FPS,对绝大多数监控/机器人场景完全可接受。
总结 & 未来工作
本文提出一种新的多视角行人检测方法 MV2GF,借助视觉几何基础模型来提升检测模型对训练数据之外相机配置的泛化能力。具体而言,MV2GF 利用了该基础模型提供的多视角特征与 3D 点图:前者包含通用几何信息,能帮助为形形色色(包括训练时未见的)相机配置捕捉跨视角视觉几何;后者把图像特征中每个像素投影到三维世界中的恰当位置,从而规避了以往方法中出现的阴影式畸变。大量实验证明了"为 MVPD 引入视觉几何基础模型"这一思路的优势,MV2GF 的泛化性能显著优于以往方法。希望这项工作能拓宽 MVPD 的应用边界。
需要正视的是,当 MV2GF 在"训练与测试相机配置不同"的数据上训练时(见表1),它比以往方法泛化得更好;但当它面对"与测试配置相同的相机配置"上训练出的旧方法时(见表2),检测性能仍略逊一筹。对部分应用来说,针对特定相机配置优化检测精度依然重要。未来工作中,作者将探索在保持对未见配置泛化能力的同时,进一步提升这类同源配置下检测性能的办法。
此外,借助视觉几何基础模型虽然带来了高泛化性能,却对推理速度有负面影响。作者测得 MV2GF 与以往方法的推理速度差距约为 1.2~1.9 FPS,虽足以处理 MVPD 常见的 2.0 FPS 多视角视频,但仍有优化空间。未来工作中,作者计划通过模型压缩技术(例如知识蒸馏)来有效加速 MV2GF 的推理。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。