点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
UniForge3D由北京大学、Math Magic与香港科技大学合作完成。UniForge3D关注的是一个非常实际但困难的问题:给定少量、无相机位姿的多视图图像,如何生成一个既完整、又忠实保留输入观测几何与外观的3D资产。它的核心不是简单地把多视图图像特征“喂”给3D生成器,而是让多视图重建与原生3D生成在同一个锚点引导共享空间中双向交换信息,并通过生成出的稀疏结构为每个体素选择最有信息量的输入视图,最终实现高保真的细节形状与纹理生成。
 图1 展示 UniForge3D 从稀疏、无位姿多视图图像生成的多组3D资产,包括角色、玩具、雕像、车辆等,用于说明方法在完整性与保真度上的整体效果。
一、问题背景:完整性与保真度为何难以兼得
高质量3D资产是数字内容创作、游戏、增强现实与虚拟现实、具身智能等领域的基础。在许多实际场景中,一个物体只能通过少量图像被观察到,而且相机位姿未知。此时,生成模型需要同时完成两件事:一方面,重建输入图像中已经观测到的几何;另一方面,利用学习到的形状先验补全未见区域。前者要求忠实,后者要求完整,二者天然存在张力。
现有多视图3D生成方法通常把多视图图像特征作为原生3D生成器的条件,例如把图像分配到预定义视图槽位,或自适应融合跨视图特征。这类方法能利用多视图证据,但图像条件并不严格约束生成表面与观测几何一致。生成模型可能偏向其学习先验下“看起来合理”的形状,而忽略输入中特有的结构。另一条思路是先用多视图重建获得隐式特征或显式几何,再条件化生成。然而,上游重建估计中的误差会传播到生成阶段,当几何引导不可靠时,生成保真度反而受限。
更进一步的思路是联合重建与生成。Mix3R 通过 Mixture-of-Transformers 架构连接预训练重建模型与生成模型,使两个任务交换信息、互相促进。但两个分支仍保留不同的坐标表示:重建通常在相机相对空间中预测点图,生成则在规范物体空间中操作,因此需要额外预测相似变换来对齐重建点图与生成几何。这种坐标不匹配阻碍了重建与生成之间的直接几何交互,是第一个挑战。
第二个挑战来自局部细节恢复。同一个3D区域在不同视图中的可见性差异很大:在某些视图中清晰可见,在另一些视图中可能以斜角观察甚至完全遮挡。若把所有视图不加区分地混合,可能把有用几何证据与无关图像内容混在一起,使对应3D位置的细节恢复更加困难。
 图2以三颗蓝莓为例,说明同一3D区域在不同视图中可能清晰可见、以斜角观察或被完全遮挡,从而引出“区域特定视图选择”的必要性。
二、相关工作脉络:从单视图生成到联合重建与生成
单视图3D生成近年来进展迅速,大致可分为基于2D生成先验的方法与原生3D生成方法。前者一类是在预训练2D扩散模型蒸馏监督下优化3D表示;另一类利用图像或视频扩散模型合成物体多视图,再聚合多视图信息恢复3D表示。原生3D生成则直接在大规模3D数据上训练生成模型,当前主要有两条表示路线:Vector Set(VecSet)与 Sparse Voxel。VecSet 把3D形状编码为潜在向量集合,表示紧凑、全局建模有效;Sparse Voxel 保留显式空间组织,更利于局部几何细节。
多视图3D重建方面,经典方法结合 Structure-from-Motion 与多视图立体,学习型方法通过可学习匹配改进深度估计,神经渲染与前馈高斯预测进一步支持重建和新视角合成。近年来的前馈模型可以直接从无位姿图像估计点图等几何量,但其重建主要覆盖观测表面,在未见区域可能不完整。
多视图3D生成主要有两类:免训练方法扩展预训练单视图生成器,通过自适应选择或融合跨视图信息;训练型方法通过特征条件化或自适应视图路由学习利用多视图。它们改善了多视图证据利用,但仅靠图像条件并不能确保生成表面忠实匹配观测几何。将重建与生成结合的工作,有的把估计出的重建特征或几何作为生成条件,有的进一步引入规范化点云;这些引导提供了几何与跨视图信息,但重建误差可能传播。Mix3R 则让两个分支双向交互,却仍保留相机相对重建与规范空间生成,需要额外学习跨空间对齐,复杂化直接几何交互。UniForge3D 的选择是把重建与稀疏结构生成放进共享锚点引导空间,让两个分支拥有统一几何参考,并进一步用结构引导重建识别每个体素的信息视图。
三、方法总览:共享空间中的双向交互与结构引导视图选择
给定稀疏无位姿图像集合 ,目标是生成完整3D资产,并忠实保留每个输入视图中观测到的几何。UniForge3D 将 指定为锚视图,在锚点引导共享物体空间中联合预测多视图点图与完整粗稀疏体素结构。共享坐标系使重建出的3D点可以直接与生成体素关联,因此可以用结构引导重建建立显式像素到体素对应,并为每个体素选择最有信息量的视图;选中视图的图像特征再引导细节形状生成。
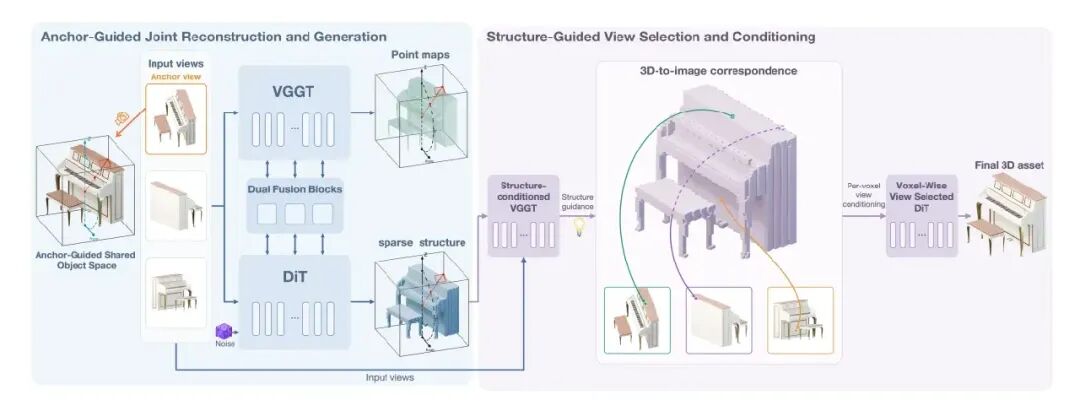 图3展示 UniForge3D 的整体流程:左侧为重建分支与生成分支在锚点引导共享空间中进行双向特征交互,预测多视图点图与完整稀疏结构;右侧为结构条件点图建立体素到像素对应,选择信息视图并用其图像特征引导细节形状生成。
3.1 锚点引导共享物体空间
直接以重建几何或特征条件化生成会传播重建误差;联合训练可以让两个任务互助,但不同坐标系使几何交互复杂:前馈重建在第一相机空间预测几何,原生3D生成在规范物体空间操作。UniForge3D 因此定义共享物体空间:水平朝向跟随锚视图方位角,竖直方向保持规范上方向。对于规范空间中的物体点 ,共享空间坐标为
其中 绕规范竖直轴旋转,使锚视图观察方位成为共享空间的前方向。两个分支的目标都由变换后的几何构造:可见表面点构成重建分支的逐视图点图目标,完整几何体素化后构成生成分支的稀疏结构目标。于是两个分支在同一物体空间中描述几何,无需额外对齐即可交互。
3.2 双向联合建模
重建分支描述输入视图可见表面,生成分支建模完整稀疏结构,二者通过选定层双向交互。设生成 token 为 ,视图 的重建 token 为 。重建到生成的交互中,每个视图的重建 token 与 DINOv3 图像块特征空间对齐;重建特征预测一个残差,加到对应 DINOv3 特征上,形成视图特定条件,并沿序列维度拼接:
生成 token 通过生成分支的交叉注意力层访问 ,从而让多视图几何与语义证据指导稀疏结构生成。生成到重建的交互发生在对应生成块之后:所有视图的重建 token 沿序列拼接,并访问更新后的生成 token:
其中 根据噪声水平门控注入特征。该交互把全局形状上下文注入重建分支,帮助其估计观测像素的3D位置。两个分支联合优化:
由于两个分支都用同一锚点引导空间中的几何监督,它们交换几何信息时不需要额外刚性对齐。
3.3 结构引导重建与像素到体素对应
给定生成出的稀疏体素结构 与输入图像 ,本阶段生成细粒度形状。一个表面区域可能在一个视图中清晰可见,在另一个视图中被遮挡或难以区分。为识别与每个体素相关的观测,UniForge3D 在共享空间中进行结构引导重建。预测点图给出逐像素3D坐标,且与生成体素处于同一坐标系,因此可以建立显式像素到体素对应,并基于有效像素支持选择每个体素最有信息量的视图。
具体地,把生成的稀疏结构 作为重建的额外条件,使网络在估计逐像素3D位置时同时利用图像观测与当前生成几何。将 编码为 token 序列 ,重建网络在选定层通过交叉注意力访问它,输出点图 、置信图 ,以及供后续图像条件化使用的重建特征。预测点与 共享坐标系,因此图像像素与生成体素可以直接关联。
3.4 体素级视图选择与条件化
在共享空间中,利用预测点图建立像素到体素对应。置信度过滤后,把预测点量化到体素网格。对每个以 为中心的体素和每个视图 ,找出映射到该体素的保留像素;定义支持分数 为这些像素在图像上最大连通分量的像素数。分数越大,说明该视图对体素所代表区域提供的视觉信息越多。对每个体素选择
没有直接支持的体素从其 邻域中直接受支持的体素继承视图;若邻域也没有支持,则使用锚视图。对于每个视图,适配器把结构引导重建特征与 DINOv3 图像块 token 对齐,并把对齐特征加到对应 DINOv3 token 上,形成视图特定特征序列。形状去噪器交替使用两类交叉注意力:全局多视图注意力让每个体素 token 访问所有视图沿序列拼接的特征,提供形状补全的全局上下文;体素特定选择视图注意力让每个体素 token 只访问其选中视图 的特征,提供可靠的局部证据。前者负责全局补全,后者负责局部细节保真。
3.5 从细节形状到纹理生成
结构引导形状生成以稀疏结构与多视图图像为输入,通过结构引导重建与体素级视图条件化生成细节网格。稀疏结构既定义形状潜在表示的空间位置,也作为重建网络的几何条件。以该结构为条件,重建网络预测共享空间中的逐视图点图、置信图与多级重建特征,这些输出既提供视图选择所需的几何对应,也提供与图像对齐的形状生成条件。对每个输入视图 ,多级重建特征与 DINOv3 图像特征融合:
其中 是视图 在特征层级 的重建特征, 是对应 DINOv3 图像特征, 是执行多级映射、融合与空间对齐的特征适配器。由此得到的条件既包含稀疏结构引导的重建特征,也包含输入图像提取的视觉特征。生成时,DiT 在多视图注意力与选择视图注意力之间交替:多视图注意力访问所有输入视图特征序列,提供全局上下文;选择视图注意力让每个体素访问其分配视图的完整特征序列 ,因此条件既是体素特定的,又保留对应图像的完整视觉上下文。DiT 在结构定义的稀疏位置上逐步更新噪声形状潜在表示,最后由形状解码器解码为网格。
纹理生成阶段把最终网格编码为形状潜在表示,并与噪声纹理潜在表示在同一稀疏位置拼接,输入纹理 DiT。纹理模型沿用形状阶段的结构引导重建与视图选择方案,但使用独立适配器构造图像条件。生成过程中形状潜在表示保持固定,纹理潜在表示逐步更新;最终潜在表示解码为基础颜色、金属度、粗糙度与不透明度属性,并烘焙为 UV 纹理。
四、训练目标与实现细节
联合模型在32块 NVIDIA A800 GPU 上训练,全局批大小128。生成分支与重建分支分别初始化自预训练 TRELLIS.2 与 VGGT,并使用秩64与秩32的 LoRA 微调,同时完整训练新引入的交互模块。新交互模块的条件残差输出与时间门控投影采用零初始化,DINOv3 保持冻结,峰值学习率为 。为支持无分类器引导,训练时以概率0.1随机丢弃图像条件;后续生成阶段沿用该策略。
联合训练目标结合潜在流匹配与点图监督:
其中 是预测潜在速度与目标潜在速度之间的均方误差。对有效前景像素,令 为点误差, 为预测置信度,则
其中 表示带 分位过滤的稳健平均。 度量三个尺度上点图法线之间的平均余弦误差。
结构引导重建在32块 A800 上训练,每 GPU 动态批最多24张图像;从预训练 VGGT 初始化并全量微调,峰值学习率 ,目标为
训练完成后该网络冻结,为形状与纹理生成提供点图与重建特征。结构引导形状生成分别训练512与1024形状生成器,全局批大小64,初始化自预训练 TRELLIS.2 形状生成器,对去噪器使用秩128 LoRA 微调并完整优化特征适配器,DINOv3 与结构引导重建网络冻结,峰值学习率 ,两阶段均使用预计算形状潜在表示上的潜在流匹配:
纹理生成器同样在32块 A800 上微调,全局批大小64,峰值学习率 ;初始化自此前训练的 TRELLIS.2 纹理模型,优化秩128去噪器 LoRA 参数与完整特征适配器,重建网络、DINOv3 与潜在自编码器冻结。训练时保持形状潜在固定,对纹理潜在施加流匹配。所有阶段使用 AdamW 与余弦学习率衰减;每个训练样本包含四个视图;联合训练中,点图监督仅作用于保留图像条件的样本。
在网络结构上,联合模型由 VGGT 重建分支与 DiT 生成分支组成。重建到生成时,对每个视图 将帧内与跨视图 VGGT 特征拼接为 ,经适配器 映射后加到空间对应的 DINOv3 图像特征 上,再拼接所有视图:
DiT 以生成特征为查询,以 为键和值进行交叉注意力。生成到重建时,把跨视图全局 VGGT 特征拼接为 作为查询,以生成特征 为键和值:
其中 是带时间条件调制与门控的交叉注意力,使重建分支按当前去噪状态接收完整形状信息;更新后的 继续经过重建。重复双向交互后,两个分支分别通过点头与结构解码器输出点图与稀疏结构。结构引导重建中,每个体素中心 经傅里叶位置编码与 MLP 得到结构特征 ,重建特征通过交叉注意力查询这些结构特征:
其中 是所有结构特征序列。该操作插入 VGGT 主干与点解码器,使点图预测同时利用图像观测与完整结构。形状生成时,对每个视图保留置信度最高的 有效前景预测并量化到体素网格;对直接支持的体素按支持分数选择视图,平局时优先锚视图,其次选择所选连通分量内平均置信度更高的视图;无直接支持的体素从 邻域中最强支持体素继承视图,否则使用锚视图。生成时 DiT 交替进行多视图注意力与选择视图注意力,在结构定义的稀疏位置上逐步更新形状潜在表示,最终解码为网格。
五、实验设置与主要结果
训练数据来自 TRELLIS-500K 子集,包含约 K 个物体。每个物体采样两个随机方位角,每个方位角渲染六个候选锚视图;此外从随机采样视点渲染48个视图,为多视图训练提供额外输入视图。评估时从 Toys4K 随机选择500个物体、从 GSO 选择500个物体,共1000个评估物体,全部与训练集分离。每个测试物体从随机选择视点渲染四张图像,所有方法接收相同的四张无位姿 RGB 图像。
外观质量用 PSNR、SSIM、LPIPS 评价;几何用 Chamfer Distance 与 F-score 评价。Chamfer Distance 计算重建表面与真实表面对应采样点之间双向平均最近邻距离之和;F-score 使用 的距离阈值。所有外观与几何指标都在用基于 GICP 的 Sim(3) 变换把重建网格与真实网格对齐后计算。锚点引导联合建模消融中,每个预测稀疏结构先与真实结构对齐,再用 IoU 与 CD 评价 二值表面占用网格。点图重建消融中,所有输入视图的预测与可见真实位置图使用共享的物体级 Umeyama Sim(3) 联合对齐;Accuracy 衡量预测到真实点的平均距离,Completeness 衡量反方向平均距离,Overall 为二者算术平均。视图条件化消融中,PSNR、SSIM、LPIPS 在渲染法线图上计算。
表1 在 Toys4K 与 GSO 上比较 Stream3D + TRELLIS.2、Hunyuan3D-2MV、MV-SAM3D、ReconViaGen v0.2/v0.5 与 Mix3R 等方法,报告 RGB 渲染上的 PSNR、SSIM、LPIPS 以及 Chamfer Distance 与 F-score;最佳结果加粗,次佳结果下划线。UniForge3D 在所列外观与几何指标上均取得最佳结果。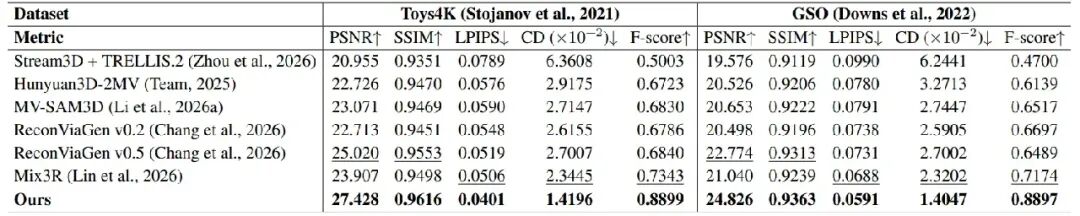

定量上,UniForge3D 在 Toys4K 与 GSO 的所有评估外观和几何指标上均达到最佳。CD 与 F-score 的改进说明几何更准确,PSNR、SSIM、LPIPS 的增益说明新视角下的外观保持更好。定性上,论文在合成基准与真实世界图像上比较不同方法;对比方法常出现部件缺失或局部结构扭曲,而 UniForge3D 更能保留观测到的几何与外观。
 图4在合成基准上与对比方法进行定性比较(文档提及该图但未展示图像),用于说明 UniForge3D 对观测几何与外观的保持能力。
 图5展示真实世界稀疏、无位姿图像上的定性比较,所有结果经过对齐并从共同视角渲染,用于比较不同方法对真实输入细节的保持能力。
六、消融实验:共享空间、结构条件与视图选择各自的价值
锚点引导联合建模消融比较了稀疏结构生成中的条件方案与坐标空间。DINO 条件化把逐视图 DINOv3 特征沿序列拼接,并对锚视图与非锚视图使用不同嵌入。DINO-VGGT 条件化进一步使用 VGGT:先在锚点引导共享空间中微调其点图预测,再冻结;一个带零初始化输出投影的 MLP 适配器把四个 VGGT 层的空间对齐特征融合为残差,加到 DINOv3 特征上再拼接视图。相比 DINO 条件化,它稳定增益,说明重建特征以几何线索与跨视图关系补充了 DINOv3。完整模型“锚点引导联合训练”进一步通过双向特征交互联合优化重建与生成分支,在所有指标上最好,支持联合优化与双向交互的收益。
坐标空间选择也很关键。规范空间联合训练让两个分支都在规范物体空间操作;跨空间联合训练让生成在规范空间、重建仍留在 VGGT 第一相机空间。二者都不如锚点引导共享空间,说明共享坐标参考对直接几何交互的重要性。
表2在 GSO 上消融稀疏结构生成的条件方案与坐标空间,报告 IoU 与 Chamfer Distance,比较 DINO 条件化、DINO-VGGT 条件化、规范空间联合训练、跨空间联合训练与锚点引导联合训练。
重建建模消融使用三种 VGGT 变体。Image-Only VGGT 仅用多视图图像独立端到端微调;Jointly Trained VGGT 在第一阶段通过双向特征交互与稀疏结构生成器联合优化;Structure-Conditioned VGGT 在第二阶段进一步把生成稀疏结构作为点图预测的显式条件。结果显示,联合训练 VGGT 优于仅图像 VGGT,说明与生成分支交互对重建有益;结构条件 VGGT 产生最准确、最完整的点图,说明显式稀疏结构条件对重建的收益。
表3 在GSO上比较Image-Only VGGT、Jointly Trained VGGT与Structure-Conditioned VGGT的点图重建误差,距离以归一化物体坐标的 为单位,报告 Accuracy、Completeness 与 Overall。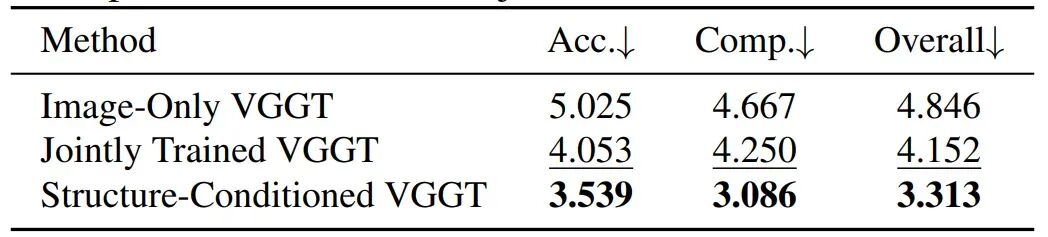
视图条件化消融在相同预测稀疏结构下比较两种细节形状生成策略。Full Multi-View Conditioning 把适配器对齐后的重建特征加到每个视图对应的 DINOv3 图像块 token 上,所有视图特征序列沿序列拼接,并用于条件化每个去噪层。UniForge3D 的体素级视图选择与条件化则交替全多视图层与体素特定选择视图层。结果显示后者改善几何重建性能,说明体素级视图选择与条件化提升了生成形状的保真度。
表4该表在GSO上消融细节形状生成的视图条件策略,两者使用相同预测 稀疏结构,报告渲染法线图上的 PSNR、SSIM、LPIPS 以及 CD 与 F-score,比较全多视图条件化与体素级视图选择条件化。
七、补充结果:点图、视图选择与共享空间一致性
附录进一步给出定性消融与可视化。图6比较不同 VGGT 条件策略:每行一个物体,从左到右为四张输入视图、仅图像 VGGT 预测点图、联合训练 VGGT 点图、结构条件 VGGT(本文)点图,以及真实可见点图。联合训练相对仅图像基线改善几何一致性;显式以生成稀疏3D结构为条件则产生更完整、更连贯的几何。
 图6展示点图重建的定性比较,每行一个物体,从左到右为四张输入视图、仅图像 VGGT、联合训练 VGGT、结构条件 VGGT(本文)预测点图与真实可见点图。
图7补充表4的定性结果:在相同预测稀疏结构下,比较全多视图条件化与本文交替全多视图和选择视图条件化。红色框标出输入图像中的参考细节,黑色框标出生成形状中的对应区域;高亮区域显示本文方法更好地保留局部几何细节,体现引入视图特定视觉证据的收益。
 图7展示体素级视图选择与条件化的定性消融,每行四张输入视图后为全多视图条件化与本文方法生成形状的渲染法线图,红框为输入参考细节,黑框为生成形状对应区域。
图8给出更多渲染3D资产结果:每组左侧为白底四张输入视图,右侧为浅蓝底生成网格渲染;为直接视觉比较,生成网格与真实资产几何对齐,并用与输入相同相机渲染。这些例子说明方法能在不同物体上保留观测几何与外观。
 图8展示更多渲染3D资产的定性结果,每组包含四张白底输入视图与浅蓝底生成网格渲染,生成网格与真实资产几何对齐并使用输入相机渲染。
图9可视化推理结果中的体素级视图选择:每行展示生成稀疏结构(查询体素用洋红色高亮)与四张输入视图;彩色像素与放大插图显示预测的像素到体素对应,数字表示插图中高亮像素数,绿色对勾标识模型选中的视图。像素支持量衡量局部3D区域关联的图像证据量,是视图信息量的实用代理;示例中选中视图更直接暴露查询表面区域,并提供比其它视图更强的像素支持。
 图9可视化体素级视图选择,每行包含高亮查询体素的生成稀疏结构与四张输入视图,彩色像素和放大插图显示像素到体素对应,数字为插图中高亮像素数,绿色对勾为选中视图。
图10与图11分别可视化 Structure-Conditioned VGGT 与 Jointly Trained VGGT 的重建点云与生成网格。所有结果直接来自推理,并在共享模型坐标系中显示,没有物体特定对齐或配准;叠加结果中重建点云与生成网格高度吻合,说明二者确实位于同一空间并直接空间对齐。
 图10展示 Structure-Conditioned VGGT 的共享空间一致性,每行从左到右为重建彩色点云、生成网格及二者直接叠加,未应用物体特定对齐或配准。
 图11展示 Jointly Trained VGGT 的共享空间一致性,每行从左到右为重建彩色点云、生成网格及二者直接叠加,未应用物体特定对齐或配准。
八、局限与结论
UniForge3D 的贡献可以概括为三点:第一,把重建与生成放入同一个锚点引导共享空间,使两个分支无需额外相似变换即可直接交换几何信息;第二,通过结构引导重建建立显式像素到体素对应,并为每个体素选择最有信息量的输入视图;第三,用选中视图特征引导细节形状生成,在补全形状的同时保留观测几何细节。Toys4K 与 GSO 上的定量结果、合成与真实图像的定性比较,以及补充视频,均表明该方法能生成几何与外观更忠实的完整3D资产,并对真实世界图像具有较好的泛化能力。
其局限也很明确:模型主要在合成渲染上训练,严重遮挡、强反射与极端光照仍是挑战。未来工作可以探索用模拟这些困难条件的训练数据提升真实世界鲁棒性。总体而言,UniForge3D 提供了一个有启发性的方向:多视图3D生成不应只是把图像特征交给生成器,而应让重建与生成在统一几何参考下互相校正,并把“看哪个视图”变成由3D结构驱动的局部决策。项目网页为:https://xishuxishu.github.io/uniforge3d-project/。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。